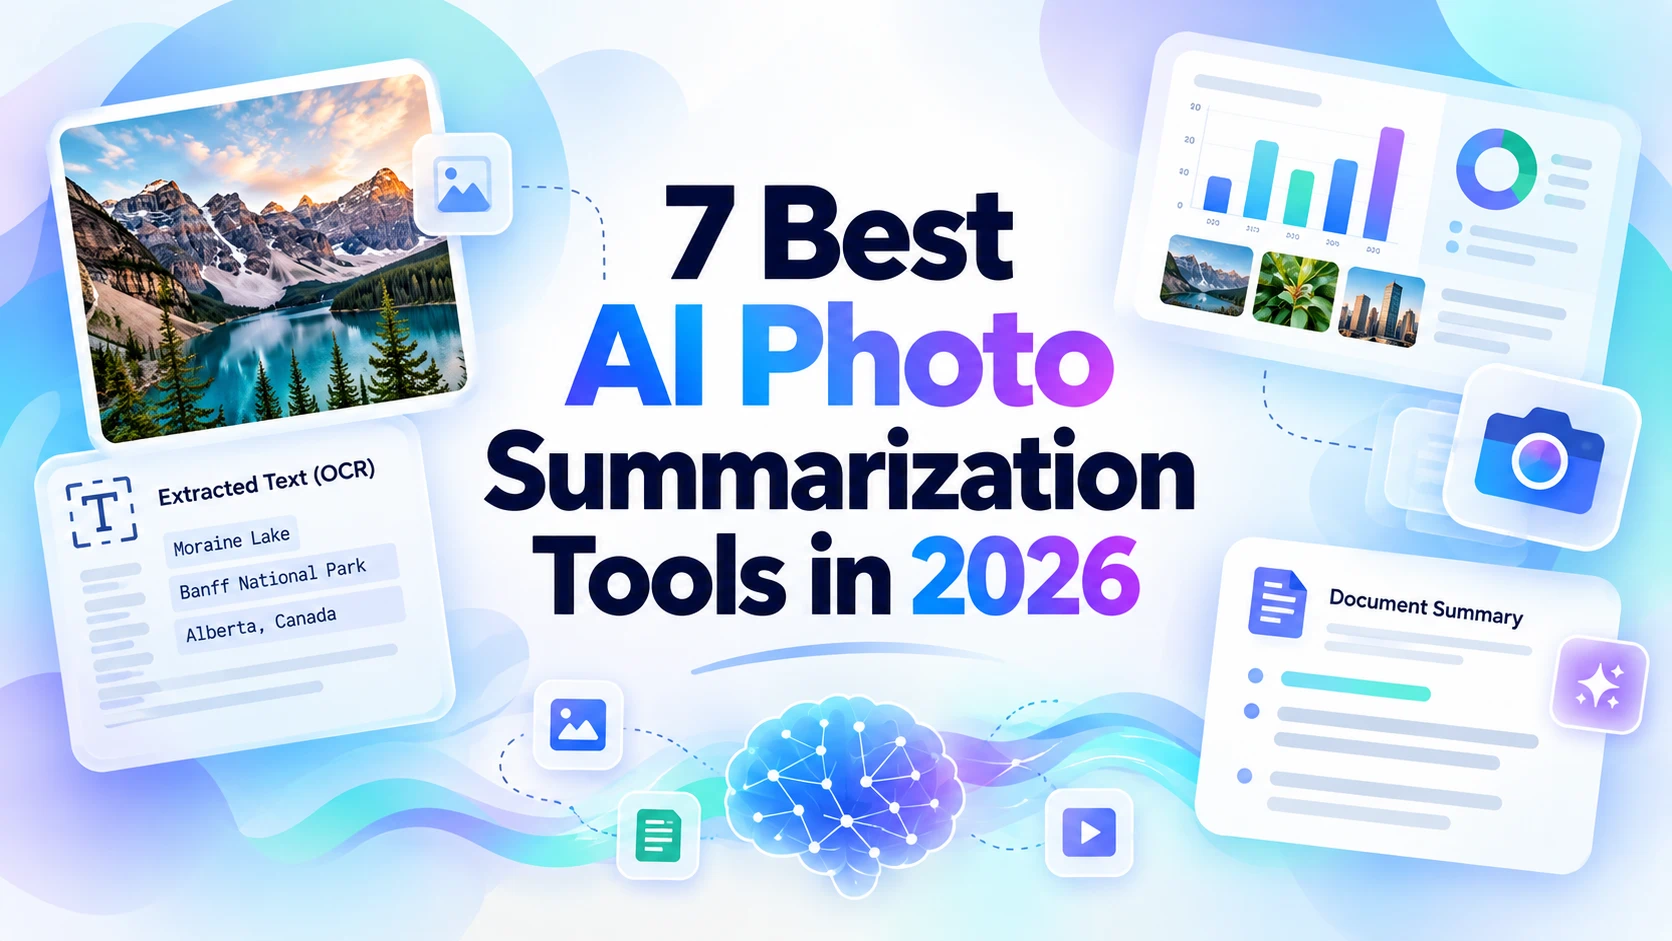
“La synthèse de photos” peut vouloir dire des choses très différentes.
Un étudiant peut vouloir un résumé d’une page de manuel photographiée. Un chef de produit peut avoir besoin du message principal extrait d’une capture d’écran de tableau de bord. Un développeur peut rechercher une API capable de détecter le texte, les objets et les libellés sur des milliers d’images.
Mais ce ne sont pas les mêmes tâches.
Le meilleur outil d’IA pour résumer des photos dépend donc de votre besoin : un résumé en langage naturel lisible, de l’OCR, du raisonnement visuel ou une sortie structurée de vision par ordinateur.
Cette comparaison 2026 sépare ces cas d’usage pour vous aider à choisir le bon type d’outil.
Comparatif rapide
| Outil | Idéal pour | Ce qu’il peut extraire | Type d’utilisateur |
|---|---|---|---|
| iWeaver | Synthèses d’images structurées | Texte, contexte visuel, graphiques, notes | Acteurs du savoir et étudiants |
| ChatGPT | Analyse d’images conversationnelle | Texte, objets, diagrammes, captures d’écran | Utilisateurs généralistes |
| Gemini | Questions-réponses et compréhension visuelle | Photos, texte, contexte visuel | Utilisateurs généralistes |
| Adobe Acrobat AI Assistant | Documents numérisés et images PDF | OCR plus contexte au niveau du document | Utilisateurs très orientés PDF |
| Google Cloud Vision | API OCR et vision par machine | Texte, libellés, objets, monuments | Développeurs |
| Azure AI Vision | OCR, légendes, analyse d’images | Texte, légendes, objets | Développeurs et entreprises |
| Amazon Rekognition | Détection d’images à grande échelle | Libellés, objets, texte, signaux de modération | Développeurs et équipes AWS |
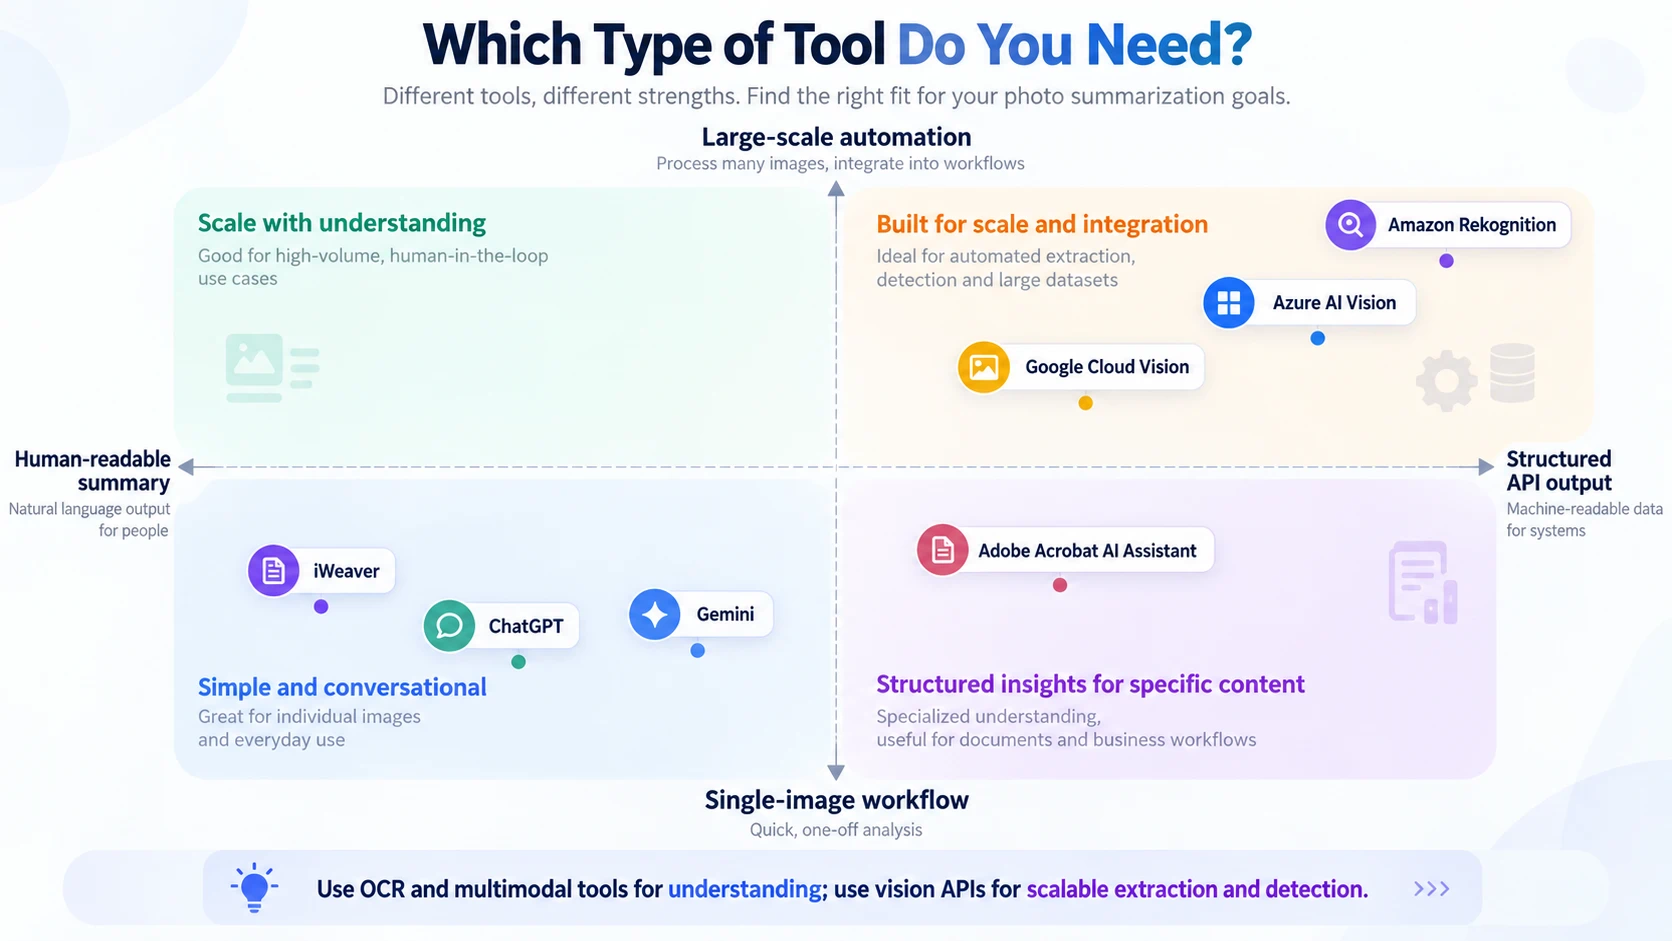
1. iWeaver — Idéal pour des synthèses d’images structurées
iWeaver's AI Image Summarizer est conçu pour les personnes qui veulent comprendre une image, plutôt que simplement détecter ce qu’elle contient.
Vous pouvez l’utiliser avec :
- Captures d’écran
- Graphiques
- Notes visuelles
- Pages numérisées
- Infographies
- Diapositives de présentation
- Images contenant du texte
La différence utile, c’est la structure de sortie. Au lieu de renvoyer uniquement du texte OCR ou des libellés, l’outil peut transformer l’image en points clés, explications, notes ou réponses de suivi.
Cela en fait une option pratique pour la recherche, l’étude, les revues d’activité et les workflows de connaissance.
Choisissez-le quand : vous voulez un résumé lisible que vous pouvez continuer à utiliser.
2. ChatGPT — Idéal pour l’analyse d’images conversationnelle
ChatGPT peut analyser des images téléversées et répondre à des questions sur le contenu visible.
C’est particulièrement utile lorsque le premier résumé mène à d’autres questions.
Par exemple :
Résume ce tableau de bord en cinq puces.
Puis :
Quelle métrique a le plus changé ?
Puis :
Transforme ces résultats en une courte mise à jour pour mon équipe.
La même approche fonctionne avec les diagrammes, les captures d’écran, les documents photographiés et bien d’autres entrées visuelles.
Sa force, c’est la flexibilité plutôt qu’un format fixe de synthèse photo.
Pour les détails à enjeu, vérifiez les chiffres, les libellés et le petit texte par rapport à l’image originale.
Choisissez-le quand : vous voulez discuter d’une image de manière interactive et transformer le résultat en une autre sortie.
3. Gemini — Idéal pour les questions-réponses généralistes sur l’image
Gemini prend en charge les téléversements d’images et peut répondre à des questions sur des photos et du contenu visuel.
Pour un usage quotidien, cela le rend adapté à des tâches comme :
- Expliquer ce qu’affiche une capture d’écran
- Lire du texte depuis une image
- Résumer une page photographiée
- Identifier les éléments visibles
- Comparer plusieurs détails visuels
L’écosystème visuel de Google bénéficie aussi de sa longue expérience avec Lens et la compréhension d’images.
Comme pour tout assistant multimodal, un bon prompt doit séparer l’observation de l’interprétation.
Essayez :
D’abord, listez ce qui est visiblement présent. Ensuite, résumez le message principal. Marquez tout texte que vous ne pouvez pas lire clairement.
Choisissez-le quand : vous avez besoin d’un assistant visuel polyvalent pour une analyse rapide.
4. Adobe Acrobat AI Assistant — Idéal pour les documents numérisés
Un “cliché” est souvent en réalité une page de document capturée sous forme d’image.
Si votre entrée est un PDF numérisé, un rapport, un contrat ou un document archivé, Adobe Acrobat AI Assistant peut être plus adapté qu’un analyseur photo généraliste.
Le workflow combine OCR et contexte documentaire, permettant aux utilisateurs de passer du texte numérisé à des synthèses et des questions, sans découper le fichier en images individuelles.
C’est particulièrement utile quand l’ordre des pages et la structure du document comptent.
Choisissez-le quand : vos images sont principalement des pages contenues dans des PDF.
5. Google Cloud Vision — Idéal pour l’OCR et les API d’images
Google Cloud Vision n’est pas un outil grand public de synthèse. C’est un service de vision par ordinateur destiné aux développeurs.
Il peut détecter du texte imprimé ou manuscrit et renvoyer des informations structurées sur les images, y compris des libellés et d’autres signaux visuels.
Cela le rend utile lorsque vous devez construire votre propre pipeline de synthèse.
Un workflow typique est :
Image → OCR/libellés Cloud Vision → données structurées → modèle de langage → synthèse finale
Cela donne aux développeurs le contrôle de l’extraction, du stockage, des vérifications de confiance et du traitement en aval.
C’est particulièrement pertinent pour l’automatisation à grande échelle, là où un outil de téléversement manuel ne serait pas pratique.
Choisissez-le quand : vous développez une application qui a besoin de comprendre les images via une API.
6. Azure AI Vision — Idéal pour la vision par ordinateur en entreprise
Azure AI Vision fournit des capacités d’OCR et d’analyse d’images pour des environnements de développement orientés Microsoft.
Selon le service et le modèle utilisés, il peut extraire du texte, identifier des éléments visuels et générer des informations descriptives qui peuvent être transmises à un workflow IA plus large.
Pour les équipes en entreprise, la valeur principale est l’intégration. L’analyse d’images peut devenir un composant d’une architecture Azure plus vaste incluant le stockage, la recherche, l’automatisation et les modèles de langage.
Ce n’est pas la même expérience que téléverser une seule capture d’écran et recevoir une synthèse d’étude soignée.
Choisissez-le quand : votre organisation intègre le traitement d’images dans un système basé sur Azure.
7. Amazon Rekognition — Idéal pour les workflows de détection d’images sur AWS
Amazon Rekognition est une autre option orientée développeurs.
Il peut détecter des libellés, des objets, du texte et d’autres signaux visuels sur des images. Les équipes qui utilisent déjà AWS peuvent connecter cette sortie structurée à des bases de données, des systèmes de modération, des pipelines de recherche ou des modèles de langage.
Pour “la synthèse”, Rekognition agit généralement comme couche de perception plutôt que comme couche d’écriture finale.
Cette distinction est importante. Une API de vision par ordinateur peut vous dire qu’une image contient une personne, un vélo, une route et du texte. Un outil de langage multimodal est mieux adapté pour transformer ces observations en explication en langage naturel.
Choisissez-le quand : vous avez besoin d’une analyse d’images scalable dans un workflow AWS.
Synthétiseur d’images vs outil OCR : quelle est la différence ?
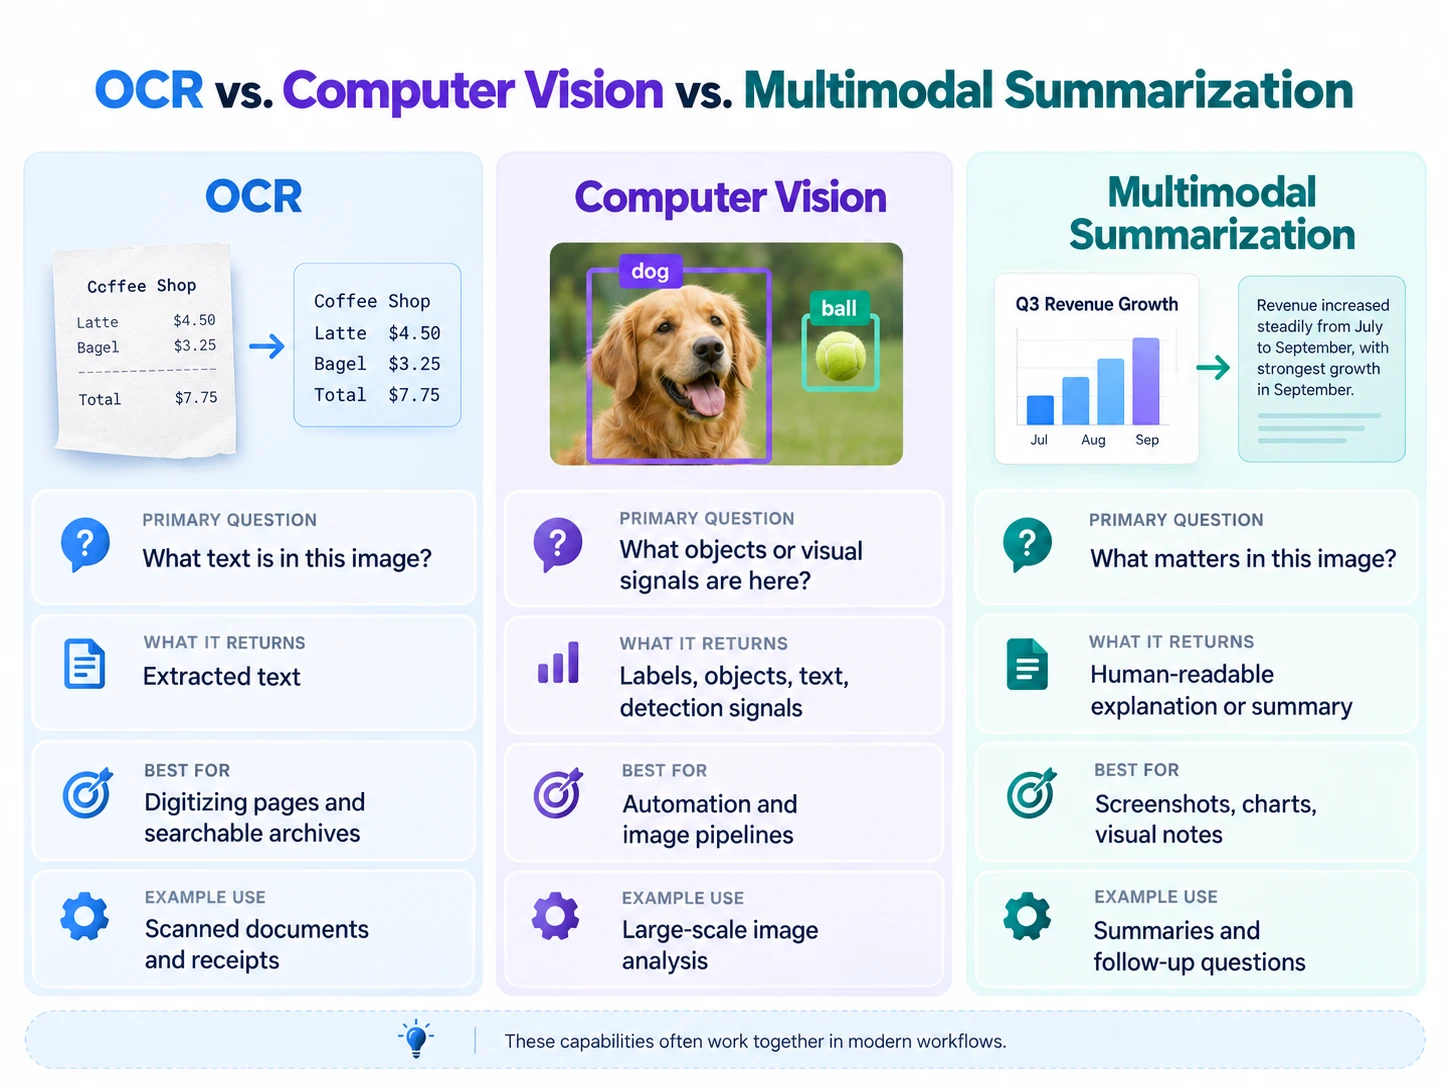
L’OCR répond :
Quel texte se trouve dans cette image ?
Un synthétiseur d’images répond :
Qu’est-ce qui est important dans cette image ?
Un assistant multimodal peut aller plus loin :
Qu’est-ce que l’image implique dans le contexte de ma question ?
Ces capacités se chevauchent, mais elles ne sont pas identiques.
Si vous avez seulement besoin de numériser du texte imprimé, l’OCR peut suffire. Si vous avez besoin d’une explication concise d’une capture d’écran, d’un graphique ou d’une note visuelle, utilisez un outil qui comprend à la fois le texte et la mise en page.
Pour un workflow pas à pas, consultez comment synthétiser du texte depuis une image.
Comment choisir le bon outil
Posez-vous quatre questions.
1. L’information importante est-elle principalement du texte ?
Si oui, privilégiez la qualité de l’OCR.
Pour les documents manuscrits, utilisez un workflow spécialisé de AI Handwriting Recognition ou un autre outil OCR conçu pour l’écriture manuscrite.
2. La mise en page compte-t-elle ?
Pour les graphiques, tableaux de bord, présentations et infographies, l’extraction de texte seule ne suffit pas.
Choisissez un outil multimodal capable de raisonner sur la position, les libellés, les légendes et les relations visuelles.
3. Avez-vous une seule image ou des milliers ?
Pour une analyse manuelle occasionnelle, un synthétiseur conçu pour les utilisateurs est plus simple.
Pour des milliers ou des millions d’images, une API comme Google Cloud Vision, Azure AI Vision ou Amazon Rekognition est plus appropriée.
4. Que devez-vous obtenir après la synthèse ?
Si vous voulez poser des questions de suivi, comparer des images, générer des notes ou transformer les résultats en un autre document, choisissez un outil avec un workflow conversationnel.
Si vous avez seulement besoin de libellés structurés pour un système logiciel, une API peut suffire.
Exemples de prompts pour de meilleures synthèses photo
Pour un tableau de bord :
Résume le tableau de bord en cinq puces. Conserve la plage de dates visible et les valeurs exactes des métriques. Sépare les observations des explications possibles.
Pour une page numérisée :
Extrais le texte, puis résume l’argument principal. Conserve les noms propres, les dates et les citations inchangées. Marque tout texte illisible au lieu d’inventer.
Pour un graphique :
Explique les axes, les groupes, la tendance, les valeurs les plus élevées et les plus basses, ainsi que toute anomalie visible. Ne déduisez pas la causalité à partir d’une corrélation.
Pour un ensemble de captures d’écran :
Résume d’abord chaque capture séparément. Ensuite, identifiez les problèmes récurrents, les différences, et les trois conclusions les plus importantes pour l’ensemble des images.
Des prompts spécifiques réduisent le risque que l’outil se concentre sur des détails visuellement évidents mais peu importants.
La confidentialité compte
Avant de téléverser une image, vérifiez ce qu’elle contient d’autre.
Les captures d’écran peuvent révéler des noms, des adresses e-mail, des tableaux de bord internes, des informations clients, des numéros de compte ou des messages privés.
Recadrez ou masquez les informations qui ne sont pas nécessaires à la tâche, et respectez la politique de gestion des données approuvée par votre organisation pour les images confidentielles.
Le meilleur outil d’IA pour résumer des photos dépend du travail à faire.
Choisissez iWeaver, ChatGPT ou Gemini quand vous voulez une explication lisible et un suivi. Utilisez Adobe lorsque les “photos” sont en réalité des documents numérisés. Choisissez Google Cloud Vision, Azure AI Vision ou Amazon Rekognition lorsque vous intégrez la compréhension d’images dans un logiciel.
La distinction clé est simple : l’OCR extrait le texte, la vision par ordinateur détecte des éléments visuels, et la synthèse multimodale transforme ces signaux en sens.