
Claude Haiku 5.5 est arrivé le 7 octobre 2026, avec un objectif clair : rendre les tâches d’IA fréquentes et étroitement ciblées plus économiques. Anthropic le positionne pour des usages comme la synthèse, la classification et de petites missions au sein de workflows d’agents plus larges. Pour les lecteurs qui traitent de la recherche et des documents, la question utile est de savoir où un modèle rapide peut gérer la préparation de routine tout en laissant l’interprétation difficile à un examen plus approfondi.
La sortie mérite de l’attention, mais son prix annoncé a besoin de contexte. La longueur des prompts modifie le débit de l’API, et le coût par token d’un modèle ne vous dit pas combien coûtera un workflow complet. Voici ce qu’il faut savoir avant de choisir Haiku 5.5 pour votre prochain projet.
Quoi de neuf dans Claude Haiku 5.5 ?
Haiku 5.5 ajoute un effort ajustable à la famille Haiku, offrant aux utilisateurs un moyen de contrôler la profondeur de sa réflexion. La présentation officielle du modèle indique une réflexion adaptative, une fenêtre de contexte d’un million de tokens, des entrées texte et image, et une sortie en texte. Ce sont des capacités du modèle ; une application donnée peut exposer un ensemble plus restreint de contrôles ou d’options d’entrée.
Cette distinction est importante quand on compare des outils. Un modèle peut prendre en charge une grande fenêtre de contexte sans que chaque interface vous permette d’envoyer autant de contenu. De même, comprendre une image ne signifie pas générer une image, et un paramètre d’effort dans l’API ne garantit pas un sélecteur d’effort dans chaque produit destiné aux consommateurs.
Le changement pratique, c’est la flexibilité au sein de la catégorie des petits modèles. Une tâche de tri rapide et une tâche d’extraction soignée d’un document n’ont pas besoin d’instructions identiques ni de la même quantité de raisonnement. Haiku 5.5 donne aux développeurs plus de contrôle sur cet arbitrage, tandis que les utilisateurs du quotidien devraient vérifier quels contrôles leur interface choisie propose réellement.
Tarification de Claude Haiku 5.5 : vérifiez le palier de longueur de prompt
Les tarifs API standards publiés par Anthropic utilisent deux paliers de longueur de prompt. Les chiffres suivants sont en dollars américains par million de tokens et décrivent la tarification de Claude Platform, plutôt que des frais d’abonnement ou ceux d’une application tierce.
| Longueur du prompt | Tokens d’entrée | Tokens de sortie |
|---|---|---|
| Jusqu’à 100 000 tokens | 0,10 $ | 0,50 $ |
| Plus de 100 000 tokens | 0,50 $ | 2,50 $ |
Pour les prompts jusqu’à 100 000 tokens, les tarifs indiqués pour les tokens sont 90 % inférieurs à ceux de Haiku 4.5. Au-delà de ce seuil, la réduction est de 50 %. Anthropic estime aussi séparément une réduction moyenne des coûts d’exploitation d’environ 75 %, en tenant compte de son mix de requêtes précédent et des changements d’utilisation des tokens. Ces pourcentages décrivent des comparaisons différentes et ne doivent pas être utilisés de manière interchangeable.
Pour une illustration simple : une requête avec 20 000 tokens d’entrée et 2 000 tokens de sortie facturables coûte environ 0,003 $ aux taux standards inférieurs. Une requête avec 120 000 tokens d’entrée et la même quantité de sortie facturable coûte environ 0,065 $ aux taux supérieurs. Ces calculs excluent le caching, les remises, les frais liés aux outils et tous les tokens facturables supplémentaires ; ce sont des exemples, pas des estimations des coûts typiques de documents.
À retenir : mesurez la requête complète. Ajouter plus de contexte, conserver une longue conversation ou demander une réponse plus longue peut faire varier la facture. Avant de passer d’un workflow existant, comparez l’utilisation réelle des tokens et la quantité de correction dont le résultat a besoin.
Où Haiku 5.5 se place dans le travail sur les documents
Anthropic identifie les tâches de classification, d’extraction, d’acheminement (routing) et de sous-agent comme des usages visés. Cela suggère un point de départ pratique : confier à Haiku une tâche bornée avec une sortie que vous pouvez inspecter, plutôt que de lui demander de résoudre un projet de recherche entier en une seule réponse.
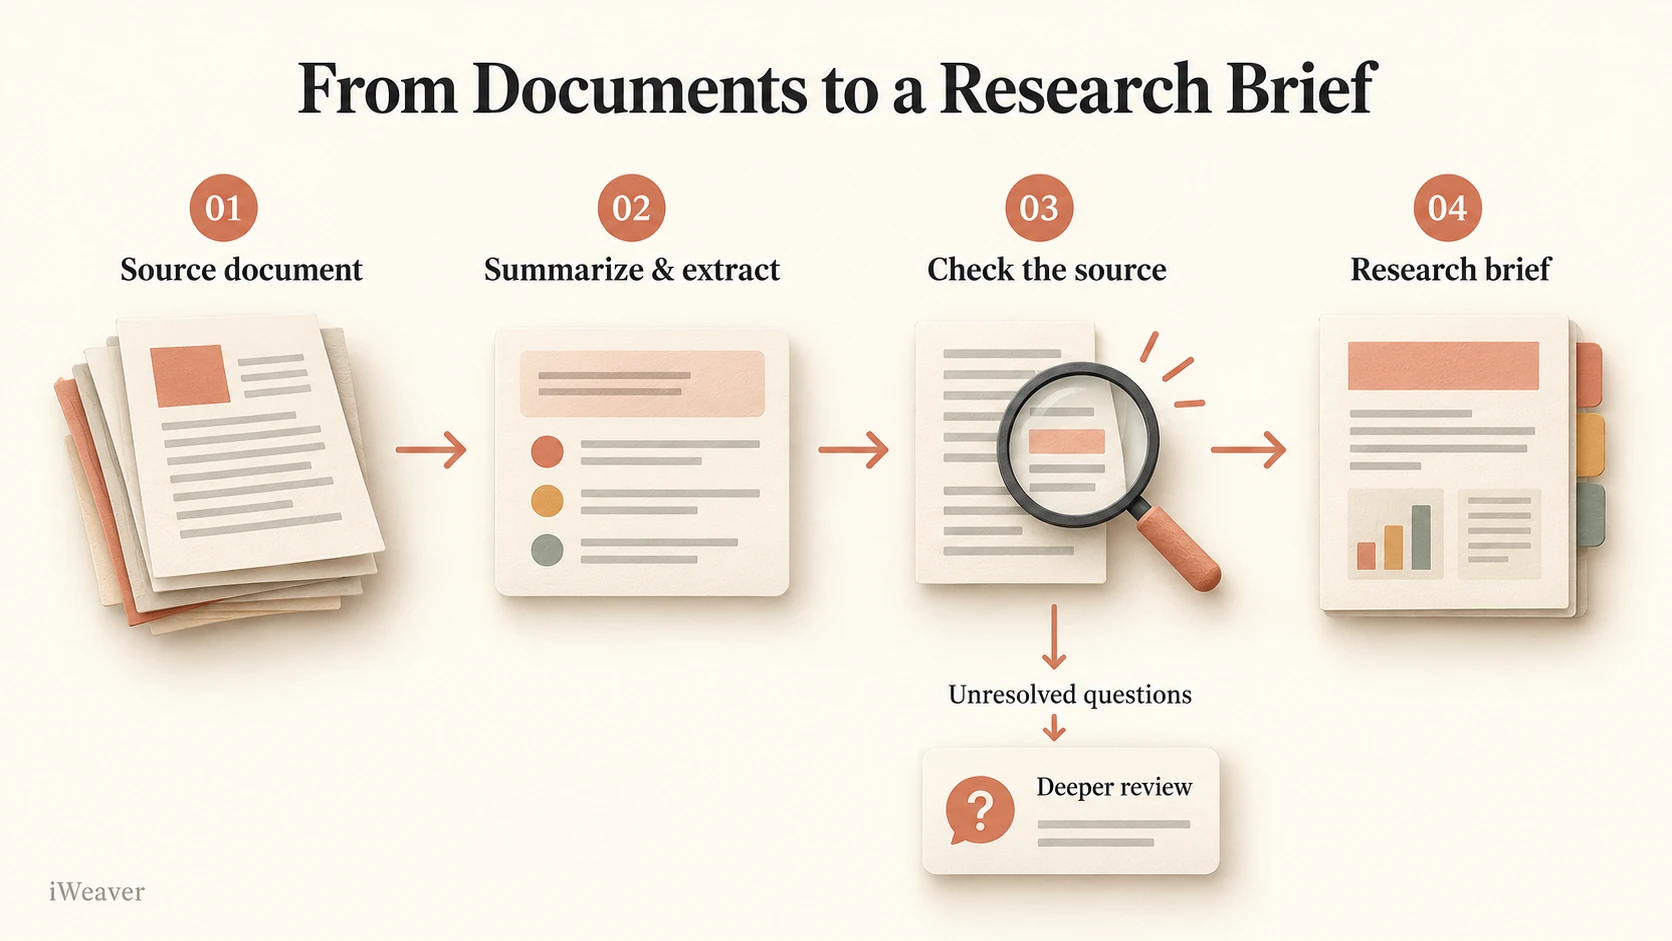
Prenons un dossier de rapports de recherche. La première tâche pourrait consister à identifier le sujet de chaque rapport, sa date de publication et sa question principale. La suivante pourrait être d’extraire les conclusions formulées dans un tableau cohérent. Ce n’est qu’après cette préparation que vous demandez quelles conclusions concordent, en quoi les méthodes diffèrent, et ce qui reste non résolu. Cette proposition de workflow éditorial ne constitue pas une affirmation : nous n’avons pas testé Haiku 5.5 sur ces rapports.
| Tâche | Une sortie utile | Ce qu’il faut vérifier |
|---|---|---|
| Trier le contenu entrant | Des libellés de thème avec des raisons brèves | Documents ambigus et libellés incohérents |
| Préparer un premier résumé | Les affirmations principales et les détails de soutien | Qualifications manquantes et sens modifié |
| Extraire des faits comparables | Un tableau avec les emplacements des sources | Unités, dates, valeurs manquantes et attribution |
| Préparer un transfert (handoff) | Les conclusions, les incertitudes et les questions ouvertes | Si le prochain évaluateur peut retracer la preuve |
Un prompt pour un premier passage axé sur les preuves
Utilisez ce prompt avec un document que vous pouvez inspecter à côté de la réponse. Il demande une aide à la lecture structurée et sépare l’interprétation non étayée de l’extraction.
Lisez le document fourni et préparez une note de recherche.

Utilisez ces sections :
1. Question principale : quel problème le document aborde-t-il ?
2. Résultats clés : identifiez jusqu’à cinq résultats énoncés dans la source.
3. Preuves à l’appui : donnez la section ou la page pour chaque résultat
   lorsque ces informations sont disponibles dans le matériel fourni.
4. Limites : conservez les qualifications de l’auteur et ses réserves.
5. Questions ouvertes : listez les sujets que le document ne résout pas.

N’utilisez que le matériel fourni. Si un détail ou un emplacement de source est
indisponible, indiquez-le. Séparez votre interprétation des affirmations de la source.
Ne créez pas de citations, de statistiques ou de numéros de page.
Après avoir reçu la note, vérifiez quelques résultats par rapport à l’original. Si une déclaration combine des détails provenant de sections différentes, demandez au modèle de les séparer et d’identifier les passages qui les soutiennent. Un résumé bien abouti ne devient utile que lorsqu’il préserve les distinctions dont vous avez besoin pour votre travail.
Quelle quantité d’effort devriez-vous utiliser ?
Les recommandations d’Anthropic en matière de prompts conseillent de commencer par medium, le réglage par défaut sur l’API Claude et dans Claude Code. Elles décrivent high comme adapté au travail de connaissance et aux tâches plus longues, tandis que les niveaux supérieurs doivent justifier leur coût additionnel grâce à l’évaluation. Les recommandations indiquent aussi qu’une réflexion plus longue peut influer sur la longueur des réponses et la consommation de tokens. Pour un workflow documentaire, gardez la source et le prompt fixes tout en comparant les réglages que votre interface prend en charge. Évaluez si la réponse conserve les réserves, respecte le format et identifie les informations manquantes. Choisissez le réglage qui produit un résultat acceptable avec une quantité de relecture raisonnable ; une réponse plus longue, à elle seule, n’établit pas une meilleure qualité.
Quand Sonnet ou Opus peuvent être un meilleur choix
Anthropic continue de recommander Sonnet 5.5 et Opus 5.5 pour les travaux complexes de codage avec agents. Le rôle visé de Haiku inclut des missions plus petites et bien définies, qui peuvent soutenir un workflow plus large. La sortie offre donc aux utilisateurs une option d’acheminement supplémentaire, plutôt que d’établir un modèle comme étant le bon choix pour chaque tâche.
Pour le travail de recherche, la décision doit dépendre de vos propres exemples. Un modèle qui extrait bien des champs peut néanmoins avoir du mal à expliquer des preuves contradictoires. Si la tâche nécessite une interprétation soutenue à travers plusieurs sources, comparez un modèle plus grand sur le même matériel et jugez le travail obtenu, y compris le temps nécessaire pour le corriger. Notre aperçu de Claude Sonnet 5.5 fournit le contexte sur un autre modèle de la famille.
Transformez la sortie du modèle en workflow réutilisable
Choisir un modèle n’est qu’une partie du travail de connaissance. Vous devez aussi garder le matériel source accessible, relire l’interprétation, et organiser les résultats utiles pour la tâche suivante. Les workflows documentaires d’iWeaver incluent des synthèses, des explications et des informations structurées ; son PDF Explainer peut vous aider à traiter les sections difficiles d’un PDF et à demander des explications ou des exemples plus clairs.
Claude Haiku 5.5 est désormais disponible dans iWeaver, et iWeaver propose un essai gratuit du modèle. Commencez par une note de document, une tâche d’extraction ou une question ciblée sur votre matériel source. Relisez la réponse par rapport à l’original avant de la transformer en notes ou en rapport.
Pour votre première évaluation de Haiku 5.5, choisissez une tâche petite et répétable : une note de document, un tableau d’extraction, ou un passage de classification. Définissez ce qu’une réponse acceptable doit inclure, vérifiez-le par rapport à la source, puis notez la quantité de révision nécessaire. Vous obtenez ainsi une base plus utile pour adopter le modèle qu’avec un simple prix annoncé ou un benchmark général.