
Claude Opus 5.5 et la famille OpenAI GPT-6 sont désormais en concurrence pour de nombreuses charges de travail IA exigeantes — mais elles adoptent des approches différentes.
Anthropic positionne Claude Opus 5.5 pour le code agentique sur la durée et le travail de connaissances à vocation professionnelle. OpenAI répartit GPT-6 en trois modèles : Astra pour les tâches bout en bout les plus difficiles, Sol pour le coding complexe et les agents, et Luna pour les charges de travail ciblées à fort volume.
Ainsi, la comparaison utile n’est plus simplement Claude vs GPT.
Elle se résume à :
Claude Opus 5.5 vs GPT-6 Astra, Sol et Luna — quel modèle correspond à votre charge de travail réelle ?
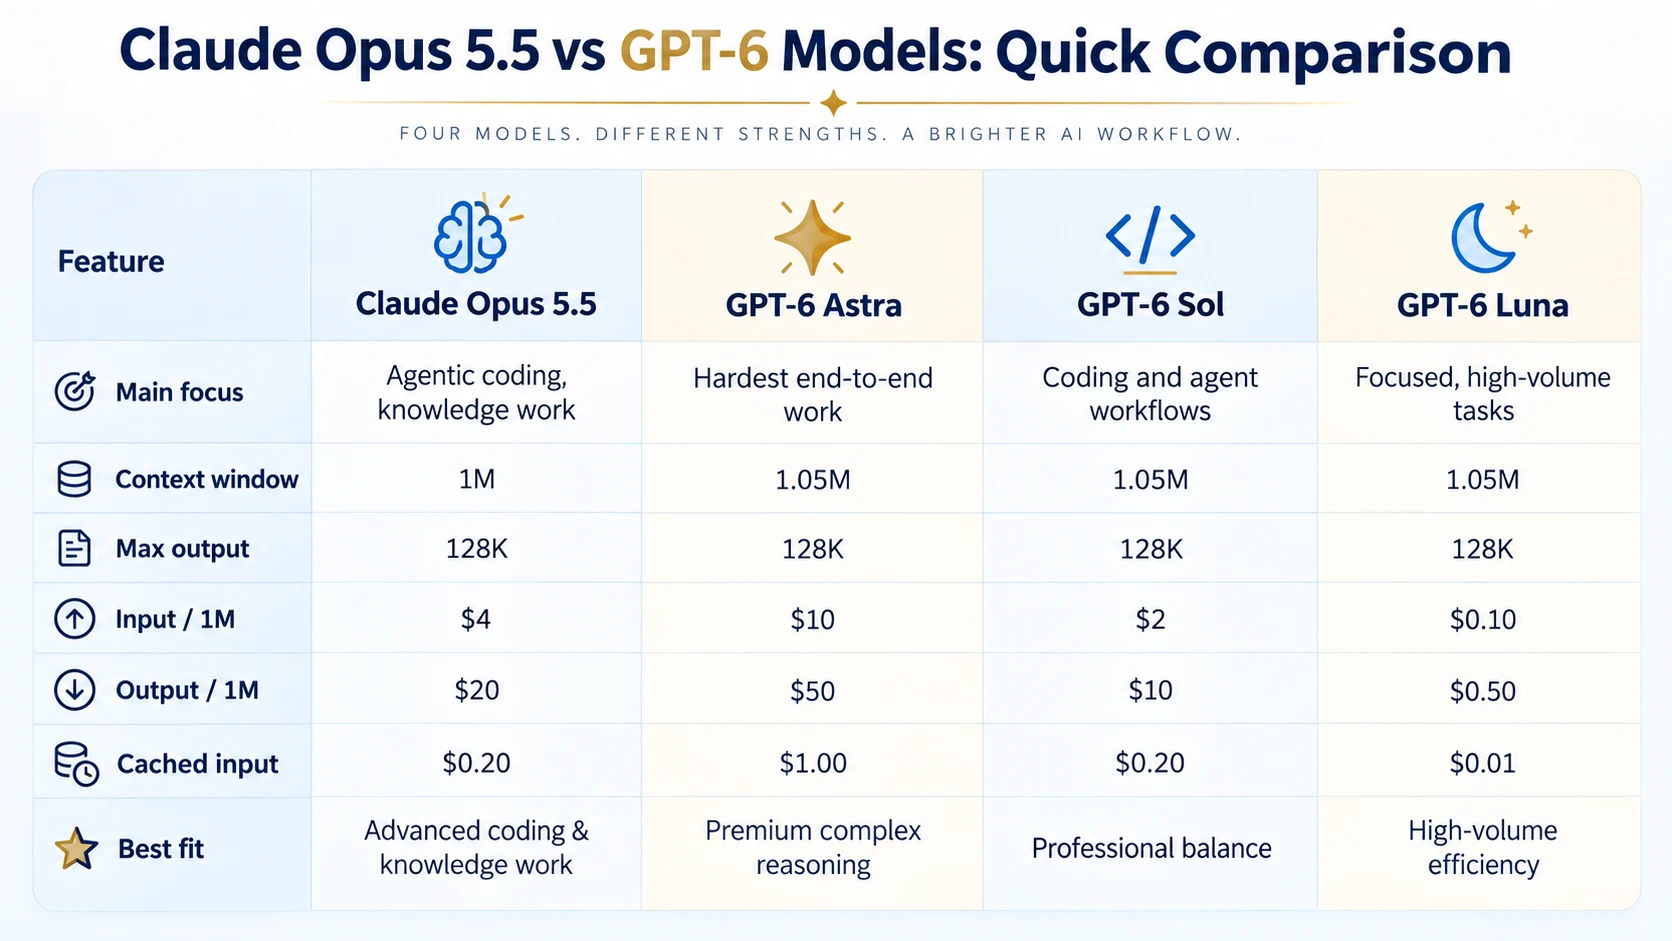
Claude Opus 5.5 vs GPT-6 : aperçu rapide
| Fonctionnalité | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| Objectif principal | Code agentique, travail de connaissances | Travail bout en bout le plus difficile | Codage et workflows d’agents | Tâches ciblées à fort volume |
| Fenêtre de contexte | 1M | 1,05M | 1,05M | 1,05M |
| Sortie max | 128K | 128K | 128K | 128K |
| Entrée / 1M | $4 | $10 | $2 | $0,10 |
| Sortie / 1M | $20 | $50 | $10 | $0,50 |
| Entrée mise en cache | $0,20 | $1,00 | $0,20 | $0,01 |
| Date de coupure des connaissances | Juin 2026 | 30 avr. 2026 | 20 avr. 2026 | 18 mai 2026 |
Claude Opus 5.5 prend en charge une fenêtre de contexte de 1M tokens et une sortie standard de 128K, tandis que les trois modèles GPT-6 offrent une fenêtre de contexte légèrement plus grande de 1,05M, avec la même sortie maximale de 128K.
Claude Opus 5.5 vs GPT-6 Astra
GPT-6 Astra est la comparaison directe la plus proche de Claude Opus 5.5 quand la tâche implique un raisonnement difficile, du code, de la recherche ou des agents fonctionnant sur la durée.
OpenAI décrit Astra comme son modèle le plus performant pour le travail bout en bout le plus difficile, y compris le raisonnement complexe, le codage, l’usage de l’ordinateur, la recherche et la création de documents. Anthropic décrit Opus 5.5 comme un modèle conçu pour le code agentique sur la durée et le travail de connaissances.
La différence pratique la plus importante, c’est le prix.
Claude Opus 5.5 coûte :
- $4 / 1M tokens d’entrée
- $20 / 1M tokens de sortie
GPT-6 Astra coûte :
- $10 / 1M tokens d’entrée
- $50 / 1M tokens de sortie
Aux tarifs indiqués standard, Opus 5.5 revient donc à 60% moins cher par token d’entrée et de sortie que Astra.
Astra propose toutefois une fenêtre de contexte légèrement plus grande — 1,05M contre 1M — mais l’écart reste relativement faible par rapport à la différence de prix.
Que montrent les benchmarks ?
Les résultats publiés par Anthropic pour Opus 5.5 incluent des comparaisons directes avec GPT-6 Astra.
Lors de ses tests, Opus 5.5 obtient un meilleur score sur des benchmarks comme Terminal-Bench 4.0 et FrontierCode v1.1, tandis que GPT-6 Astra obtient de meilleurs résultats sur des tests comme AutomationBench et Terminal-Bench-Science 0.1. Anthropic indique aussi que les écarts de benchmarks doivent être interprétés avec prudence, car les conditions de test et l’incertitude statistique varient.
Il est donc difficile de réduire la comparaison à une seule note globale.
Pour les workflows réels, le meilleur test consiste souvent à savoir si le modèle peut mener à bien de façon fiable votre tâche de codage, de recherche ou d’agent — et combien coûte cette tâche complète.
Claude Opus 5.5 vs GPT-6 Sol
GPT-6 Sol pourrait en fait être l’alternative la plus intéressante à Opus 5.5 pour de nombreux utilisateurs professionnels.
Les deux modèles sont explicitement orientés vers le codage et les workflows agentiques.
Mais leurs prix diffèrent :
| Modèle | Entrée / 1M | Sortie / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
GPT-6 Sol coûte deux fois moins cher par token d’entrée et de sortie standard.
Il offre aussi une fenêtre de contexte de 1,05M contre 1M pour Opus 5.5. Les deux prennent en charge jusqu’à 128K tokens de sortie.
Cela fait de Sol une option intéressante pour des charges de travail fréquentes comme :
- Le codage quotidien
- La revue de code
- Les agents IA
- Les workflows basés sur des outils
- La recherche
- L’analyse de documents
- L’automatisation des activités
Opus 5.5 devient plus intéressant quand vous recherchez le raisonnement de la catégorie Opus chez Anthropic, ainsi que sa focalisation sur les tâches agentiques sur la durée, tandis que Sol est positionné comme une option plus soucieuse des coûts pour les tâches de codage et d’agents récurrentes.
Claude Opus 5.5 vs GPT-6 Luna
Claude Opus 5.5 et GPT-6 Luna visent des charges de travail très différentes.
Luna est le modèle GPT-6 le plus efficace d’OpenAI pour les tâches ciblées à fort volume. Son tarification API est uniquement :
- $0,10 / 1M tokens d’entrée
- $0,50 / 1M tokens de sortie
C’est très inférieur aux $4 / $20 d’Opus 5.5.
Luna convient davantage à des tâches comme :
- La classification
- L’extraction d’informations
- La mise en forme
- Les résumés courts
- Le traitement de contenu
- L’automatisation répétitive
Opus 5.5 vise au contraire l’extrémité opposée du spectre de charge de travail : le codage complexe, un travail de connaissances plus profond, et des tâches qui peuvent nécessiter un raisonnement soutenu sur de nombreuses étapes.
Ainsi, ce n’est pas vraiment un duel direct entre modèles : c’est plutôt une question de savoir si une tâche a besoin, ou non, d’un modèle de raisonnement avancé.
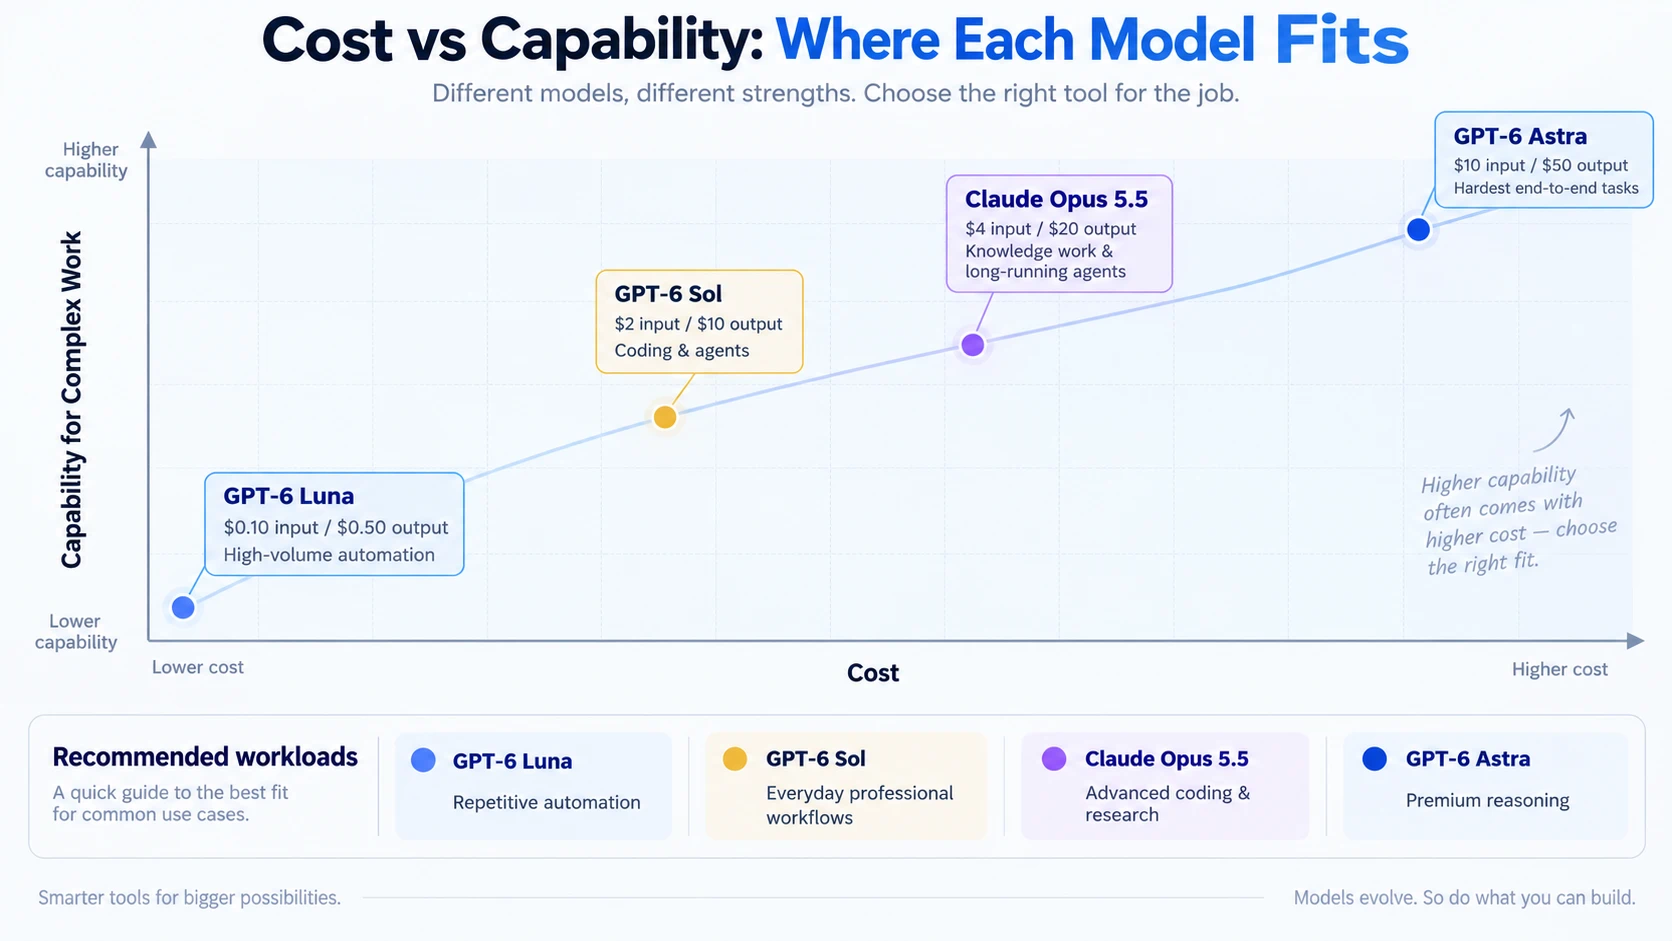
Tarification : où se situe chaque modèle ?
L’échelle des prix rend le positionnement particulièrement clair.
| Modèle | Entrée | Sortie | Position relative |
|---|---|---|---|
| GPT-6 Luna | $0,10 | $0,50 | Efficacité à fort volume |
| GPT-6 Sol | $2 | $10 | Équilibre professionnel |
| Claude Opus 5.5 | $4 | $20 | Codage avancé & travail de connaissances |
| GPT-6 Astra | $10 | $50 | Raisonnement bout en bout premium |
Il s’agit de prix standards indiqués pour les tokens. OpenAI applique une tarification plus élevée aux requêtes GPT-6 contenant plus de 272K tokens d’entrée : de très longues charges en contexte peuvent donc modifier le calcul des coûts.
Anthropic prend aussi en charge le prompt caching sur Opus 5.5 à $0,20 par million de tokens cache-read, ce qui peut compter pour les agents qui réutilisent souvent de grands contextes.
Quel modèle correspond à quelle tâche ?
Une façon concrète de comparer les quatre modèles consiste à le faire par charge de travail plutôt que par marque.
| Tâche | Modèles à tester |
|---|---|
| Raisonnement bout en bout difficile | Claude Opus 5.5 / GPT-6 Astra |
| Grands projets de codage | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Agents sur la durée | Claude Opus 5.5 / GPT-6 Sol / Astra |
| Codage professionnel au quotidien | GPT-6 Sol / Claude Opus 5.5 |
| Recherche et travail de connaissances | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Extraction à fort volume | GPT-6 Luna |
| Classification et mise en forme | GPT-6 Luna |
| Automatisation répétitive | GPT-6 Luna / Sol |
Il n’y a aucune raison pour que chaque étape d’un workflow doive utiliser le même modèle.
Un agent en production pourrait utiliser Luna pour une extraction légère, Sol pour des étapes de raisonnement régulières, puis orienter les tâches particulièrement difficiles vers Astra ou Opus 5.5.
Et cela peut avoir plus d’impact sur les coûts que le choix d’un seul modèle pour tout.
Testez Claude Opus 5.5 et la série GPT-6 sur iWeaver
Les spécifications et les benchmarks sont utiles, mais ils ne prédisent pas toujours quel modèle fonctionnera le mieux avec vos documents, vos prompts ou votre workflow.
iWeaver vous permet d’essayer Claude Opus 5.5 aux côtés de la série GPT-6, y compris GPT-6 Astra, Sol et Luna, sans construire des intégrations API séparées.
iWeaver fournit aussi des crédits quotidiens gratuits, ce qui vous permet de tester la même tâche réelle sur différents modèles — par exemple :
- Résumer des PDF
- Comparer plusieurs documents
- Recherche et analyse
- Rédaction
- Extraction de connaissances
- Questions de codage
Faire exécuter la même tâche par plusieurs modèles facilite beaucoup la comparaison de la profondeur de réponse, de la vitesse et de l’utilité, plutôt que de s’appuyer uniquement sur des chiffres de benchmark.
Si vous souhaitez démarrer spécifiquement avec le modèle phare d’OpenAI, consultez notre guide sur comment utiliser GPT-6 Astra gratuitement.
Claude Opus 5.5 occupe une position intéressante sur le marché actuel des modèles de pointe.
Il coûte nettement moins cher que GPT-6 Astra tout en ciblant des cas d’usage similaires exigeants pour le codage, les agents et le travail de connaissances. GPT-6 Sol réduit le coût par rapport à Opus 5.5 et se concentre fortement sur le codage et les agents, tandis que GPT-6 Luna répond à un besoin entièrement différent : un traitement économique à grande échelle.
La question utile n’est donc pas seulement « Claude Opus 5.5 ou GPT-6 ? »
Il s’agit de savoir si votre tâche a besoin d’un raisonnement de niveau phare, de performances professionnelles équilibrées, ou d’une efficacité à fort volume.
Pour cette raison, tester le même workflow sur Opus 5.5, Astra, Sol et Luna est souvent plus instructif que de choisir uniquement à partir de tableaux de benchmarks.