
Claude Sonnet 5.5 et Claude Opus 5.5 se distinguent moins par une simple hiérarchie « bon contre mieux » que par la nature de la tâche. Anthropic présente Sonnet comme le choix plus rapide et moins coûteux pour un travail quotidien bien cadré, tandis qu’Opus est conçu pour des problèmes complexes et ouverts, qui exigent un jugement attentif sur de nombreuses étapes. Sonnet coûte deux fois moins cher par jeton d’entrée et de sortie standard, et pourtant il se rapproche étonnamment d’Opus dans plusieurs évaluations publiées.
Un benchmark peut montrer si un modèle a réussi dans un cadre contrôlé, mais il peut ne pas refléter à quel point le modèle gère de manière fiable l’ambiguïté ou garde en vue des contraintes concurrentes pendant un projet long. Choisir entre les deux revient à décider du routage : utilisez le modèle le moins coûteux qui répond aux exigences de qualité et de risque de la tâche.
Sonnet 5.5 vs Opus 5.5 : aperçu rapide
| Détail | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Date de sortie | 28 septembre 2026 | 22 septembre 2026 |
| Prix d’entrée standard | 2 $ pour 1M de jetons | 4 $ pour 1M de jetons |
| Prix de sortie standard | 10 $ pour 1M de jetons | 20 $ pour 1M de jetons |
| Prix de lecture du cache | 0,20 $ pour 1M de jetons | 0,20 $ pour 1M de jetons |
| Prix d’écriture du cache | 2,50 $ pour 1M de jetons | 5 $ pour 1M de jetons |
| Rôle indiqué | Travail quotidien rapide et bien cadré | Travail complexe nécessitant un jugement soutenu |
| Nom du modèle API | claude-sonnet-5-5 |
claude-opus-5-5 |
Les chiffres ci-dessus proviennent des annonces officielles d’Anthropic pour Sonnet 5.5 et Opus 5.5. Il s’agit de tarifs API standards ; le mode rapide, l’inférence régionale, les plateformes cloud et l’accès via abonnement peuvent suivre des règles de tarification ou d’utilisation différentes.
Ce que les benchmarks montrent réellement
Sonnet 5.5 se rapproche d’Opus 5.5 sur plusieurs évaluations rapportées par Anthropic, mais l’avantage change selon la tâche. C’est précisément pourquoi il ne faut pas réduire ces deux modèles à un score unique.
| Benchmark | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70,6 % | 66,4 % |
| FrontierCode 1.1 Main | 46,2 % au Max | 54,4 % |
| CursorBench 4.0 | 55,5 % | 57,8 % |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
Sonnet est en tête sur le résultat publié de Terminal-Bench, tandis qu’Opus mène sur FrontierCode, CursorBench, GDPval-AA et AA-Briefcase. Le faible écart de GDPval-AA est notable, mais Anthropic indique explicitement qu’Opus reste clairement plus fort, d’après l’expérience de ses tests internes et ceux de testeurs externes, sur un travail complexe et ouvert qui exige un jugement soutenu. Les configurations de benchmark et les paramètres d’effort diffèrent également : un écart numérique de deux points ne doit donc pas être interprété comme un verdict complet sur les capacités.
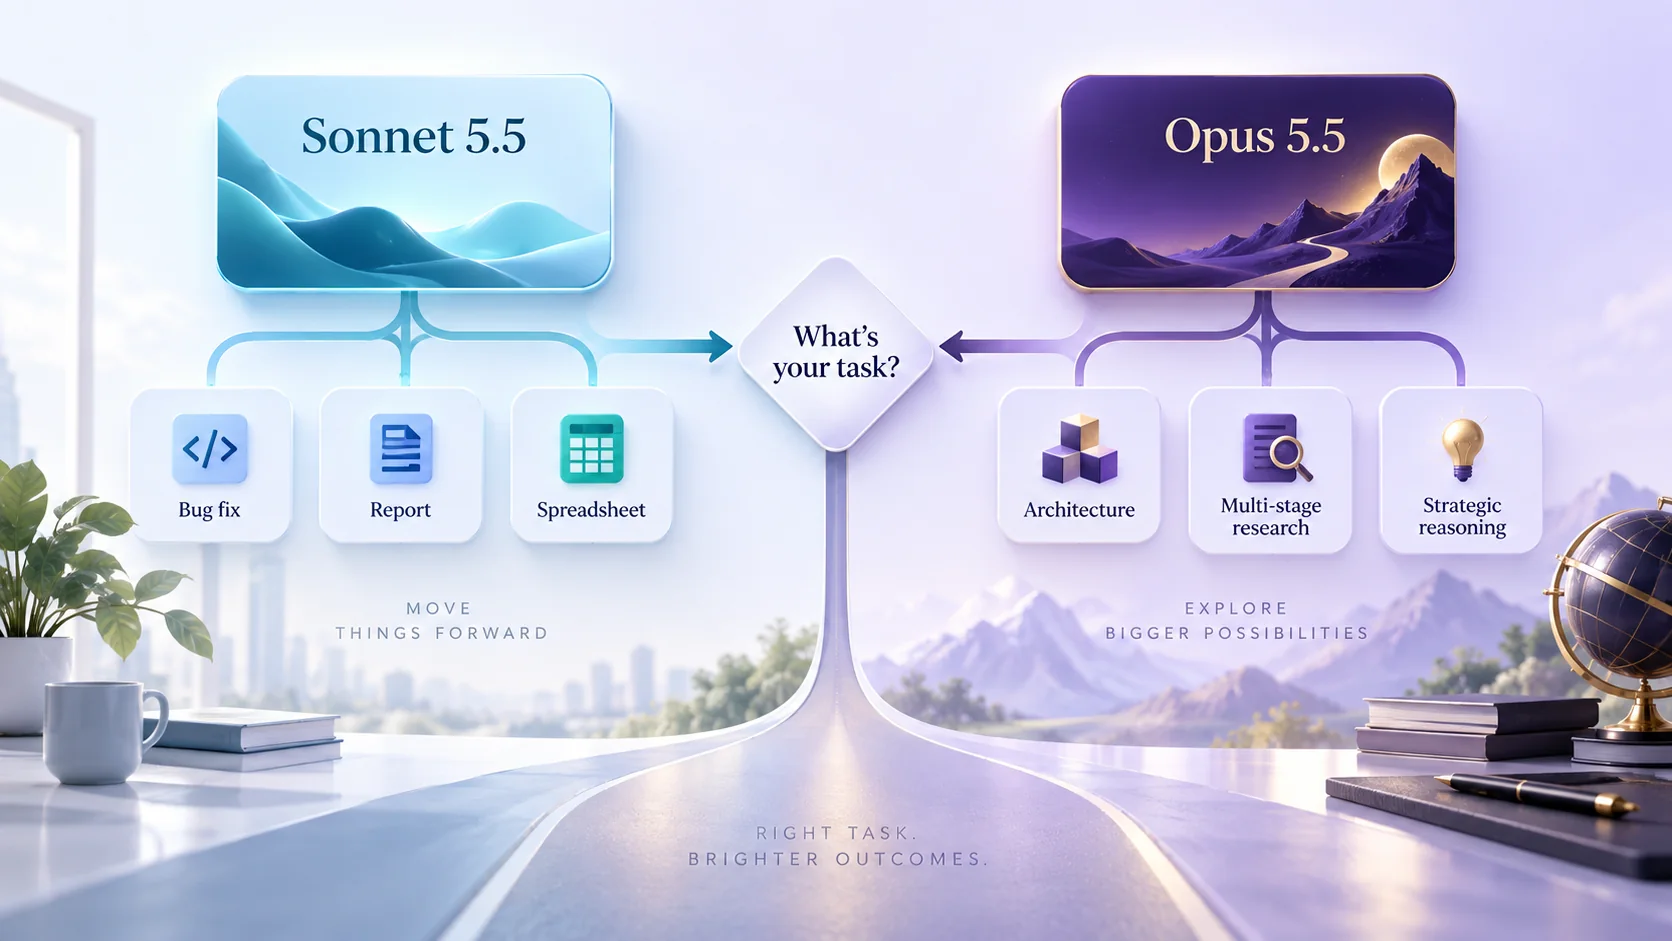
Sonnet fait sens lorsque la réussite peut être décrite clairement et vérifiée sans interprétation approfondie. Les exemples incluent la correction d’un bug reproductible, la transformation d’un jeu de données connu, la synthèse d’une collection définie de documents, la rédaction d’une présentation à partir de résultats approuvés, ou l’application d’une réécriture cohérente sur de nombreux fichiers. Ces tâches peuvent rester exigeantes, mais elles ont des limites et une ligne d’arrivée reconnaissable.
La différence de prix devient importante à grande échelle. Les jetons d’entrée et de sortie standard coûtent deux fois moins cher qu’Opus, tandis que les lectures du cache ont le même coût. Anthropic affirme aussi que Sonnet 5.5 génère une sortie plus de 30 % plus vite que Sonnet 5, bien qu’elle ne présente pas cette affirmation comme une comparaison directe de vitesse avec Opus 5.5. Les équipes devraient mesurer la latence sous leur propre charge plutôt que supposer que le nom du niveau prédit le temps de réponse dans chaque environnement.
Pour les flux de travail récurrents, l’effort réglable de Sonnet peut aider à maîtriser les coûts. Un effort plus faible peut convenir pour la classification, la mise en forme ou des brouillons de routine ; un effort plus élevé peut être justifié pour des modifications de code ou des analyses qui nécessitent davantage de contrôles. La bonne pratique consiste à définir des tests d’acceptation et à faire remonter les cas difficiles plutôt qu’à utiliser le niveau d’effort maximal pour tout.
Quand Opus 5.5 justifie son prix plus élevé
Opus est le candidat le plus solide lorsque le modèle doit définir le problème au fur et à mesure. Une migration de code complexe, une stratégie transfonctionnelle, une investigation en plusieurs étapes, ou une analyse ambiguë peuvent nécessiter que le modèle revienne sur ses hypothèses, équilibre des contraintes et maintienne la cohérence sur une longue chaîne d’actions. Ce sont exactement les situations qu’Anthropic désigne par « jugement soutenu ».
Le calcul de la valeur change aussi avec le risque. Si un relecteur senior doit passer des heures à corriger une réponse plausiblement correcte, mais subtilement erronée, les économies sur les jetons étaient une fausse économie. Opus peut valoir le tarif plus élevé lorsqu’une exécution réussie évite un remaniement important, mais il doit quand même être évalué selon des critères explicites : une étiquette premium n’élimine pas le besoin de vérifications des sources, de tests et d’approbation humaine.
Programmation : effectuez le routage par périmètre, pas par prestige
Pour le code, commencez par la limite de la tâche. Sonnet est un choix par défaut solide pour un bug localisé, un point d’arrivée bien défini, la génération de tests, ou une refonte circonscrite. Opus est plus défendable pour le travail d’architecture, la coordination sur plusieurs dépôts, une migration avec des exigences incomplètes, ou une investigation où la cause racine est inconnue.
Exécutez les deux modèles sur un échantillon représentatif avant de formaliser le routage. Évaluez la correction, le risque de régression, les modifications inutiles, la qualité des tests, le temps écoulé, l’utilisation des jetons et l’effort du relecteur. La note d’Anthropic sur FrontierCode est pertinente ici : davantage de raisonnement peut amener un agent à effectuer des changements en dehors du périmètre demandé ; la qualité inclut donc aussi la capacité à savoir quand s’arrêter.
Travail de recherche et documents
Les scores de Sonnet proches d’Opus dans les évaluations d’Anthropic sur le travail de connaissance en font un choix convaincant pour des flux de travail structurés de documents. Si le travail consiste à comparer cinq rapports, extraire des champs spécifiés, ou transformer des notes approuvées en plan de présentation, Sonnet peut fournir la qualité requise à moindre coût. Opus devient plus attrayant lorsque les sources sont contradictoires, que la question de recherche évolue, ou que le modèle doit produire et défendre des choix d’interprétation difficiles.
Quel que soit le modèle que vous choisissez, la préparation des sources détermine souvent la qualité de la sortie. Des fichiers dupliqués, des versions floues et un manque de contexte peuvent affaiblir même un modèle solide. L’AI Summarizer d’iWeaver peut aider à organiser des fichiers et des liens hétérogènes en synthèses, points clés, briefings exécutifs ou notes structurées avant que l’analyse de plus haut niveau ne commence. Il s’agit d’un flux d’information complémentaire ; cela n’implique pas que l’un ou l’autre des modèles Claude soit actuellement sélectionnable dans iWeaver.
Une règle pratique de routage
Commencez par Sonnet lorsque la tâche a des entrées claires, une livraison clairement définie et une méthode de validation simple. Basculez sur Opus lorsque le problème reste ambigu après clarification, s’étend sur de nombreuses étapes dépendantes, entraîne un coût élevé d’erreur, ou échoue à répétition à vos tests d’acceptation avec Sonnet. Cette approche offre généralement un meilleur équilibre coût-qualité que le fait de choisir un modèle différent pour chaque requête.
La décision finale doit reposer sur l’économie de la tâche terminée. Suivez le nombre total de jetons, l’utilisation du cache, les reprises (retries), la latence, le temps des relecteurs et la sévérité des échecs à partir d’exemples réels. Les gains de benchmark de Sonnet 5.5 en font un choix par défaut crédible au quotidien ; Opus 5.5 reste le choix délibéré lorsque la complexité et le jugement justifient de payer plus. Pour explorer en détail le modèle moins coûteux, consultez Claude Sonnet 5.5 : Benchmarks, Tarifs, Fonctionnalités & Nouveautés, ou continuez avec Comment utiliser Claude Sonnet 5.5.