
Grok 4.7 est officiellement là. Lancé le 21 septembre 2026, Grok 4.7 est le dernier modèle frontière d'xAI pour le codage, les tâches agentiques et le travail professionnel basé sur la connaissance.
C’est plus qu’une simple mise à jour de Grok 4.6. xAI affirme que Grok 4.7 utilise un nouveau modèle de base, plus grand, une phase d’apprentissage par renforcement plus longue et un entraînement qui accorde davantage de poids aux tâches difficiles, capables de prendre des heures. Il améliore également l’auto-vérification et la gestion des longs contextes—deux points qui comptent bien plus dans les flux de travail réels que de simplement répondre à de courts prompts. Et contrairement aux premières spéculations autour de Grok 4.7, nous avons maintenant des spécifications officielles et des résultats de benchmarks à comparer.
Date de sortie de Grok 4.7
Grok 4.7 a officiellement été lancé. Il est disponible via l’API xAI sous la forme : grok-4.7
Au lancement, xAI a aussi rendu le modèle disponible via plusieurs plateformes de codage et d’IA, dont Grok Build et Cursor. GitHub a également commencé à déployer Grok 4.7 auprès des utilisateurs de GitHub Copilot.
Pour plus de contexte sur la génération précédente, vous pouvez également consulter notre revue de Grok 4.6.
Les spécifications de Grok 4.7 en un coup d’œil
Voici les principales spécifications officielles.
| Specification | Grok 4.7 |
|---|---|
| Release date | 21 septembre 2026 |
| Model name | grok-4.7 |
| Context window | 500,000 tokens |
| Knowledge cutoff | Mai 2026 |
| Input modalities | Texte et image |
| Output modality | Texte |
| Text output limit | Aucune limite fixe de sortie texte |
| Reasoning levels | Faible, Moyen, Élevé, XÉlevé |
| Default reasoning | Élevé |
| Function calling | Pris en charge |
| Web search | Pris en charge |
| X search | Pris en charge |
| Code execution | Pris en charge |
| API support | Responses API, Chat Completions |
La fenêtre de contexte de 500K est particulièrement utile pour les longs documents, les grosses bases de code, les projets multi-fichiers, les tâches de recherche et les flux agentiques qui doivent conserver beaucoup d’informations au fil du temps.
Grok 4.7 prend aussi en charge quatre niveaux de raisonnement :
- Faible
- Moyen
- Élevé
- XÉlevé
Cela permet aux développeurs d’arbitrer entre vitesse et profondeur de raisonnement selon la tâche.
Quoi de neuf dans Grok 4.7 ?
Les changements les plus importants ne sont pas des nouveautés d’interface spectaculaires.
Ils concernent surtout la façon dont le modèle gère un travail plus long et plus difficile.
1. Un nouveau modèle de base, plus grand
Grok 4.7 repose sur un nouveau modèle de base, plus grand que celui de Grok 4.6.
Cela compte car ce n’est pas simplement Grok 4.6 avec un post-entraînement supplémentaire.
Le modèle sous-jacent lui-même a évolué.
xAI l’a ensuite entraîné avec une phase de renforcement plus longue, sur un mélange de tâches plus ardu, en mettant davantage l’accent sur des problèmes susceptibles de prendre de nombreuses heures à compléter.
L’objectif est clair :
rendre Grok meilleur pour terminer un travail difficile—pas seulement pour le démarrer correctement.
2. Des performances améliorées sur les tâches longues
Beaucoup de modèles IA semblent impressionnants sur de courts prompts, mais deviennent moins fiables à mesure que la tâche s’allonge.
Cela peut se manifester par :
- des instructions oubliées
- des décisions incohérentes
- du travail répété
- des dépendances manquées
- des erreurs qui ne sont jamais vérifiées
- une mauvaise utilisation du contexte précédent
Grok 4.7 est spécifiquement entraîné pour mieux réussir sur des tâches qui durent plus longtemps.
C’est particulièrement pertinent pour les agents de codage, les workflows de recherche, la création de documents et le travail professionnel impliquant plusieurs étapes.
3. Une meilleure auto-vérification
Autre changement important : une auto-vérification plus solide.
Au lieu de simplement générer une réponse puis passer à autre chose, Grok 4.7 est conçu pour vérifier son travail plus soigneusement.
Cela compte pour des tâches comme :
- déboguer du code
- modifier de gros projets
- vérifier des calculs
- relire des documents
- suivre de longues instructions
- utiliser plusieurs outils en séquence
Bien sûr, l’auto-vérification ne signifie pas que le modèle ne peut pas se tromper.
La revue humaine reste essentielle pour les travaux à fort enjeu.
Mais une vérification interne améliorée peut réduire les échecs évidents pendant les workflows longs.
4. Des agents et un travail axé sur la connaissance renforcés
Grok 4.7 a aussi été entraîné pour mieux comprendre le Grok Bot d'xAI.
Cela le rend particulièrement pertinent pour les tâches de type agent, où l’IA doit faire plus que répondre à une seule question.
Par exemple :
- inspecter des fichiers
- rechercher de l’information
- écrire du code
- exécuter des outils
- examiner les résultats
- réviser son propre travail
- continuer jusqu’à ce qu’une tâche plus vaste soit terminée
Cela reflète un changement plus large dans l’IA de pointe.
La question clé n’est désormais plus seulement :
Le modèle peut-il répondre à cette question ?
Elle devient de plus en plus :
Le modèle peut-il terminer toute la tâche ?
Les benchmarks de Grok 4.7
xAI a publié des résultats de benchmarks comparant Grok 4.7 à Grok 4.6 et à d’autres modèles de pointe.
Les résultats montrent des gains particulièrement visibles en codage, sur les tâches basées terminal, en ingénierie et dans le travail professionnel fondé sur la connaissance.
Pour une comparaison la plus propre possible, le tableau ci-dessous se concentre sur Grok 4.7 vs Grok 4.6.
| Benchmark | Grok 4.7 | Grok 4.6 | Change |
|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | +5.9 pts |
| DeepSWE v1.1 | 71.0% | 65.2% | +5.8 pts |
| AA Briefcase v1.1 | 1,657 | 1,546 | +111 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | +17.7 pts |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | +3.8 pts |
| HealthBench Professional | 56.7% | 48.5% | +8.2 pts |
| EEBench | 64.0% | 53.0% | +11.0 pts |
La plus grande progression de cet ensemble apparaît sur Terminal-Bench 4.0, où Grok 4.7 obtient 38.0% contre 20.3% pour Grok 4.6.
C’est particulièrement pertinent pour les workflows de codage agentiques qui impliquent des commandes terminal, des outils, des dépôts et une exécution en plusieurs étapes.
Grok 4.7 montre aussi des gains notables en ingénierie électrique, dans le travail professionnel fondé sur la connaissance, en génie logiciel et sur des benchmarks de raisonnement clinique.
Grok 4.7 vs Grok 4.6
Les chiffres de benchmark rendent le changement de génération plus facile à visualiser.
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Status | Génération précédente | Génération la plus récente |
| Base model | Modèle précédent | Nouveau modèle de base, plus grand |
| Context window | — | 500K tokens |
| Long-running tasks | Solide | Amélioré |
| Self-verification | Solide | Amélioré |
| CursorBench 4.0 | 40.4% | 46.3% |
| DeepSWE v1.1 | 65.2% | 71.0% |
| Terminal-Bench 4.0 | 20.3% | 38.0% |
| EEBench | 53.0% | 64.0% |
| API input price | 2 $ / 1M tokens | Commence à 2 $ / 1M tokens |
| API output price | 6 $ / 1M tokens | Commence à 6 $ / 1M tokens |
La raison la plus importante d’actualiser de Grok 4.6 vers Grok 4.7 n’est donc pas une seule fonctionnalité phare.
C’est la combinaison de :
meilleur codage + meilleures performances sur les tâches longues + meilleure gestion du contexte + auto-vérification plus solide.
Si votre charge de travail consiste principalement en de courtes questions du quotidien, la différence peut sembler moins marquée.
Pour les développeurs et les utilisateurs qui exécutent des workflows longs et multi-étapes, l’amélioration est plus significative.
Tarification de Grok 4.7
Grok 4.7 commence à :
- 2 $ pour 1 million de tokens en entrée
- 0,50 $ pour 1 million de tokens en entrée mis en cache
- 6 $ pour 1 million de tokens en sortie
Ces tarifs s’appliquent lorsque le prompt est inférieur à 200K tokens.
Pour des prompts au-delà de 200K tokens, la tarification officielle de l’API augmente à :
- 4 $ pour 1 million de tokens en entrée
- 1 $ pour 1 million de tokens en entrée mis en cache
- 12 $ pour 1 million de tokens en sortie
Ce découpage par paliers mérite d’être noté car Grok 4.7 dispose d’une fenêtre de contexte de 500K.
Utiliser toute la fenêtre de contexte peut donc coûter plus cher que des requêtes plus courtes.
Qu’est-ce que Grok 4.7 Fast ?
xAI propose aussi Grok 4.7 Fast.
Il s’agit du même modèle sous-jacent servi sur une infrastructure plus rapide.
D’après xAI, il délivre environ deux fois la vitesse de sortie pour deux fois les tarifs standards par token.
Cependant, il existe une différence importante en disponibilité :
Grok 4.7 Fast est actuellement disponible via Cursor et Grok Build, mais pas via la publique API xAI.
Cela fait du modèle Grok 4.7 standard l’option principale pour les développeurs qui construisent directement avec l’API xAI.
Où pouvez-vous utiliser Grok 4.7 ?
Grok 4.7 est déjà disponible sur plusieurs plateformes.
API xAI
Les développeurs peuvent utiliser :
grok-4.7
via l’API xAI Responses ou l’API Chat Completions.
Il prend en charge des outils, notamment :
- function calling
- web search
- X search
- code execution
Grok Build
Grok 4.7 est le modèle par défaut pour Grok Build, l’agent d’xAI pour le codage et la création d’applications.
Cursor
Grok 4.7 est disponible dans Cursor.
La variante Fast y est également disponible.
Model Gateways
La documentation d'xAI liste la disponibilité via des plateformes, notamment :
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
GitHub a commencé à déployer Grok 4.7 pour GitHub Copilot le 21 septembre.
Il est proposé dans l’ensemble des offres Copilot Pro, Pro+, Max, Business et Enterprise.
Les environnements pris en charge incluent :
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot cloud agent
- GitHub Copilot app
- JetBrains
- Xcode
- Eclipse
Le déploiement est progressif, de sorte que certains utilisateurs ne le verront peut-être pas immédiatement.
Ne jugez pas Grok 4.7 sur un seul benchmark
Les résultats officiels sont utiles, mais un tableau de benchmark ne doit pas être la raison finale pour choisir un modèle.
Chaque benchmark teste des choses différentes.
Un modèle qui excelle sur un benchmark de codage n’est pas forcément le meilleur choix pour :
- la recherche
- l’analyse de documents
- l’écriture
- le support client
- l’extraction de données
- la synthèse
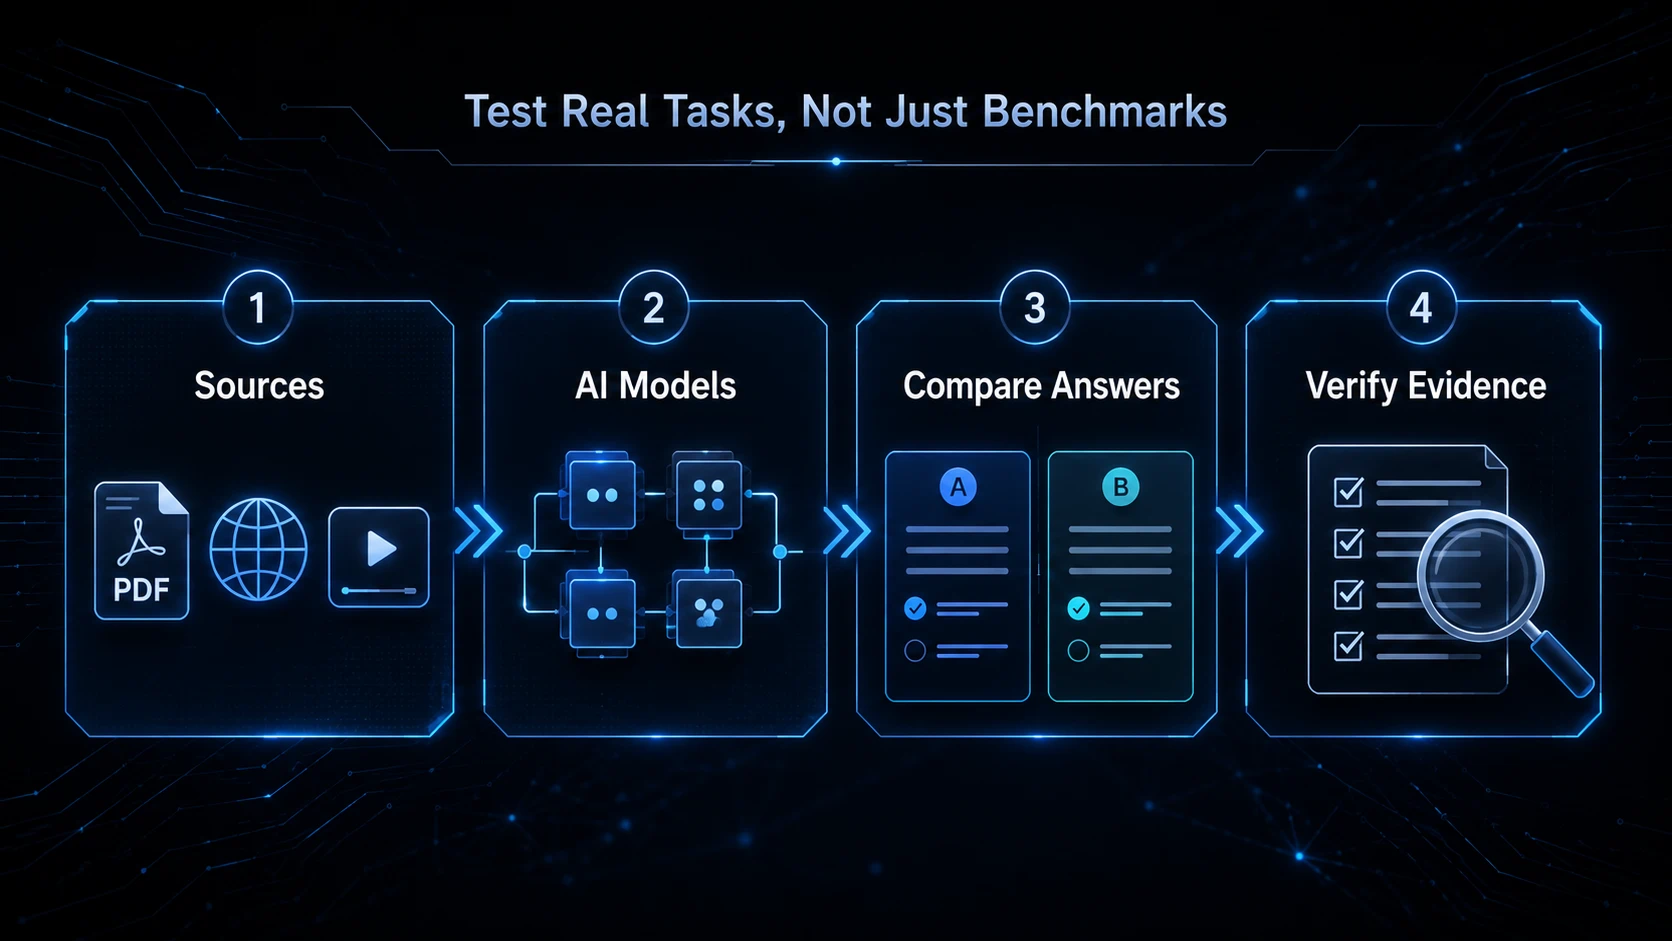
Un meilleur test consiste à comparer les modèles en utilisant la même tâche réelle.
Par exemple :
- Donnez à chaque modèle la même question.
- Fournissez les mêmes fichiers sources.
- Utilisez les mêmes instructions.
- Comparez les réponses finales.
- Vérifiez les informations manquantes et les erreurs factuelles.
- Validez les conclusions importantes à l’aide des sources d’origine.
Si votre travail implique des PDFs, des sites web, des vidéos, des présentations ou des documents de recherche, des outils comme iWeaver peuvent vous aider à organiser ces éléments en un seul endroit avant de comparer les sorties des modèles.
Cela facilite l’évaluation de la véritable utilité d’un modèle IA pour votre workflow, plutôt que de se baser uniquement sur le classement.
Grok 4.7 vaut-il la peine d’être utilisé ?
Pour le codage et les workflows agentiques, Grok 4.7 constitue une mise à jour significative par rapport à Grok 4.6.
Les données officielles de benchmark montrent des améliorations dans le génie logiciel, le travail sur terminal, les tâches professionnelles, l’ingénierie électrique, les tâches juridiques et le raisonnement clinique.
La combinaison d’une fenêtre de contexte de 500K, de meilleures performances sur les tâches longues, d’une auto-vérification améliorée, d’une prise en charge des outils et d’une tarification de départ identique pour l’API rend aussi le modèle plus pratique pour les workflows plus importants.
Cela ne signifie pas que Grok 4.7 sera le meilleur modèle pour chaque tâche.
Différents modèles ont encore des forces différentes, et les résultats de benchmark ne se traduisent pas toujours directement par de meilleures sorties en conditions réelles.
Mais Grok 4.7 offre aux développeurs et aux utilisateurs professionnels une option plus solide que Grok 4.6—surtout lorsque la tâche implique de nombreuses étapes, de grandes quantités de contexte ou un usage prolongé d’outils.
Grok 4.7 n’est pas juste une nouvelle petite mise à jour de Grok.
Il s’appuie sur un nouveau modèle de base, plus grand, et met bien plus l’accent sur le codage longue durée, le travail agentique, l’auto-vérification et les tâches de connaissance professionnelle.
Par rapport à Grok 4.6, les chiffres officiels montrent des progrès clairs sur plusieurs benchmarks exigeants, tandis que le prix de départ de l’API reste inchangé.
La question la plus intéressante n’est donc plus de savoir si Grok 4.7 est meilleur que Grok 4.6 sur le papier.
C’est la mesure dans laquelle cette amélioration se répercute sur des projets réels.
Pour les développeurs, les chercheurs et les utilisateurs qui construisent des workflows IA plus longs, c’est là que Grok 4.7 sera finalement mis à l’épreuve.