
Le traitement intelligent des documents (TDl) utilise l’IA et des technologies associées pour transformer le contenu des documents en informations qu’un workflow peut exploiter. Un système typique classe les documents entrants, extrait les données pertinentes, valide les résultats et transmet les informations révisées à l’étape suivante. La véritable question est de savoir si le résultat est suffisamment fiable pour l’action qui suit — et non pas si le système peut lire une page.
La présentation d’AWS sur le TDl décrit ces étapes, y compris des contrôles basés sur les règles métier ou sur des données existantes. Cette étape de validation compte : un montant de facture plausible peut pourtant être erroné, et une valeur correctement extraite peut correspondre à une facture que votre système a déjà reçue.
Commencer par l’action après l’extraction
Avant d’évaluer un outil, terminez cette phrase : « Une fois le document traité, nous devons… ». La réponse peut être de créer un enregistrement, d’assigner un évaluateur, de comparer les informations avec un bon de commande, ou de préparer un point d’information. Chaque résultat nécessite des contrôles différents et un niveau d’automatisation différent.
Si la tâche se termine par une personne qui lit un résumé, la compréhension du document peut suffire. Si la sortie modifie un enregistrement dans un autre système, vous devez aussi définir un schéma, des règles de validation et une procédure pour les exceptions. Ces exigences doivent être établies avant le pilote, car une simple démonstration d’extraction ne peut pas prouver que l’ensemble du workflow est prêt.
Les étapes d’un workflow TDl
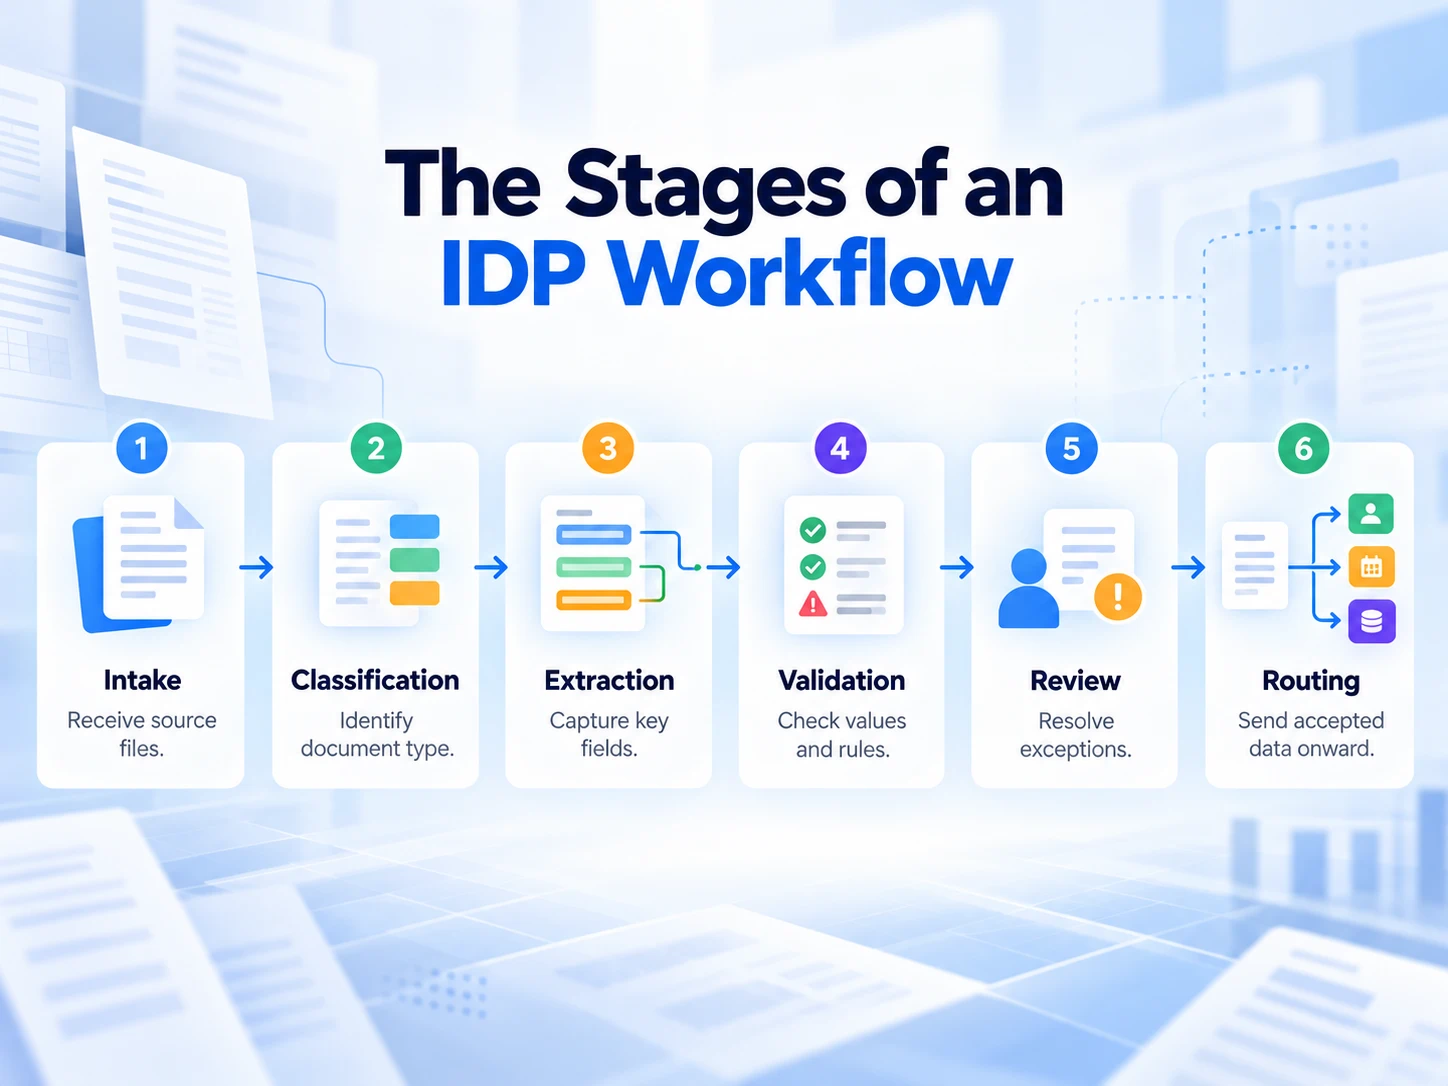
| Étape | Objectif | Exemple de défaillance à détecter |
|---|---|---|
| Réception | Recevoir et identifier les fichiers source | Le même fichier arrive deux fois |
| Classification | Déterminer le type de document ou la catégorie pertinente | Une note de crédit est traitée comme une facture |
| Extraction | Capturer les champs nécessaires à la tâche | Un sous-total est capturé comme total |
| Validation | Vérifier les valeurs, les relations et les informations requises | Le total échoue à la règle de calcul convenue |
| Révision | Résoudre des résultats ambigus ou rejetés | Une date peu claire entraîne un « bon » supposé non justifié |
| Routage | Transmettre les informations acceptées à l’étape suivante | Un enregistrement valide est envoyé à la mauvaise destination |
Il s’agit d’un modèle de planification, plutôt que d’une garantie selon laquelle chaque produit TDl fournit toutes ces six étapes. Vérifiez quels composants un service propose et lesquels vous devez construire ou configurer vous-même.
La classification choisit la prochaine interprétation
Les documents peuvent se ressembler tout en répondant à des finalités différentes. Une facture, un bon de commande et une note de crédit peuvent contenir des noms, des dates et des montants, mais ils ne doivent pas déclencher la même action. La classification détermine quelles règles d’extraction et quelles exigences de révision s’appliquent.
La vue d’ensemble de Document Intelligence de Microsoft décrit des classifieurs personnalisés aux côtés de modèles d’extraction. Cette distinction illustre pourquoi reconnaître le type de document et extraire son contenu sont deux tâches distinctes. Un workflow doit également définir ce qui se passe lorsque le type est incertain ou sort de l’ensemble attendu.
L’extraction requiert une définition claire de chaque champ
« Extraire la date » est ambigu lorsqu’un fichier contient une date d’émission, une date de service et une date limite de paiement. Définissez le champ dont vous avez besoin et la façon dont il doit apparaître dans la sortie. Ajoutez des règles pour les valeurs manquantes et conservez les informations nécessaires pour vérifier l’extraction.
Par exemple, un schéma de facture peut demander le nom du fournisseur, le numéro de facture, la date de facture, la devise, le total et la taxe. Ces définitions de champs doivent préciser quelle valeur choisir lorsqu’un document présente plusieurs candidats. Ajouter un champ est facile ; décider ce qui constitue un résultat correct demande plus d’attention.
La validation vérifie plus que la lisibilité
Certains contrôles confirment qu’une valeur a bien la forme attendue. D’autres vérifient les relations au sein du document ou comparent les données extraites à un enregistrement de référence. Une date peut être correctement mise en forme tout en correspondant au mauvais événement, et un total peut être lisible tout en étant incohérent avec les lignes.
Définissez la règle métier et l’action à mener en cas d’échec. Par exemple, l’absence d’un numéro de facture peut nécessiter une révision, tandis qu’une combinaison fournisseur + numéro de facture répétée peut déclencher un contrôle de doublon. Le passage d’un contrôle de format ne doit pas autoriser automatiquement une action en aval.
Un exemple concret de facture
Imaginez une facture fournisseur avec les détails suivants : la date d’émission est le 5 mars, la date d’échéance est le 4 avril, le sous-total est de 1 000 et le total de 1 080. La devise n’est pas imprimée de manière suffisamment claire pour être déterminée. Il s’agit d’un exemple illustratif, et non d’un résultat mesuré à partir d’un test produit.
Un système d’extraction peut renvoyer un enregistrement bien présenté avec le 4 avril comme date de facture, 1 000 comme total et une devise supposée. Chaque valeur est plausible prise isolément. Ensemble, elles montrent pourquoi un workflow TDl a besoin de significations explicites des champs et de règles de révision.
| Champ demandé | Valeur révisée | Contrôle d’acceptation |
|---|---|---|
| Date de facture | 5 mars | Utiliser la date d’émission, pas la date d’échéance |
| Date d’échéance | 4 avril | La conserver distincte de la date de facture |
| Total | 1 080 | Identifier le total final et examiner ses composantes |
| Devise | Non résolue | Laisser non résolue et demander une révision |
La prochaine étape correcte consiste à résoudre la devise avant d’utiliser l’enregistrement dans le cas où la devise compte. Un enregistrement complet en apparence, créé en devinant, est moins utile qu’un enregistrement incomplet qui identifie clairement ce qu’un évaluateur doit vérifier.
OCR, Document AI, TDl et RPA
Le Document AI de Google propose des processeurs pour l’OCR, l’extraction et la classification. Ces composants montrent comment un workflow peut utiliser différentes capacités selon les étapes. Le fait qu’un extracteur existe ne vous indique pas si vos règles de validation ou la gestion des exceptions ont été mises en œuvre.
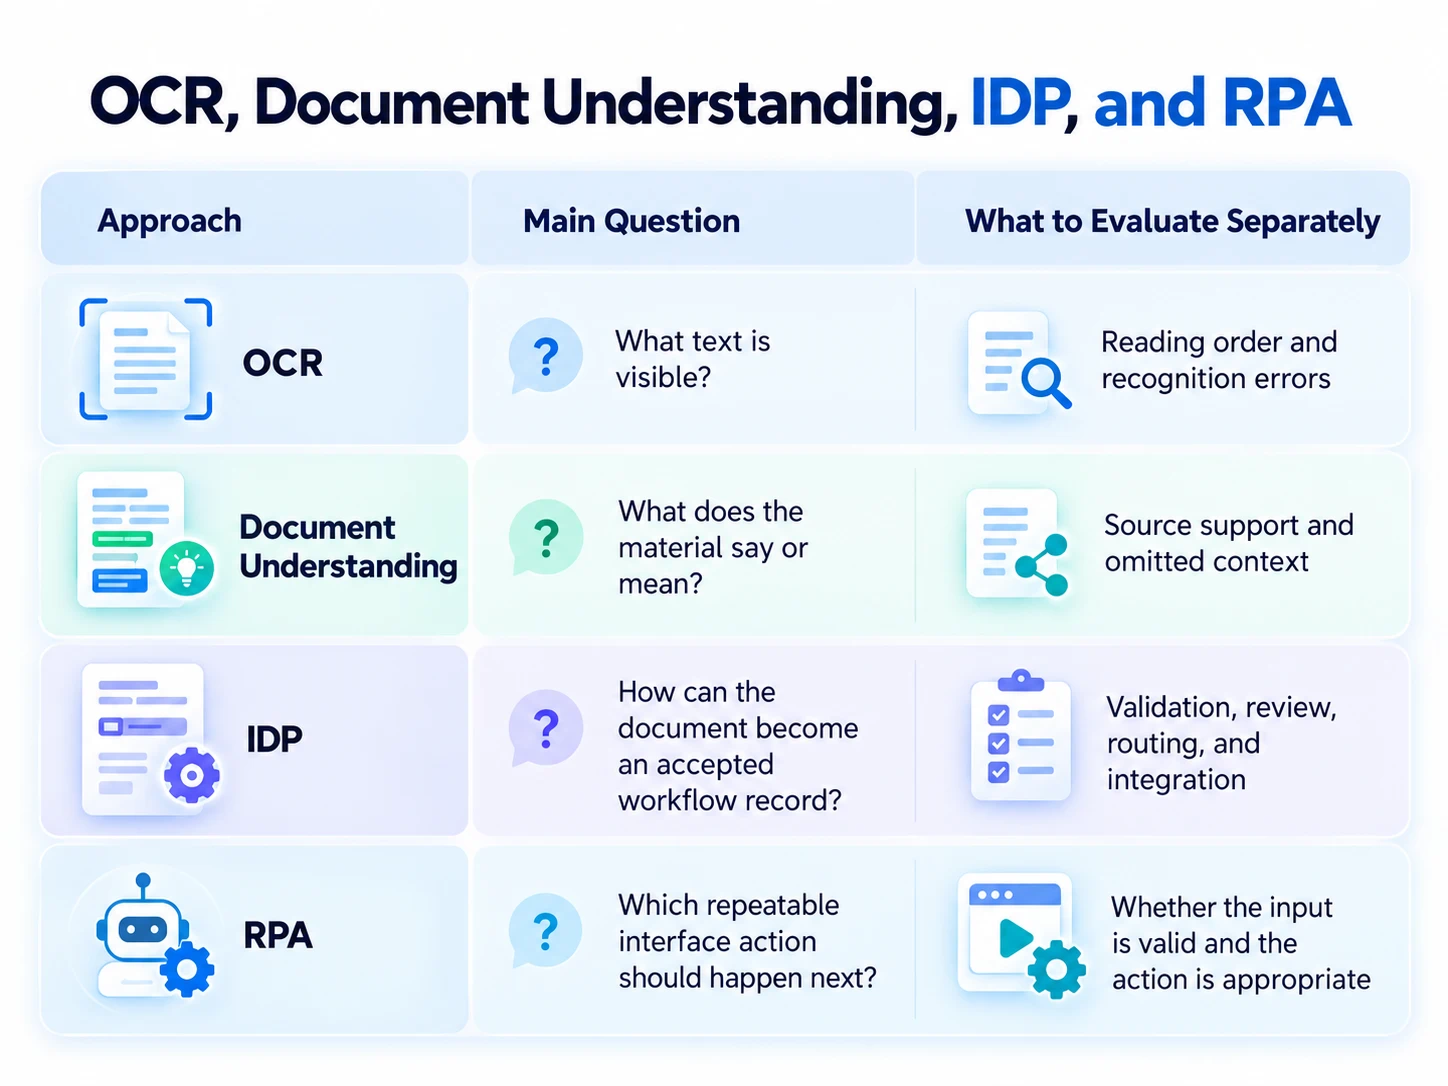
| Approche | Question principale qu’elle résout | Ce qu’il faut évaluer séparément |
|---|---|---|
| OCR | Quel texte est visible ? | L’ordre de lecture et les erreurs de reconnaissance |
| Compréhension du document | Que dit ou que signifie ce document ? | Le support source et le contexte omis |
| TDl | Comment le document peut-il devenir un enregistrement de workflow accepté ? | La validation, la révision, le routage et l’intégration |
| RPA | Quelle action d’interface répétable doit se produire ensuite ? | Si l’entrée est valide et si l’action est appropriée |
Les limites sont pratiques plutôt qu’absolues : les produits peuvent combiner plusieurs approches. Utilisez cette distinction pour poser de meilleures questions d’évaluation, plutôt que de supposer qu’un libellé marketing définit l’ensemble du système.
Où l’IA générative aide — et où les règles restent essentielles
Les modèles génératifs peuvent interpréter des instructions et un langage varié, ce qui les rend pertinents pour une extraction flexible et la compréhension des documents. Google décrit un extracteur personnalisé basé sur l’IA générative dans son offre Document AI. Cela soutient l’affirmation de capacité pour ce produit ; cela ne définit pas un niveau de précision universel pour chaque fichier ou workflow.
Pour un pilote d’IA de traitement intelligent des documents, définissez ce que le modèle est autorisé à déduire. Certaines tâches nécessitent une valeur normalisée ; d’autres exigent une transcription directe. Maintenez ces modes distincts afin que les évaluateurs puissent déterminer si un champ provient d’une affirmation explicite ou d’une interprétation.
Un prompt peut demander « utiliser null lorsqu’il manque », mais le workflow doit toujours vérifier la sortie. Ne vous fiez pas à des explications fluides comme preuve qu’un champ est correct. Examinez le passage source pertinent, la définition du champ et toute règle appliquée après l’extraction.
Comment concevoir un pilote TDl utile
Choisir une famille de documents et un seul résultat
Commencez par une tâche cadrée, comme l’extraction de champs spécifiés dans des factures fournisseurs pour révision. Définissez ce que le pilote produira et qui inspectera les exceptions. Étendre à plusieurs familles de documents avant d’avoir compris le premier workflow peut rendre les échecs plus difficiles à diagnostiquer.
Construire un ensemble d’évaluation représentatif
Incluez des exemples ordinaires et les variations que vous vous attendez à recevoir : champs manquants, mises en page inconnues, documents multi-pages, scans de mauvaise qualité et doublons. Faites en sorte qu’un évaluateur établisse les résultats attendus avant les tests. Gardez un ensemble séparé « tenu à l’écart » afin que l’évaluation finale inclue des fichiers qui n’ont pas guidé vos choix de configuration.
Mesurer les résultats au bon niveau
La correction des champs et l’acceptation du document répondent à des questions différentes. Un système peut capturer correctement la plupart des champs tout en manquant fréquemment le champ indispensable pour accomplir la tâche. Notez quels champs échouent, à quelle fréquence les documents nécessitent une révision et ce qui rend un enregistrement prêt pour l’étape suivante.
Utilisez ces définitions de façon cohérente :
- Correction des champs : champs évalués corrects divisés par l’ensemble des champs évalués, en utilisant une règle de correspondance documentée.
- Taux de révision : documents nécessitant une révision humaine divisés par les documents traités.
- Taux d’acceptation : documents satisfaisant à tous les contrôles d’acceptation définis divisés par les documents traités.
- Effort de révision : temps consacré à la résolution des exceptions, mesuré avec un point de départ et un point de fin cohérents.
Il s’agit de mesures d’évaluation suggérées, et non d’affirmations de performance. Séparez les champs manquants des valeurs incorrectes, et consignez aussi les échecs en aval ainsi que les erreurs d’extraction. Cette distinction vous aide à décider s’il faut améliorer l’analyse, reformuler une définition de champ ou ajuster la route de révision.
Tester la gestion des échecs avant d’augmenter l’automatisation
Vérifiez ce qui se passe lorsqu’un fichier ne peut pas être lu, lorsque le type de document est inconnu, ou lorsque des champs requis entrent en conflit. Le workflow doit rendre visible l’état non résolu et conserver suffisamment de contexte pour qu’un évaluateur puisse intervenir. Assurez-vous qu’un enregistrement rejeté ne passe pas silencieusement au système suivant.
Si vous évaluez un outil « IA TDl », demandez à voir le chemin de l’exception avec vos propres documents représentatifs. Une démonstration réussie doit inclure la façon dont un échec est géré, pas seulement la manière dont un fichier « standard » est traité.
Où iWeaver s’intègre
Certaines tâches documentaires se terminent par une compréhension plutôt que par un enregistrement opérationnel. Si vous lisez des rapports ou préparez un point d’information, iWeaver propose des résumés, des conversations avec l’IA et de l’organisation des connaissances. Son AI Document Summarizer peut servir de point de départ pour examiner la matière source et décider de ce qui mérite une attention plus étroite.
Par exemple, demandez un aperçu des affirmations d’un rapport, des preuves et de ses limites avant de planifier votre analyse. Le workflow public de documents iWeaver prend en charge des résumés sur mesure et une exploration de suivi. Référez-vous à l’original chaque fois qu’un fait compte, et évaluez séparément toute capacité d’extraction ou d’intégration requise au niveau entreprise.
Questions à se poser avant de choisir un système TDl
Le traitement intelligent des documents est-il la même chose que l’OCR ?
L’OCR se concentre sur la reconnaissance du texte. Un workflow TDl ajoute des tâches telles que la classification, l’extraction, la validation, la révision et le routage. Identifiez quelles étapes votre tâche nécessite réellement avant de comparer les produits.
Le TDl peut-il fonctionner sans révision humaine ?
Cela dépend des documents, des critères d’acceptation et des conséquences d’une erreur. Définissez quels résultats peuvent avancer automatiquement et lesquels nécessitent une révision. Utilisez les éléments recueillis pendant le pilote pour établir ces règles, plutôt que de supposer que l’automatisation convient à chaque entrée.
Comment un workflow TDl doit-il gérer les informations manquantes ?
Représentez explicitement la valeur manquante et appliquez une règle définie. Un champ requis peut entraîner un rejet ou une révision ; un champ optionnel peut rester vide. Deviner une valeur manquante rend le résultat plus difficile à auditer et moins sûr pour l’étape suivante.
Par quoi commencer les tests ?
Testez d’abord si les champs requis pour l’action suivante sont correctement capturés et validés. Ensuite, testez les exceptions, les doublons et la destination des enregistrements acceptés. Un score d’extraction de haut niveau ne suffit pas si le champ critique ou la voie en cas d’échec reste peu fiable.
Rendre la première révision de workflow consultable
Choisissez une tâche documentaire étroite, définissez la sortie acceptée et testez à la fois des fichiers « standards » et des exceptions. Traitez l’extraction comme une étape dans un processus dont le résultat final doit être vérifié. Lorsque votre objectif immédiat est de comprendre un document, commencez par un résumé basé sur la source et utilisez-le pour guider votre révision.