
Claude Sonnet 5.5 et GPT-6.1 Sol ont les mêmes tarifs standard de jetons d’API, mais ils sont pensés autour de points forts différents. Sonnet 5.5 est conçu pour le codage rapide et bien délimité ainsi que pour les tâches professionnelles. GPT-6.1 Sol vise le codage complexe, l’utilisation de l’ordinateur, les travaux pilotés par des outils et les workflows professionnels, tout en offrant une performance proche d’Astra à moindre coût.
Le choix pratique dépend de la tâche. Sonnet 5.5 mérite un essai pour le codage borné, les documents soignés, les slides et les tableurs. GPT-6.1 Sol est un excellent candidat lorsque vous avez besoin d’une fenêtre de contexte très large, des outils de l’API Responses d’OpenAI, ou d’un workflow en plusieurs étapes. iWeaver propose un essai gratuit de GPT-6.1 Sol, ce qui vous permet de tester le modèle sur vos propres documents et vos tâches de recherche avant de choisir.
Claude Sonnet 5.5 vs GPT-6.1 Sol : un aperçu
| Détail | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| Prix d’entrée standard | 2 $ pour 1M de tokens | 2 $ pour 1M de tokens |
| Prix de sortie standard | 10 $ pour 1M de tokens | 10 $ pour 1M de tokens |
| Prix de lecture du cache | 0,20 $ pour 1M de tokens | 0,10 $ pour 1M de tokens |
| Fenêtre de contexte | Vérifiez la plateforme Claude sélectionnée | 1 050 000 tokens |
| Sortie maximale | Vérifiez la plateforme Claude sélectionnée | 128 000 tokens |
| Objectif annoncé | Codage bien délimité et tâches professionnelles | Codage complexe, utilisation de l’ordinateur et travail professionnel |
| Contrôle du raisonnement | Effort ajustable | Faible, moyen, élevé, xhigh et max |
| Nom du modèle API | claude-sonnet-5-5 |
gpt-6.1-sol |
Les chiffres de GPT-6.1 Sol proviennent de la documentation des modèles d’OpenAI. Les prix et le positionnement de Sonnet 5.5 proviennent de l’annonce de lancement d’Anthropic. Les prix pour les contextes longs, le traitement par lots, les modes rapides, l’écriture dans le cache, les appels d’outils et les conditions des fournisseurs cloud peuvent faire varier le coût final.
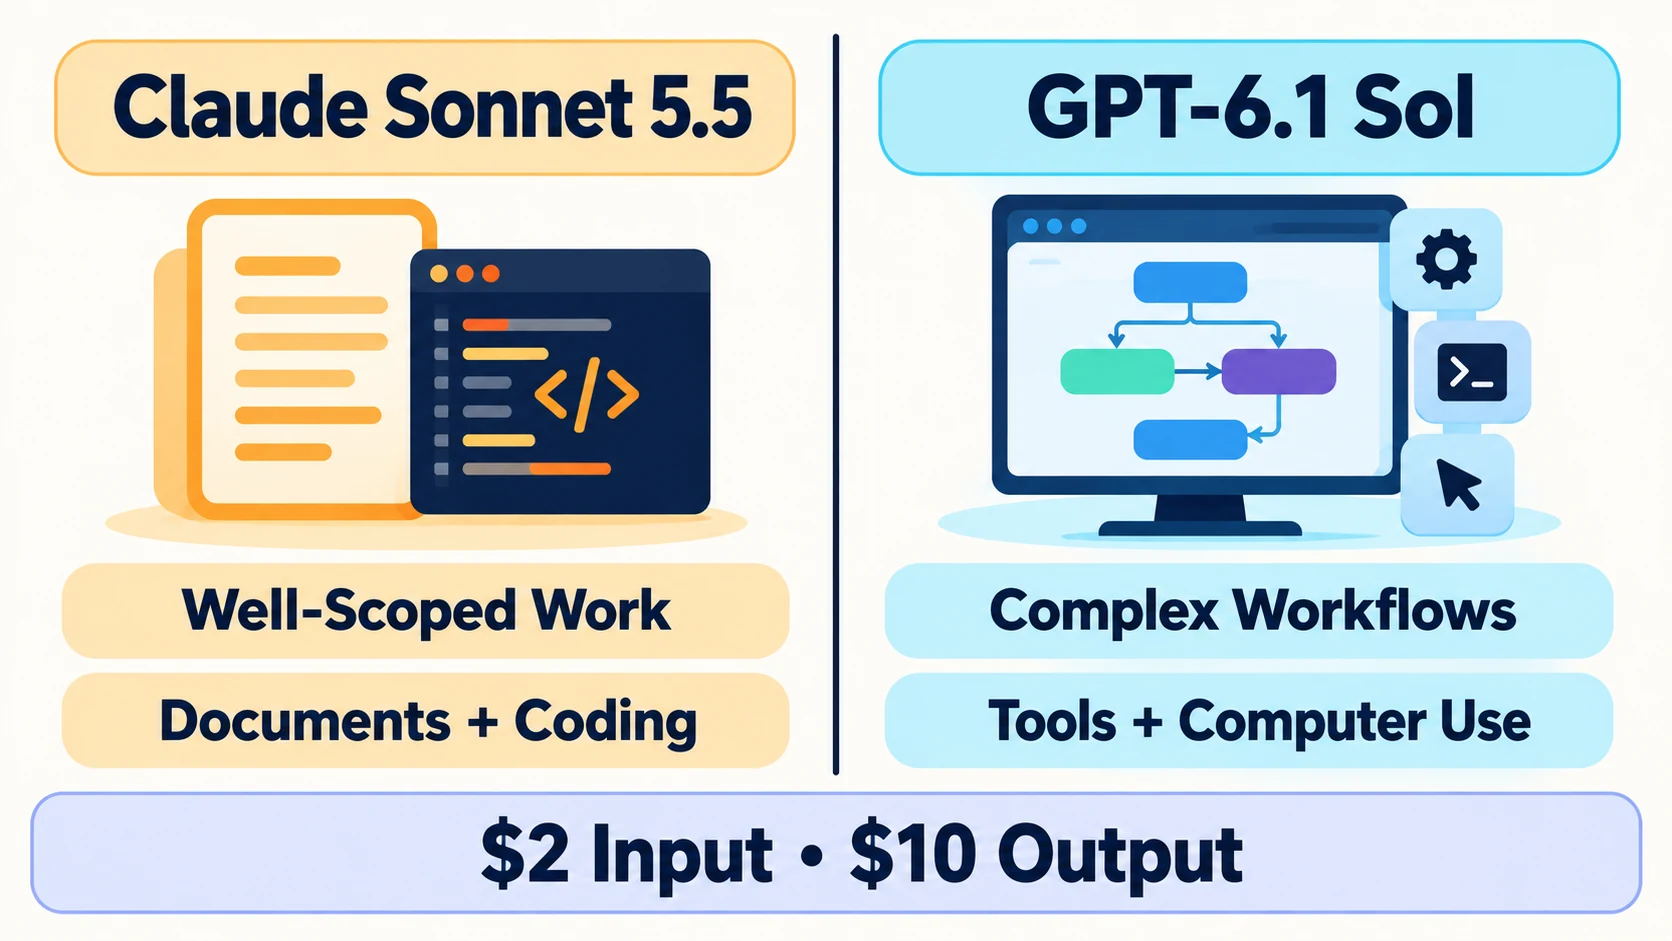
Codage : le contrôle du périmètre compte autant que la puissance brute
Anthropic présente Sonnet 5.5 comme un modèle rapide pour le travail professionnel quotidien, les corrections de bugs et les tâches clairement délimitées. Ses supports de lancement rapportent de solides résultats en codage, notamment 70,6 % sur Terminal-Bench 4.0 et 46,2 % avec Effort max sur FrontierCode 1.1 Main.
GPT-6.1 Sol est conçu pour le codage complexe et les travaux de type agentic. OpenAI lui donne aussi accès à l’exécution de code, à un shell hébergé, à l’application de patch, à l’utilisation de l’ordinateur et à d’autres outils via l’API Responses.
Ces faits ne suffisent pas à désigner un gagnant universel. Une évaluation du codage doit utiliser le même dépôt, les mêmes instructions, le même environnement et le même budget de temps. Vérifiez si le modèle a trouvé la bonne cause, n’a modifié que les fichiers nécessaires, a effectué les contrôles appropriés et s’est arrêté une fois la tâche terminée.
Choisissez Sonnet 5.5 pour un essai lorsque la tâche est bornée et que des itérations rapides importent. Choisissez GPT-6.1 Sol pour un essai lorsque le travail requiert un contexte plus large du dépôt, une coordination des outils, ou plusieurs étapes d’implémentation et de vérification.
Documents et travail de connaissance
Sonnet 5.5 est explicitement positionné pour la création de documents soignés, de slides et de tableurs. Les preuves de lancement d’Anthropic mettent aussi l’accent sur le travail de connaissance professionnel et sur une efficacité améliorée par rapport à Sonnet 5.
GPT-6.1 Sol propose une fenêtre de contexte documentée de 1 050 000 tokens et jusqu’à 128 000 tokens en sortie. Cela en fait une option intéressante pour de grands ensembles de documents, la synthèse de recherche, la revue de politiques et des livrables structurés détaillés.
La capacité de contexte, à elle seule, ne prouve pas la qualité des documents. Testez les deux modèles avec le même paquet source : demandez-leur d’extraire des chiffres, de concilier des passages contradictoires, de distinguer les preuves des inférences, et d’indiquer d’où vient chaque conclusion. Le modèle qui produit un résultat plus facilement auditables peut être plus utile que celui qui rédige la première version la plus fluide.
Outils et adéquation au workflow
L’avantage le plus clair de GPT-6.1 Sol est la surface d’outils documentée via l’API Responses. Il prend en charge la recherche web, la recherche de fichiers, la génération d’images, l’exécution de code, le shell hébergé, l’utilisation de l’ordinateur, MCP et la recherche d’outils. Cela peut réduire la friction d’intégration pour les équipes qui construisent déjà sur le socle agent d’OpenAI.
Sonnet 5.5 est disponible via les produits Claude, la plateforme Claude, AWS, Google Cloud et Microsoft Azure. Il peut mieux convenir lorsque votre organisation utilise déjà ces environnements, ou lorsque ses prompts et ses évaluations sont ajustés pour Claude.
L’écosystème de la plateforme autour du modèle compte. La journalisation, les permissions, la gestion des sources, les étapes de revue, les exigences en données et le workflow de l’équipe peuvent peser plus lourd qu’une petite différence dans un benchmark.
Les lecteurs qui souhaitent le point de référence plus tôt peuvent consulter le comparatif Claude Sonnet 5.5 vs GPT-6 de iWeaver avant d’évaluer ce que la mise à jour 6.1 change.
Coût : même prix par token, coût de tâche différent
Les deux modèles affichent des prix standard de 2 $ pour un million de tokens d’entrée et 10 $ pour un million de tokens de sortie. Cela ne signifie pas qu’ils coûtent la même chose pour mener une tâche à terme.
Le coût total d’une tâche inclut la taille du prompt, le comportement du cache, l’effort de raisonnement, les appels d’outils, les reprises, la longueur de la sortie et la revue humaine. Anthropic affirme que Sonnet 5.5 peut utiliser moins de tokens et s’exécuter plus vite que Sonnet 5, mais il s’agit d’une comparaison avec son prédécesseur—ce n’est pas une preuve qu’il est moins cher que GPT-6.1 Sol.
Mesurez le coût total pour obtenir un résultat acceptable. Un modèle nécessitant moins de corrections peut coûter moins cher même si une réponse individuelle est plus longue.
Quel modèle devriez-vous choisir ?
Essayez Claude Sonnet 5.5 lorsque votre priorité est un codage bien délimité, des itérations rapides, ou des documents soignés et des sorties de type “bureautique”. Les preuves publiques les plus solides et le positionnement produit de Sonnet 5.5 s’alignent avec ces types de tâches.
Essayez GPT-6.1 Sol quand vous avez besoin d’une fenêtre de contexte large, de l’écosystème d’outils d’OpenAI, d’un travail complexe en plusieurs étapes, ou d’une alternative moins coûteuse à Astra. C’est aussi l’option la plus naturelle lorsque votre application s’appuie déjà sur l’API Responses.
Pour une décision équitable, exécutez trois tâches représentatives plutôt qu’un prompt générique : une tâche routinière, une tâche difficile et une tâche riche en sources. Évaluez la justesse, l’exhaustivité, la latence, le total de tokens, les changements inutiles et le temps de revue.
Vous pouvez démarrer un essai gratuit de GPT-6.1 Sol dans iWeaver et l’évaluer avec vos propres documents ou votre workflow de recherche. Le meilleur modèle est celui qui répond à votre niveau de qualité avec le moins d’effort total—pas celui qui affiche le plus grand titre en une.