
Kimi K3.1 Pro affiche des taux de base d’entrée et de sortie via l’API plus bas que Claude Opus 5.5. Le meilleur choix dépend toutefois de la tâche : le nombre de tentatives, les corrections et les relectures humaines peuvent compter davantage que le taux par token.
Les deux modèles sont orientés vers le codage complexe et le travail de connaissance. Cette comparaison s’appuie sur la documentation officielle et des résultats publiés par les fournisseurs, plutôt que sur un test pratique indépendant. L’objectif est de vous aider à choisir une évaluation utile, puis de prendre une décision à partir du travail qu’elle produit.
Tarification API : comparer le même type d’usage
Pour le contexte de lancement à l’origine de cette comparaison, voir les nouvelles capacités de Kimi K3.1 Pro.
Les taux en dollars américains suivants ont été vérifiés le 24 octobre 2026 :
| Par million de tokens | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Entrée de base | 2 $ | 4 $ |
| Sortie de base | 10 $ | 20 $ |
| Cache hit/lecture | 0,20 $ | 0,20 $ |
Il s’agit de tarifs API. Les abonnements grand public, les services tiers et les modes accélérés suivent des conditions distinctes.
Prenons une requête hypothétique de 100 000 tokens d’entrée non mis en cache et 10 000 tokens de sortie. Avec ces taux de base, l’entrée et la sortie coûteraient 0,30 $ avec K3.1 Pro et 0,60 $ avec Opus 5.5. Ce calcul exclut les écritures de cache, les outils, les tentatives et les autres frais. Il illustre l’écart de taux ; ce n’est pas un coût de tâche mesuré.
Pour les tâches répétées, consignez la facture complète et le temps nécessaire pour atteindre un résultat accepté. Une requête moins chère peut devenir un workflow plus coûteux si elle exige de nombreuses corrections. Une requête plus chère doit justifier son prix par le résultat qu’elle fournit.
Codage : aller au-delà d’un score de benchmark de proximité
Le rapport de lancement de Kimi positionne K3.1 Pro à proximité d’Opus 5.5 sur Terminal-Bench 4.0. Ces résultats sont la preuve d’un dispositif d’évaluation donné, plutôt qu’une garantie pour votre dépôt.
Pour une comparaison de codage utile, choisissez une tâche avec un échec connu et un test d’acceptation clair. Donnez à chaque modèle le même état de projet, la même description du problème, l’accès aux outils et le même budget temps. Conservez des copies distinctes pour qu’une exécution ne puisse pas tirer parti des changements de l’autre.
Après chaque exécution, examinez trois éléments : si le problème est résolu, si un comportement sans rapport a changé, et si l’explication correspond à la modification réelle. Notez toute intervention manuelle. Si un modèle a besoin d’un indice à mi-parcours, cette intervention doit figurer dans le résultat.
Une petite correction d’interface et un test de refactor sur plusieurs fichiers évaluent des capacités différentes. Incluez les deux uniquement si elles correspondent à votre charge de travail. Une seule démo réussie est trop étroite comme base pour faire évoluer l’ensemble d’un workflow d’ingénierie.
Analyse documentaire : vérifier si les conclusions résistent aux vérifications
Pour un travail de recherche, la comparaison devrait inclure une question qui ne peut pas être résolue en résumant un seul document. Utilisez une collection de sources comportant une figure obsolète, une affirmation qualifiée ou un désaccord apparent.
Essayez la même question avec les deux modèles :
Comparez les rapports fournis. Identifiez les affirmations qui concordent, celles qui entrent en conflit et celles qui ne peuvent pas être conciliées à partir des éléments de preuve disponibles. Citez la source et l’emplacement de chaque élément. Séparez les faits rapportés de votre interprétation.
Passez en revue les réponses sans regarder d’abord les libellés du modèle. Comptez les affirmations non étayées et les qualifications manquées. Vérifiez si l’un ou l’autre modèle résout un désaccord en inventant une explication.
Si vous utilisez iWeaver pour préparer la collection de sources, le AI Document Summarizer peut vous aider à établir un aperçu. Gardez les entrées de comparaison réelles cohérentes ; fournir à un modèle un résumé sélectionné et à l’autre des fichiers bruts crée une expérience différente.
Quand faut-il évaluer K3.1 Pro en premier ?
Utilisez Comment utiliser Kimi K3.1 Pro pour configurer une première tâche et vérifier le résultat.
Commencez par K3.1 Pro quand les taux API plus bas indiqués répondent à une contrainte de coût réelle et que vous disposez d’une tâche répétable à tester. C’est également un choix raisonnable lorsque l’orientation « codage » et « recherche » de la nouvelle version correspond au travail que vous devez accomplir.
Kimi K3.1 Pro est disponible dans iWeaver, et iWeaver propose un essai gratuit du modèle. Une tâche documentaire bornée constitue une première évaluation pratique : choisissez des sources que vous comprenez, précisez la sortie attendue et vérifiez les affirmations qui en découlent.
Les conditions d’essai n’établissent pas le coût d’utilisation de l’API de Kimi. Évaluez chaque mode d’accès selon ses propres conditions.
Quand faut-il conserver Opus 5.5 dans la comparaison ?
Avant de payer pour la sortie accélérée, examinez Kimi K3.1 Pro vs. Highspeed pour distinguer la vitesse de la qualité de la tâche.
Gardez Opus dans l’évaluation lorsque vous disposez déjà d’un workflow qui fonctionne bien avec lui. Un processus établi a de la valeur : les prompts, les outils, les habitudes de relecture et les sorties acceptées prennent du temps à reconstruire.
Testez K3.1 Pro sur un échantillon représentatif avant de basculer. Incluez une tâche ordinaire, une tâche difficile et un cas que votre workflow actuel gère mal. Un nouveau modèle est le plus utile lorsqu’il résout un problème concret ou réduit le coût d’un résultat accepté.
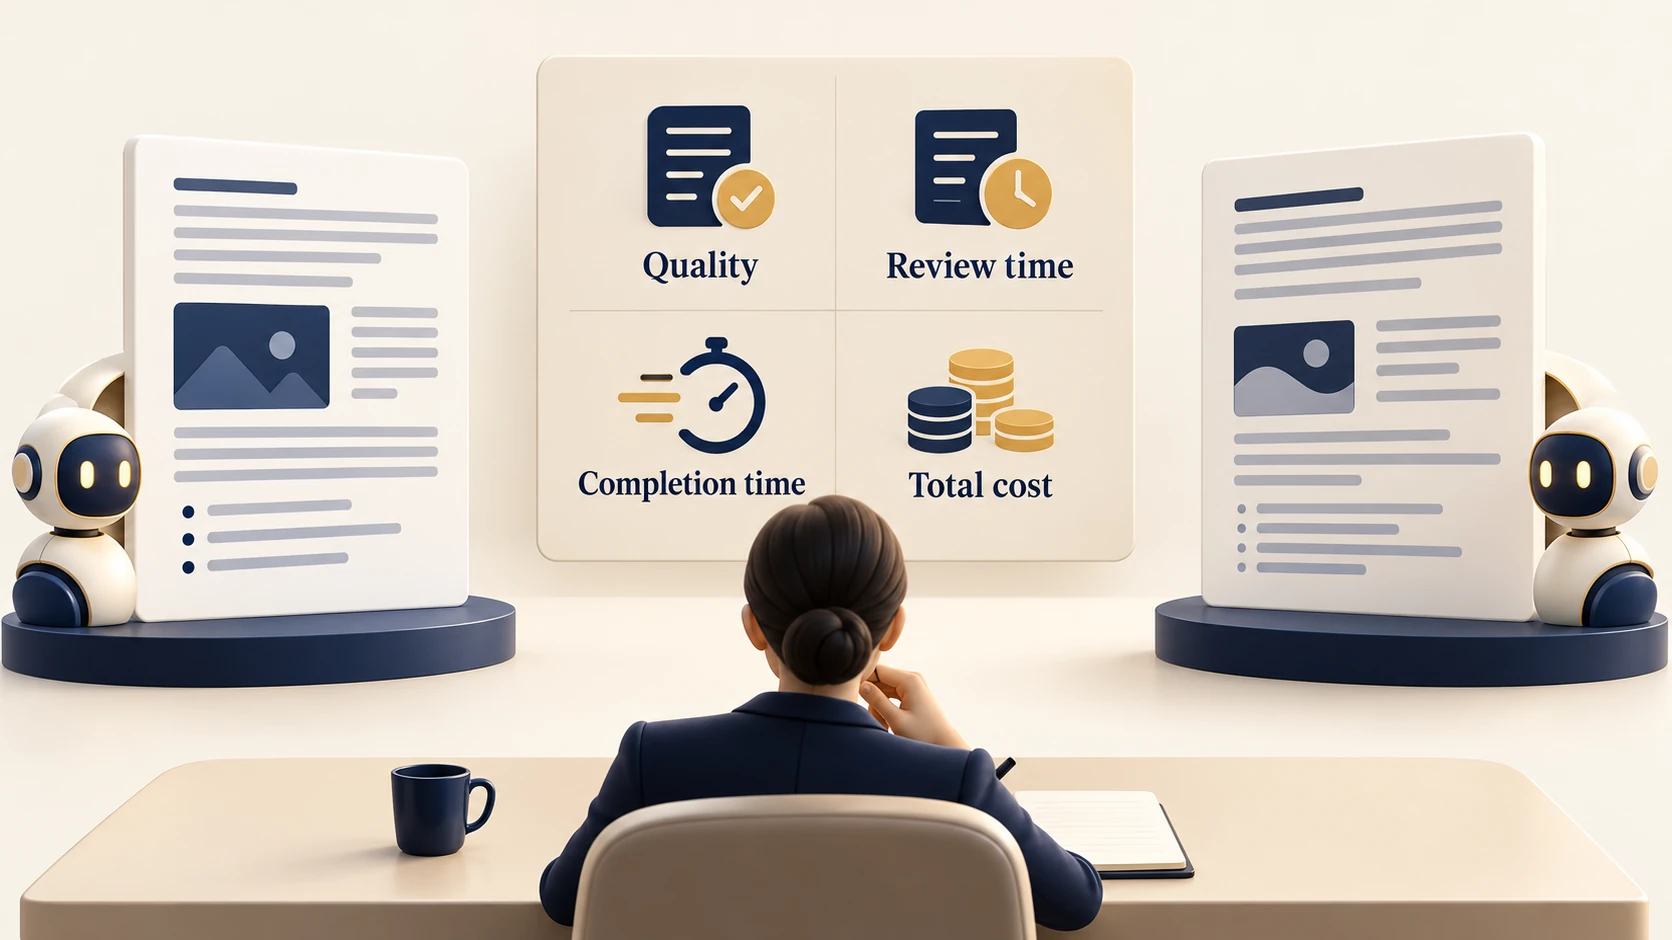
Pour un choix final, utilisez un tableau de bord simple : sortie acceptée, temps de correction, temps d’achèvement et coût total. Pesez ces facteurs selon le poste. Une équipe de recherche mettra peut-être la qualité des preuves en premier ; un système de traitement par lots se souciera davantage du coût une fois qu’un seuil minimal de qualité est atteint.
Il n’est pas nécessaire de déclarer un modèle gagnant sur toutes les tâches. Choisissez K3.1 Pro lorsqu’il délivre un meilleur résultat selon vos contraintes, et conservez Opus lorsque votre évaluation soutient le fait de le garder.