
Kimi présente K3.1 Pro Highspeed comme la version plus rapide de K3.1 Pro, avec les mêmes capacités du modèle. Ses taux d’entrée et de sortie de base via l’API indiqués sont deux fois supérieurs à ceux de la version standard. Le choix consiste donc à savoir si la sortie plus rapide supprime suffisamment d’attente dans votre flux de travail pour justifier cet écart.
Pour un lot non surveillé, le modèle standard est un point de départ logique. Pour un travail interactif avec de nombreuses révisions, Highspeed mérite une comparaison chronométrée. Mesurez la tâche complète, y compris les outils et la relecture, avant de décider.
Ce que changent les deux versions
Pour le contexte de déploiement plus large, voir les capacités et la disponibilité de Kimi K3.1 Pro.
| Facteur | K3.1 Pro | K3.1 Pro Highspeed |
|---|---|---|
| Positionnement fournisseur | Version standard | Mêmes capacités, sortie plus rapide |
| Vitesse de sortie annoncée | Référence | Environ 2–3× la référence |
| Entrée API de base par million de tokens | 2 $ | 4 $ |
| Sortie API de base par million de tokens | 10 $ | 20 $ |
La vitesse est une affirmation du fournisseur, pas une mesure réalisée dans cet article. Les tarifs de l’API et les quotas du plan Coding relèvent de mécanismes de facturation différents.
Une variante plus rapide ne doit pas être décrite comme une mise à niveau distincte de l’intelligence. Évaluez sa valeur à travers la réactivité et le travail effectivement terminé. Vous devez toujours vérifier le contenu des réponses des deux versions.
Un exemple de coût simple
Supposons qu’une requête utilise 50 000 tokens d’entrée non mis en cache et 5 000 tokens de sortie. Aux tarifs de base indiqués, l’entrée + la sortie coûtera :
- K3.1 Pro : 0,10 $ pour l’entrée + 0,05 $ pour la sortie, soit 0,15 $ au total.
- Highspeed : 0,20 $ pour l’entrée + 0,10 $ pour la sortie, soit 0,30 $ au total.
Il s’agit d’un calcul hypothétique. Il exclut les écritures de cache, les outils, les tentatives (retries) et les autres frais. Il suppose aussi un nombre égal de tokens, ce qu’une évaluation réelle devrait mesurer plutôt que présumer.
Les 0,15 $ supplémentaires peuvent valoir le coup si cela vous fait gagner un temps significatif pendant la tâche. Cela peut ajouter peu de valeur si vous envoyez le travail pendant la nuit et revenez le lendemain matin. La même différence de taux peut mener à des décisions différentes selon le moment où vous avez besoin de la réponse.
Une sortie plus rapide ne signifie pas que chaque tâche se termine trois fois plus vite
Une tâche assistée par des outils peut inclure plusieurs types d’attente : génération du modèle, récupération de documents, exécution de code, services externes et relecture humaine. L’affirmation de vitesse de sortie de Highspeed ne prouve pas une réduction équivalente sur l’ensemble de la séquence.
Prenons une tâche illustrative qui dure dix minutes, dont six minutes pour générer la sortie du modèle et quatre minutes consacrées au reste. Même si la génération devenait trois fois plus rapide, la durée totale passerait à six minutes : deux minutes de génération plus les quatre minutes inchangées. Il s’agit d’un gain utile, mais ce n’est pas une réduction par trois de la durée totale.
Cet exemple est un calcul, pas un résultat observé de Kimi. Son objectif est de vous aider à déterminer ce que vous devriez chronométrer dans votre propre flux de travail.
Si la majorité du retard vient de l’exécution d’une longue suite de tests ou de l’attente d’un service de recherche, traitez d’abord ce goulot d’étranglement avant de supposer qu’un point d’accès de modèle plus rapide va le résoudre.
Quand Highspeed vaut la peine d’être testé
Pour une comparaison entre différentes familles de modèles, lisez Kimi K3.1 Pro vs. Claude Opus 5.5.
Highspeed est surtout pertinent lorsque vous êtes présent et que vous attendez à répétition que le modèle continue. Les exemples incluent la révision d’une explication, l’exploration de plusieurs options d’implémentation ou l’affinage d’une section de document, étape par étape.
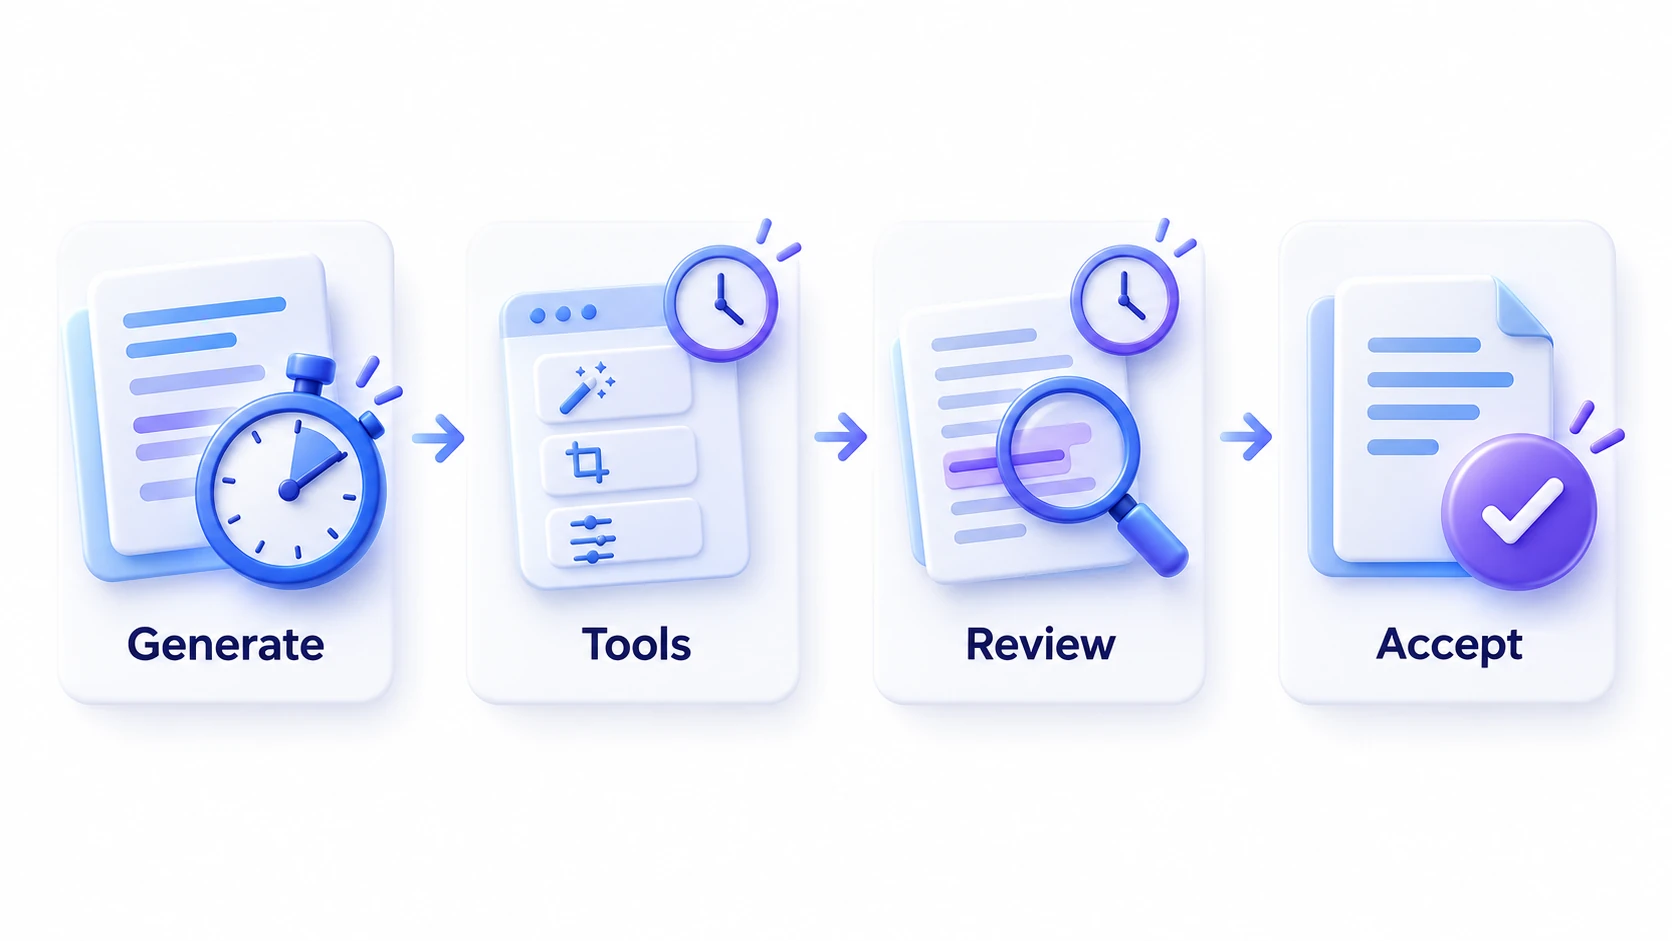
Faites passer la même tâche représentative dans les deux variantes. Notez le moment où vous la soumettez, quand la réponse utile devient disponible, et quand vous acceptez le résultat final. Comptez les révisions et incluez tout le temps passé à corriger les erreurs.
Recommencez avec plus d’une tâche. Une réponse courte peut sembler similaire sur les deux versions, tandis qu’une réponse longue peut révéler une différence plus importante. Évaluez le gain par rapport au coût additionnel réel via le service que vous avez choisi.
Quand la version standard suffit
Si vous êtes encore en train de passer du modèle plus ancien, commencez par Kimi K3.1 Pro vs. Kimi K3.
Commencez par K3.1 Pro standard quand vous pouvez attendre la fin sans interrompre d’autres travaux. Par exemple : une relecture de document en file d’attente, un résumé de recherche programmé, ou une expérience où la qualité de la réponse est la question principale.
Préférez aussi un point de départ plus simple lorsque vous n’avez pas encore appris à cadrer la tâche. Une génération plus rapide ne résout pas une demande ambiguë ni l’absence de matériel source. Améliorez les consignes, vérifiez les preuves, puis décidez si la réactivité reste un problème.
Kimi K3.1 Pro est disponible dans iWeaver, et iWeaver propose un essai gratuit du modèle. Cette affirmation ne prouve pas la disponibilité de Highspeed ni ses conditions d’essai. Vérifiez la liste des modèles du service et l’offre actuelle avant de planifier autour d’une variante particulière.
Pour le travail sur les documents, l’AI Document Summarizer peut aider à établir un aperçu initial clair. Utilisez cet aperçu pour affiner la question à laquelle vous souhaitez que le modèle réponde.
Utilisez une règle de seuil pratique
Pour votre évaluation personnelle, comparez le coût additionnel avec la valeur du temps réellement économisé. Un calcul utile est :
Coût additionnel du modèle ÷ minutes d’attente active économisées = coût par minute économisée.
Gardez la qualité comme exigence minimale. Une réponse qui arrive plus tôt mais nécessite plus de corrections n’a pas forcément fait gagner du temps.
Choisissez Highspeed quand la réduction mesurée de l’attente améliore votre façon de travailler et correspond à votre budget. Conservez K3.1 Pro standard lorsqu’il respecte l’échéance à un coût plus bas. Reprenez votre décision si la composition de vos tâches, les conditions d’accès ou la tarification changent.