
Claude Opus 5.5 e la famiglia OpenAI’s GPT-6 sono ora in competizione per molte delle stesse impegnative attività di AI, ma adottano approcci diversi.
Anthropic posiziona Claude Opus 5.5 attorno a una programmazione agentic che può durare a lungo e a lavori di knowledge professionali. OpenAI divide GPT-6 su tre modelli: Astra per le attività end-to-end più difficili, Sol per la programmazione complessa e per gli agent, e Luna per carichi di lavoro focalizzati ad alto volume.
Quindi il confronto utile non è più semplicemente Claude vs GPT.
È:
Claude Opus 5.5 vs GPT-6 Astra, Sol e Luna—quale modello si adatta davvero al tuo carico di lavoro?
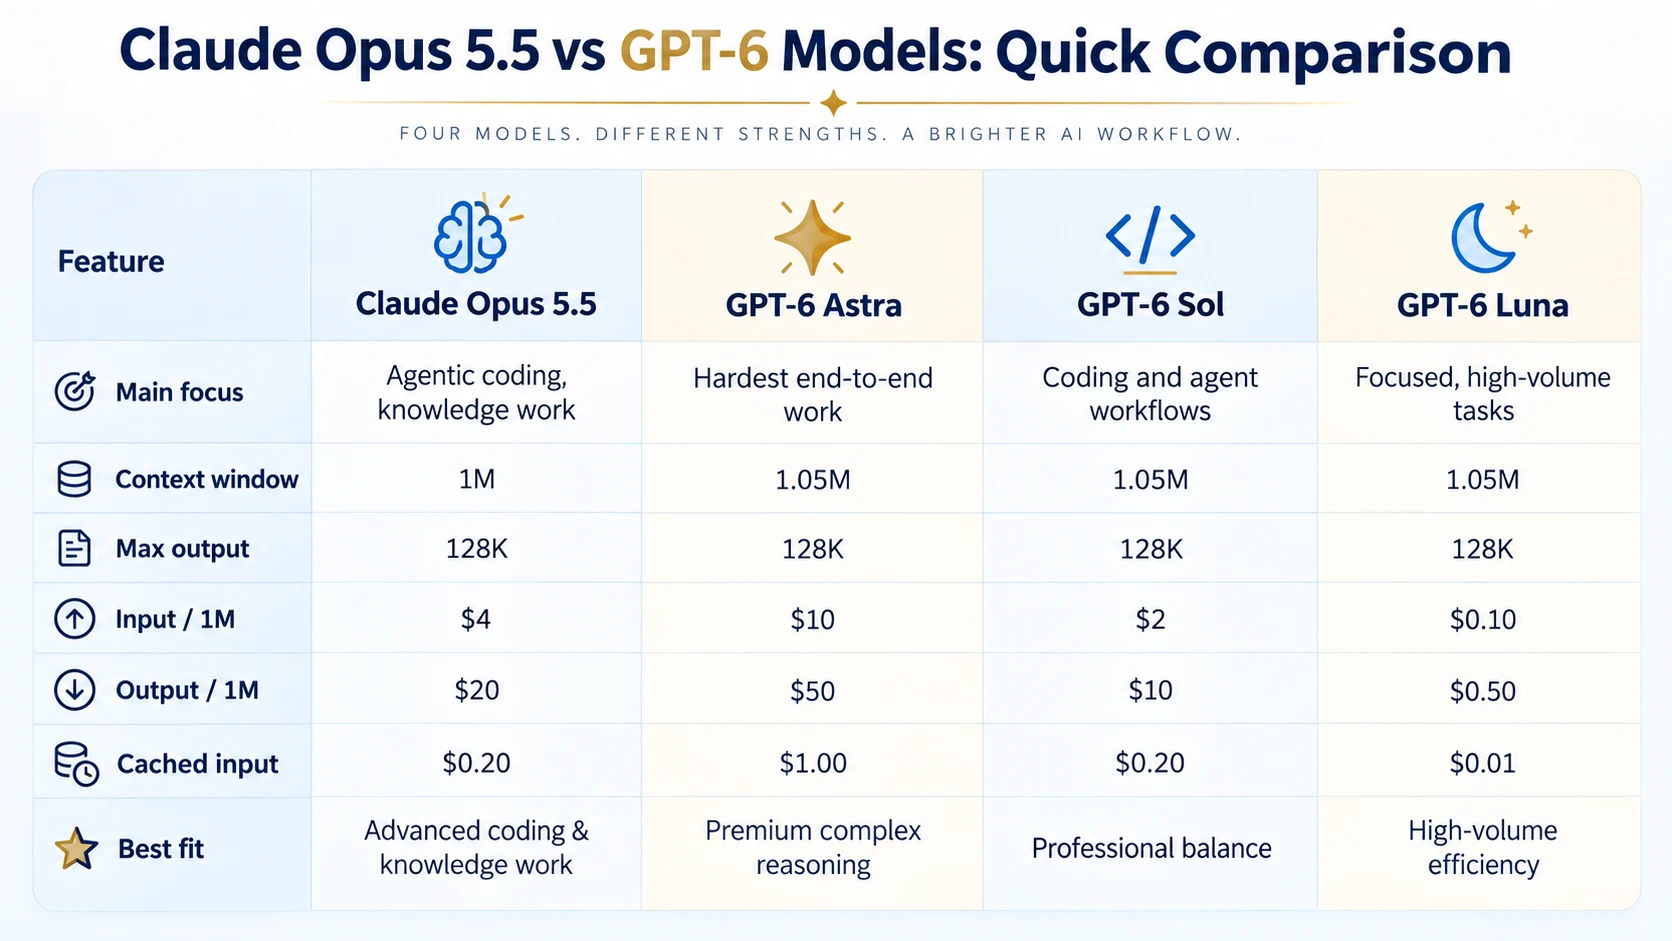
Claude Opus 5.5 vs GPT-6 in breve
| Funzionalità | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| Focus principale | Programmazione agentic, lavoro di conoscenza | Lavoro end-to-end più difficile | Codifica e flussi di agent | Attività focalizzate ad alto volume |
| Finestra di contesto | 1M | 1.05M | 1.05M | 1.05M |
| Output massimo | 128K | 128K | 128K | 128K |
| Input / 1M | $4 | $10 | $2 | $0.10 |
| Output / 1M | $20 | $50 | $10 | $0.50 |
| Input in cache | $0.20 | $1.00 | $0.20 | $0.01 |
| Knowledge cutoff | Giugno 2026 | 30 Aprile 2026 | 20 Aprile 2026 | 18 Maggio 2026 |
Claude Opus 5.5 supporta una finestra di contesto da 1M-token e un output standard da 128K, mentre tutti e tre i modelli GPT-6 offrono una finestra di contesto leggermente più grande da 1.05M con lo stesso output massimo di 128K.
Claude Opus 5.5 vs GPT-6 Astra
GPT-6 Astra è il confronto diretto più vicino a Claude Opus 5.5 quando il task coinvolge ragionamenti difficili, programmazione, ricerca o agent che durano a lungo.
OpenAI descrive Astra come il suo modello più capace per il lavoro end-to-end più difficile, incluse ragioni complesse, coding, uso del computer, ricerca e creazione di documenti. Anthropic descrive Opus 5.5 come un modello per la programmazione agentic che dura a lungo e per il lavoro di knowledge.
La differenza pratica più grande è il prezzo.
Claude Opus 5.5 costa:
- $4 / 1M token di input
- $20 / 1M token di output
GPT-6 Astra costa:
- $10 / 1M token di input
- $50 / 1M token di output
Alle tariffe standard pubblicate, Opus 5.5 quindi costa il 60% in meno per token di input e output rispetto ad Astra.
Astra offre comunque una finestra di contesto leggermente più grande—1.05M contro 1M—ma quella differenza è relativamente piccola rispetto al divario di prezzo.
Cosa mostrano i benchmark?
I risultati pubblicati da Anthropic per Opus 5.5 includono confronti diretti con GPT-6 Astra.
Nelle prove di Anthropic, Opus 5.5 ha ottenuto punteggi più alti nei benchmark tra cui Terminal-Bench 4.0 e FrontierCode v1.1, mentre GPT-6 Astra ha ottenuto punteggi più alti in test come AutomationBench e Terminal-Bench-Science 0.1. Anthropic sottolinea anche che le differenze nei benchmark dovrebbero essere interpretate con attenzione, perché le condizioni di test e l’incertezza statistica variano.
Questo rende difficile ridurre il confronto a un singolo punteggio complessivo.
Per i flussi di lavoro reali, il test migliore è spesso se il modello riesce a completare in modo affidabile il tuo task di coding, ricerca o agent—e quanto ti costa quel task completo.
Claude Opus 5.5 vs GPT-6 Sol
GPT-6 Sol potrebbe essere in realtà l’alternativa più interessante a Opus 5.5 per molti utenti professionali.
Entrambi i modelli sono posizionati esplicitamente attorno a programmazione e flussi di agentic.
Ma i loro prezzi cambiano:
| Modello | Input / 1M | Output / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
GPT-6 Sol costa la metà per token standard di input e output.
Inoltre offre una finestra di contesto da 1.05M rispetto a quella da 1M di Opus 5.5. Entrambi supportano fino a 128K token di output.
Questo rende Sol un’opzione da considerare per carichi di lavoro frequenti come:
- Coding quotidiano
- Revisione del codice
- Agenti AI
- Flussi di lavoro basati su strumenti
- Ricerca
- Analisi dei documenti
- Automazione del business
Opus 5.5 diventa più interessante quando vuoi l’approccio di reasoning di livello Opus di Anthropic e la sua attenzione a task agentic che durano a lungo, mentre Sol è posizionato come un’opzione più attenta ai costi per attività ricorrenti di coding e agent.
Claude Opus 5.5 vs GPT-6 Luna
Claude Opus 5.5 e GPT-6 Luna puntano a carichi di lavoro molto diversi.
Luna è il modello GPT-6 più efficiente di OpenAI per task focalizzati ad alto volume. Il suo pricing API è solo:
- $0.10 / 1M token di input
- $0.50 / 1M token di output
È ben al di sotto dei prezzi $4 / $20 di Opus 5.5.
Luna ha più senso per task come:
- Classificazione
- Estrazione di informazioni
- Formattazione
- Brevi riassunti
- Elaborazione dei contenuti
- Automazione ripetitiva
Opus 5.5 è rivolto all’altra parte dello spettro: coding complesso, lavoro di knowledge più profondo e task che potrebbero richiedere reasoning sostenuto su molti passaggi.
Quindi non è tanto un confronto diretto tra modelli, quanto una questione di capire se un task richiede davvero un modello avanzato di reasoning.
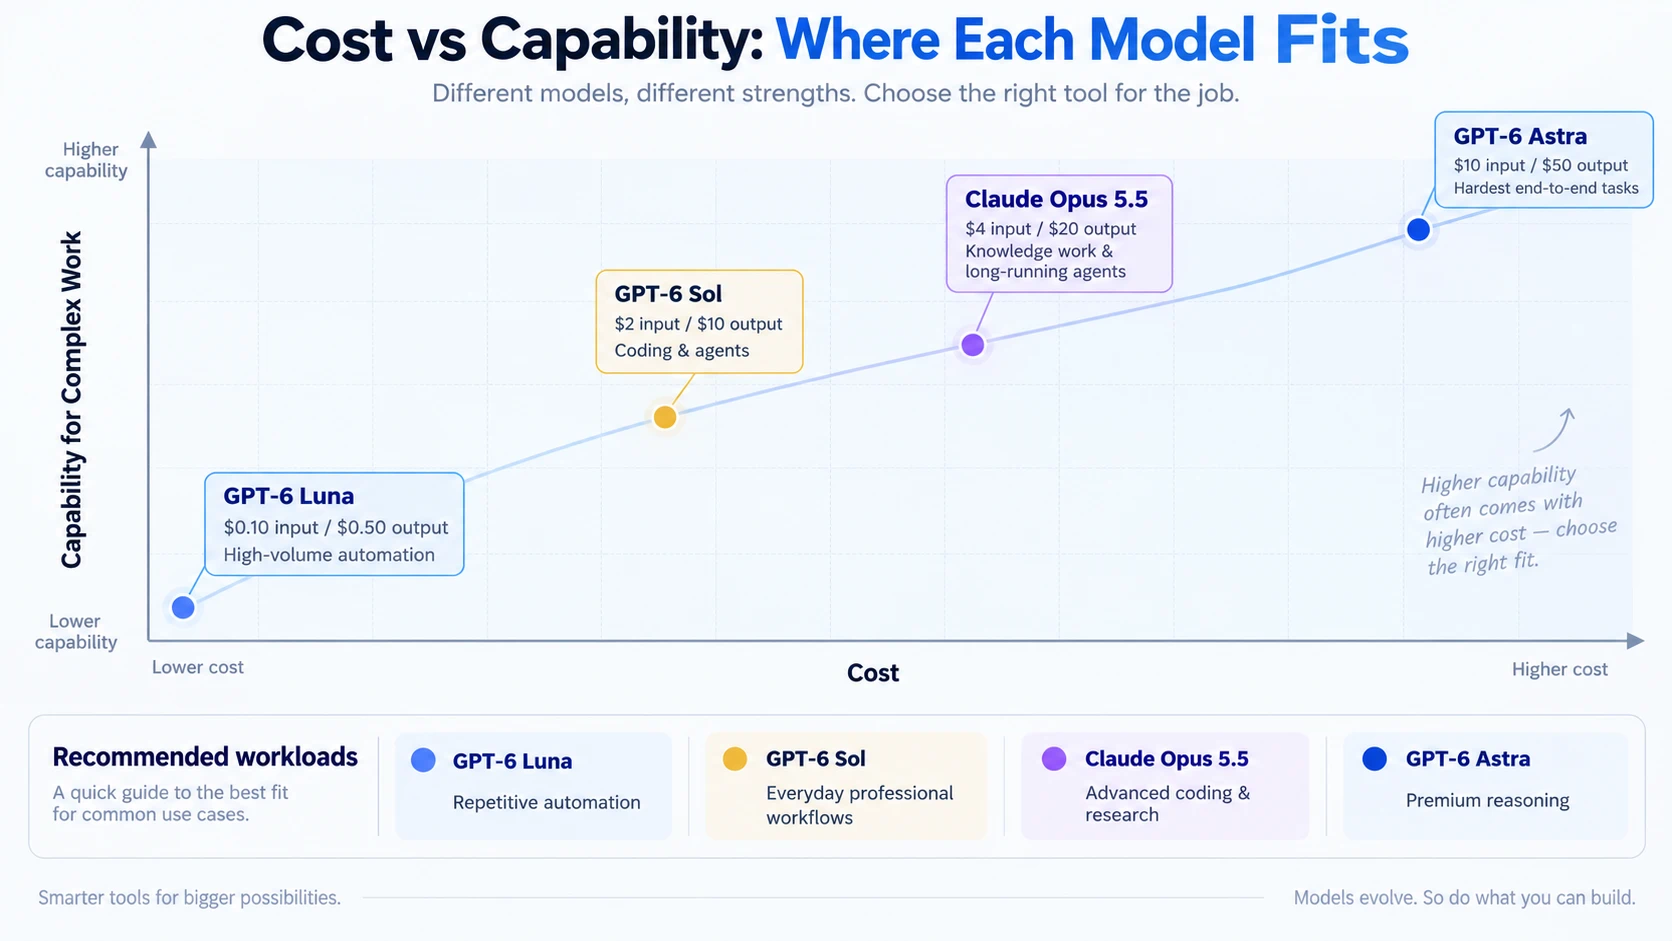
Prezzi: dove si inserisce ogni modello
La scala dei prezzi rende il posizionamento ancora più chiaro.
| Modello | Input | Output | Posizione relativa |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | Efficienza ad alto volume |
| GPT-6 Sol | $2 | $10 | Equilibrio professionale |
| Claude Opus 5.5 | $4 | $20 | Coding avanzato & lavoro di knowledge |
| GPT-6 Astra | $10 | $50 | Ragionamento end-to-end premium |
Questi sono prezzi standard dei token indicati. OpenAI applica un pricing più alto alle richieste GPT-6 con più di 272K token di input, quindi carichi di lavoro con contesto molto lungo possono cambiare il calcolo dei costi.
Anthropic supporta anche il prompt caching su Opus 5.5 a $0.20 per milione di token cache-read, che può fare la differenza per agent che riutilizzano ripetutamente contesti grandi.
Quale modello si adatta a quale task?
Un modo pratico per confrontare i quattro modelli è ragionare per carico di lavoro, non per brand.
| Task | Modelli da testare |
|---|---|
| Ragionamento end-to-end difficile | Claude Opus 5.5 / GPT-6 Astra |
| Progetti di coding di grandi dimensioni | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Agent di lunga durata | Claude Opus 5.5 / GPT-6 Sol / Astra |
| Coding professionale di tutti i giorni | GPT-6 Sol / Claude Opus 5.5 |
| Ricerca e lavoro di knowledge | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Estrazione ad alto volume | GPT-6 Luna |
| Classificazione e formattazione | GPT-6 Luna |
| Automazione ripetitiva | GPT-6 Luna / Sol |
Non c’è alcun motivo per cui ogni passaggio in un flusso di lavoro debba usare lo stesso modello.
Un agent di produzione potrebbe usare Luna per l’estrazione leggera, Sol per i passaggi di reasoning regolari e inoltrare i task particolarmente difficili ad Astra o Opus 5.5.
Questo può contare più sul costo che scegliere un singolo modello per tutto.
Prova Claude Opus 5.5 e la serie GPT-6 su iWeaver
Specifiche e benchmark sono utili, ma non sempre prevedono quale modello funzionerà meglio con i tuoi documenti, prompt o flussi di lavoro.
iWeaver ti consente di provare Claude Opus 5.5 insieme alla serie GPT-6, inclusi GPT-6 Astra, Sol e Luna, senza dover creare integrazioni API separate.
iWeaver offre anche crediti giornalieri gratuiti, così puoi testare lo stesso task reale su modelli diversi—ad esempio:
- Riassumere PDF
- Confrontare più documenti
- Ricerca e analisi
- Scrittura
- Estrazione della conoscenza
- Domande di coding
Eseguire lo stesso task su diversi modelli rende molto più semplice confrontare profondità delle risposte, velocità e utilità rispetto a fare affidamento solo sui numeri dei benchmark.
Se vuoi iniziare specificamente con il modello di punta di OpenAI, consulta la nostra guida su come usare GPT-6 Astra gratuitamente.
Claude Opus 5.5 si trova in una posizione interessante all’interno dell’attuale mercato dei modelli di frontiera.
Costa significativamente meno di GPT-6 Astra, pur puntando su casi d’uso di coding, agent e knowledge work con richieste simili. GPT-6 Sol batte Opus 5.5 sul prezzo e si concentra fortemente su coding e agent, mentre GPT-6 Luna risponde a un’esigenza diversa: elaborazione economica su larga scala.
La domanda utile, quindi, non è semplicemente “Claude Opus 5.5 o GPT-6?”
È se il tuo task richiede reasoning di punta, performance professionali bilanciate o efficienza ad alto volume.
Per questo, testare lo stesso flusso di lavoro su Opus 5.5, Astra, Sol e Luna è spesso più informativo che scegliere solo tra tabelle di benchmark.