
Claude Sonnet 5.5 e Claude Opus 5.5 si distinguono meno per una semplice gerarchia “buono contro migliore” e più per la forma del compito. Anthropic posiziona Sonnet come la scelta più veloce e a basso costo per attività quotidiane ben definite, mentre Opus è pensato per problemi complessi e aperti che richiedono un giudizio accurato su molti passaggi. Sonnet costa la metà per token standard di input e output, eppure si avvicina sorprendentemente a Opus in diverse valutazioni pubblicate.
Un benchmark può mostrare se un modello è riuscito in un contesto controllato, ma potrebbe non catturare quanto affidabilmente il modello gestisca l’ambiguità o mantenga a mente vincoli concorrenti durante un progetto lungo. Scegliere tra i due è una decisione di instradamento: usa il modello meno costoso che soddisfa i requisiti di qualità e rischio del compito.
Sonnet 5.5 vs Opus 5.5: panoramica rapida
| Dettaglio | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Data di rilascio | 28 settembre 2026 | 22 settembre 2026 |
| Prezzo input standard | 2$ per 1M token | 4$ per 1M token |
| Prezzo output standard | 10$ per 1M token | 20$ per 1M token |
| Prezzo lettura cache | 0,20$ per 1M token | 0,20$ per 1M token |
| Prezzo scrittura cache | 2,50$ per 1M token | 5$ per 1M token |
| Ruolo dichiarato | Lavoro veloce e ben definito per uso quotidiano | Lavoro complesso che richiede giudizio continuato |
| Nome modello API | claude-sonnet-5-5 |
claude-opus-5-5 |
I dati sopra provengono dalle comunicazioni ufficiali di Anthropic per Sonnet 5.5 e Opus 5.5. Si tratta di tariffe API standard; modalità veloce, inferenza regionale, piattaforme cloud e accesso in abbonamento possono seguire regole di prezzo o utilizzo diverse.
Cosa mostrano davvero i benchmark
Sonnet 5.5 è molto vicino a Opus 5.5 in diverse valutazioni riportate da Anthropic, ma il vantaggio cambia a seconda del compito. Ed è esattamente per questo che i due modelli non dovrebbero essere ridotti a un singolo punteggio.
| Benchmark | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 66,4% |
| FrontierCode 1.1 Main | 46,2% al Max | 54,4% |
| CursorBench 4.0 | 55,5% | 57,8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
Sonnet è in vantaggio nel risultato pubblicato di Terminal-Bench, mentre Opus guida su FrontierCode, CursorBench, GDPval-AA e AA-Briefcase. Il piccolo divario di GDPval-AA è significativo, ma Anthropic afferma esplicitamente che Opus resta chiaramente più forte, sia nelle proprie valutazioni sia in quelle di tester esterni, nei lavori complessi e aperti che richiedono giudizio continuato. Anche le configurazioni dei benchmark e le impostazioni di impegno differiscono, quindi un gap numerico di due punti non dovrebbe essere scambiato per una sentenza completa sulle capacità.
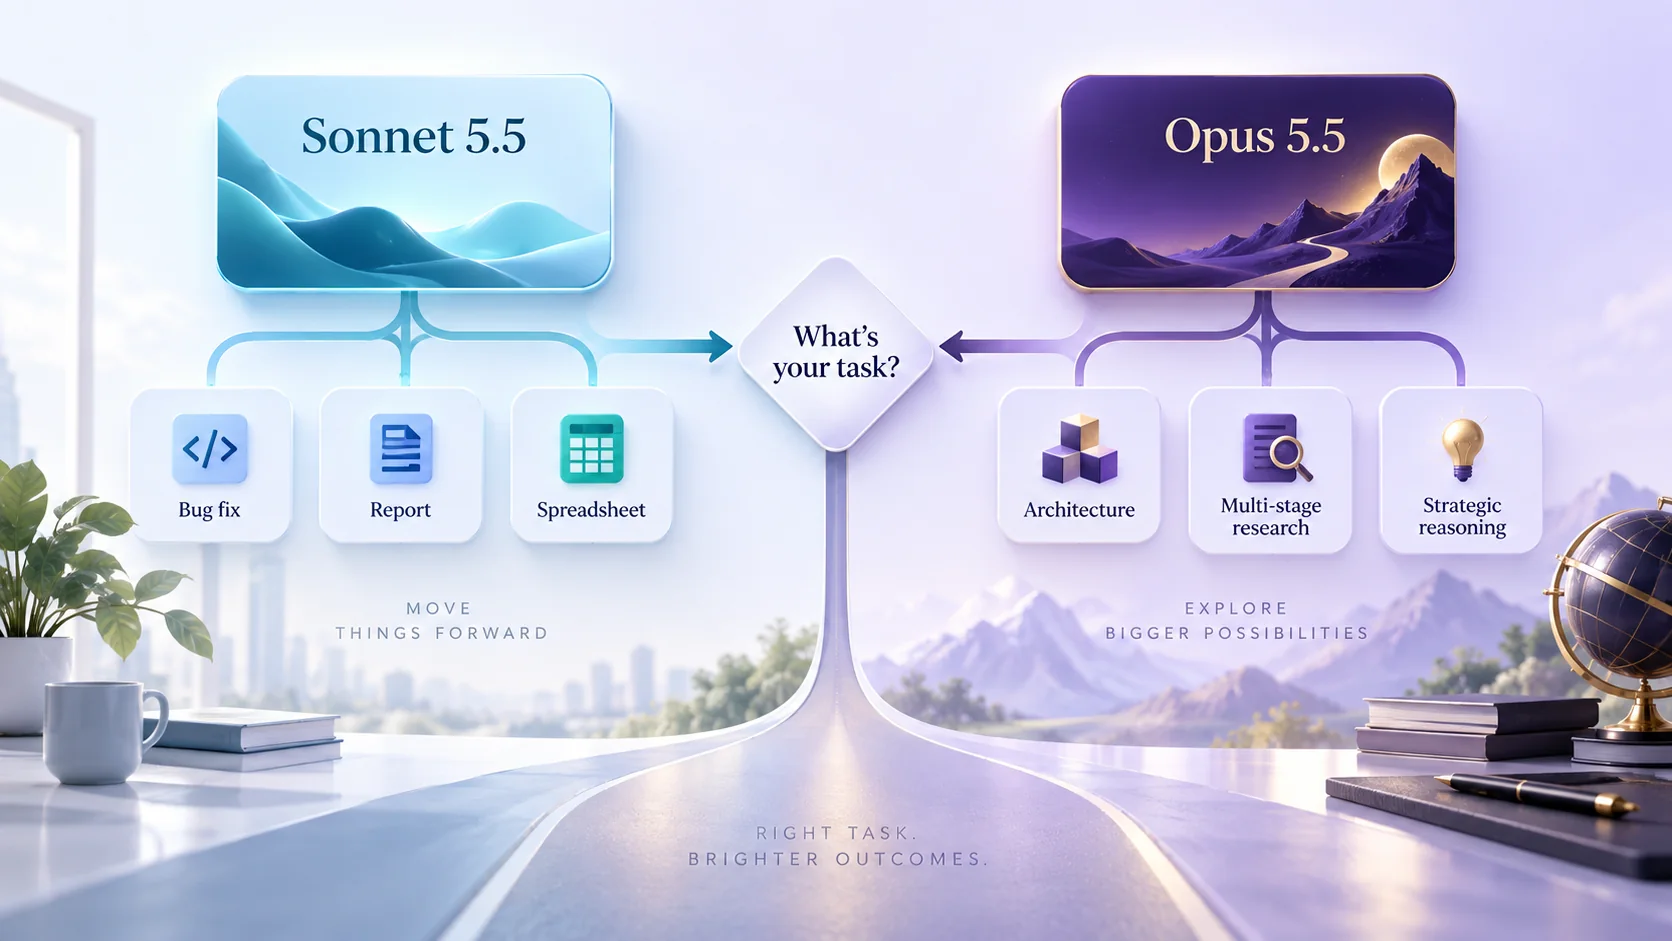
Sonnet ha senso quando il successo può essere descritto in modo chiaro e verificato senza interpretazioni estese. Esempi includono: correggere un bug riproducibile, trasformare un dataset noto, riassumere una raccolta definita di documenti, preparare una presentazione partendo da risultati approvati o applicare una riscrittura coerente su molti file. Questi compiti possono comunque essere impegnativi, ma hanno confini e una linea d’arrivo riconoscibile.
La differenza di prezzo diventa importante su larga scala. I token standard di input e output costano la metà rispetto a Opus, mentre le letture della cache costano uguale. Anthropic afferma anche che Sonnet 5.5 genera output oltre il 30% più velocemente di Sonnet 5, anche se non presenta quella dichiarazione come un confronto diretto con Opus 5.5. I team dovrebbero misurare la latenza sotto il proprio carico invece di presumere che il nome del tier predica il tempo di risposta in ogni ambiente.
Per i flussi di lavoro ricorrenti, l’impegno regolabile di Sonnet può aiutare a controllare i costi. Un impegno più basso può essere adatto per classificazione, formattazione o bozze di routine; un impegno più alto può avere senso per modifiche al codice o analisi che richiedono più verifiche. La pratica importante è impostare test di accettazione e far escalare i casi difficili invece di usare l’impegno massimo per tutto.
Quando Opus 5.5 merita il suo prezzo più alto
Opus è il candidato più valido quando il modello deve definire il problema mentre lavora. Una migrazione di codice complessa, una strategia cross-funzionale, un’indagine multi-stadio o un’analisi ambigua possono richiedere al modello di rivedere le assunzioni, bilanciare i vincoli e mantenere coerenza lungo una lunga catena di azioni. Sono le situazioni a cui Anthropic si riferisce con “giudizio continuato”.
Anche il calcolo del valore cambia in base al rischio. Se un revisore senior deve spendere ore per riparare una risposta plausibile ma sottilmente errata, risparmiare token è stata una falsa economia. Opus può valere la tariffa più alta quando un singolo run di successo evita una notevole re-lavorazione, ma va comunque valutato con criteri espliciti; un’etichetta premium non elimina la necessità di controlli della sorgente, test e approvazione umana.
Codifica: instrada in base all’ambito, non alla reputazione
Per la codifica, inizia dal confine del compito. Sonnet è una scelta predefinita solida per un bug locale, un endpoint ben definito, la generazione di test o un refactor contenuto. Opus è più difendibile per lavori architetturali, coordinamento tra più repository, una migrazione con requisiti incompleti o un’indagine in cui la causa principale è sconosciuta.
Esegui entrambi i modelli su un campione rappresentativo prima di formalizzare l’instradamento. Valuta correttezza, rischio di regressione, modifiche inutili, qualità dei test, tempo trascorso, uso dei token e impegno del revisore. La nota di FrontierCode di Anthropic è rilevante qui: più ragionamento può portare un agente a fare cambiamenti fuori dall’ambito richiesto, quindi la qualità include anche sapere quando fermarsi.
Ricerca e lavoro documentale
I punteggi di Sonnet quasi alla pari con Opus nelle valutazioni di knowledge work di Anthropic lo rendono una scelta convincente per flussi documentali strutturati. Se il lavoro consiste nel confrontare cinque report, estrarre campi specificati o trasformare note approvate in uno schema per una deck, Sonnet può fornire la qualità richiesta a un costo inferiore. Opus diventa più attraente quando le fonti sono in conflitto, la domanda di ricerca evolve o il modello deve fare e difendere scelte interpretative difficili.
Qualunque modello tu scelga, spesso è la preparazione delle fonti a determinare la qualità dell’output. File duplicati, versioni poco chiare e contesto mancante possono indebolire anche un modello molto valido. L’AI Summarizer di iWeaver può aiutare a organizzare file e link misti in riassunti, punti chiave, brief esecutivi o note strutturate prima di iniziare l’analisi di livello superiore. Si tratta di un flusso informativo complementare; non implica che uno qualsiasi dei modelli di Claude sia attualmente selezionabile dentro iWeaver.
Una regola pratica di instradamento
Usa Sonnet per primo quando il compito ha input chiari, un deliverable chiaro e un metodo di validazione semplice. Passa a Opus quando il problema resta ambiguo dopo il chiarimento, coinvolge molte fasi dipendenti, ha un costo elevato in caso di errore oppure fallisce ripetutamente i test di accettazione di Sonnet. Questo approccio offre in genere un equilibrio migliore tra costi e qualità rispetto alla scelta di un modello diverso per ogni richiesta.
La decisione finale dovrebbe basarsi sull’economia del compito completato. Traccia il totale dei token, l’uso della cache, i retry, la latenza, il tempo del revisore e la gravità dei fallimenti su esempi reali. I guadagni del benchmark di Sonnet 5.5 lo rendono un default credibile per l’uso quotidiano; Opus 5.5 resta la scelta deliberata quando complessità e giudizio giustificano il pagamento di più. Per esplorare in dettaglio il modello a costo più basso, vedi Claude Sonnet 5.5: Benchmarks, Pricing, Features & What’s New, oppure continua con How to Use Claude Sonnet 5.5.