
Grok 4.7 è ufficialmente disponibile. Rilasciato il 21 settembre 2026, Grok 4.7 è l’ultimo modello di frontiera di xAI per la programmazione, le attività agentiche e il lavoro professionale basato sulla conoscenza.
Non è solo un piccolo aggiornamento di Grok 4.6. xAI afferma che Grok 4.7 usa un nuovo modello di base, più grande, un ciclo di reinforcement learning più lungo e un addestramento che attribuisce più peso a compiti difficili, che possono richiedere ore per essere completati. Migliora anche la verifica di sé e la gestione del contesto a lungo raggio—due aspetti che contano molto più nei flussi di lavoro reali rispetto al semplice rispondere a prompt brevi. E, a differenza delle prime speculazioni su Grok 4.7, ora abbiamo specifiche ufficiali e risultati di benchmark con cui confrontarlo.
Data di rilascio di Grok 4.7
Grok 4.7 è stato lanciato ufficialmente. È disponibile tramite la xAI API come: grok-4.7
Al momento del lancio, xAI ha reso il modello disponibile anche su diverse piattaforme di coding e di AI, tra cui Grok Build e Cursor. GitHub ha inoltre iniziato a distribuire Grok 4.7 agli utenti di GitHub Copilot.
Per maggiori informazioni sul modello della generazione precedente, puoi anche consultare la nostra recensione di Grok 4.6.
Specifiche di Grok 4.7 in breve
Ecco le principali specifiche ufficiali.
| Specifica | Grok 4.7 |
|---|---|
| Data di rilascio | 21 settembre 2026 |
| Nome modello | grok-4.7 |
| Finestra di contesto | 500.000 token |
| Knowledge cutoff | Maggio 2026 |
| Modalità di input | Testo e immagine |
| Modalità di output | Testo |
| Limite di output testuale | Nessun limite fisso all’output testuale |
| Livelli di ragionamento | Basso, Medio, Alto, XHigh |
| Ragionamento predefinito | Alto |
| Chiamata a funzioni | Supportata |
| Ricerca web | Supportata |
| Ricerca X | Supportata |
| Esecuzione del codice | Supportata |
| Supporto API | Responses API, Chat Completions |
La finestra di contesto da 500K è particolarmente utile per documenti lunghi, grandi codebase, progetti multi-file, attività di ricerca e workflow agentici che devono mantenere molte informazioni nel tempo.
Grok 4.7 supporta anche quattro livelli di ragionamento:
- Basso
- Medio
- Alto
- XHigh
Questo permette agli sviluppatori di bilanciare velocità e profondità del ragionamento in base al compito.
Cosa c’è di nuovo in Grok 4.7?
I cambiamenti più importanti non riguardano funzioni appariscenti della nuova interfaccia.
Riguardano invece miglioramenti nel modo in cui il modello gestisce lavori più lunghi e più difficili.
1. Un nuovo modello di base, più grande
Grok 4.7 è costruito su un nuovo modello di base più grande rispetto a Grok 4.6.
Questo conta perché non si tratta semplicemente di Grok 4.6 con ulteriore post-training.
Il modello sottostante è cambiato.
xAI lo ha poi addestrato con un ciclo di reinforcement learning più lungo, su una miscela più impegnativa di compiti, dando maggiore enfasi a problemi che possono richiedere molte ore per essere completati.
L’obiettivo è chiaro:
rendere Grok migliore nel portare a termine lavori difficili, non solo nell’iniziarli bene.
2. Prestazioni migliori sui compiti lunghi
Molti modelli di AI sembrano impressionare con prompt brevi, ma diventano meno affidabili quando il compito si allunga.
Questo può manifestarsi come:
- istruzioni dimenticate
- decisioni incoerenti
- lavoro ripetuto
- dipendenze mancate
- errori mai verificati
- scarsa gestione del contesto precedente
Grok 4.7 è addestrato specificamente per svolgere meglio compiti che richiedono esecuzioni più lunghe.
È particolarmente rilevante per agent di coding, workflow di ricerca, creazione di documenti e lavoro professionale che coinvolge più fasi.
3. Verifica di sé migliore
Un altro cambiamento importante è una verifica automatica più forte.
Invece di limitarsi a generare una risposta e passare oltre, Grok 4.7 è progettato per verificare il proprio lavoro con maggiore attenzione.
Questo conta in attività come:
- debug del codice
- revisione di progetti complessi
- verifica di calcoli
- revisione di documenti
- seguire istruzioni lunghe
- usare più strumenti in sequenza
Naturalmente, la verifica di sé non significa che il modello non possa commettere errori.
La revisione umana resta importante per attività ad alto rischio.
Ma un controllo interno migliore può ridurre guasti evidenti durante workflow lunghi.
4. Agente e lavoro basato sulla conoscenza più forti
Grok 4.7 è stato anche addestrato per comprendere meglio l’harness del Grok Bot di xAI.
Questo rende il modello particolarmente adatto a compiti in stile agent, in cui l’AI deve fare più che rispondere a una singola domanda.
Per esempio:
- ispezionare file
- cercare informazioni
- scrivere codice
- eseguire strumenti
- revisionare i risultati
- rivedere il proprio lavoro
- continuare finché un compito più grande non è completato
Questo riflette un cambiamento più ampio nell’AI di frontiera.
La domanda chiave non è più soltanto:
Il modello riesce a rispondere a questa domanda?
Sta diventando sempre più:
Il modello riesce a completare l’intero compito?
Benchmark di Grok 4.7
xAI ha pubblicato risultati di benchmark che confrontano Grok 4.7 con Grok 4.6 e altri modelli di frontiera.
I risultati mostrano guadagni particolarmente evidenti in coding, attività basate sul terminale, ingegneria e lavoro professionale basato sulla conoscenza.
Per un confronto più pulito, la tabella qui sotto si concentra su Grok 4.7 vs Grok 4.6.
| Benchmark | Grok 4.7 | Grok 4.6 | Variazione |
|---|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% | +5,9 pt |
| DeepSWE v1.1 | 71,0% | 65,2% | +5,8 pt |
| AA Briefcase v1.1 | 1.657 | 1.546 | +111 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | +17,7 pt |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | +3,8 pt |
| HealthBench Professional | 56,7% | 48,5% | +8,2 pt |
| EEBench | 64,0% | 53,0% | +11,0 pt |
L’incremento più grande di questo set sembra in Terminal-Bench 4.0, dove Grok 4.7 ottiene 38,0% rispetto al 20,3% di Grok 4.6.
È particolarmente rilevante per workflow agentici di coding che coinvolgono comandi da terminale, strumenti, repository ed esecuzione multi-step.
Grok 4.7 mostra anche miglioramenti notevoli in benchmark di ingegneria elettrica, lavoro professionale basato sulla conoscenza, ingegneria del software e ragionamento clinico.
Grok 4.7 vs Grok 4.6
I numeri dei benchmark rendono più facile vedere il cambiamento tra generazioni.
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Stato | Generazione precedente | Generazione più recente |
| Modello di base | Modello precedente | Nuovo modello di base, più grande |
| Finestra di contesto | — | 500K token |
| Compiti a lunga durata | Forte | Migliorato |
| Verifica di sé | Forte | Migliorata |
| CursorBench 4.0 | 40,4% | 46,3% |
| DeepSWE v1.1 | 65,2% | 71,0% |
| Terminal-Bench 4.0 | 20,3% | 38,0% |
| EEBench | 53,0% | 64,0% |
| Prezzo input API | $2 / 1M token | Parte da $2 / 1M token |
| Prezzo output API | $6 / 1M token | Parte da $6 / 1M token |
La ragione più grande per passare da Grok 4.6 a Grok 4.7, quindi, non è una singola funzionalità in evidenza.
È la combinazione di:
coding migliore + prestazioni più forti sui compiti lunghi + gestione del contesto più efficace + verifica interna più solida.
Se il tuo carico di lavoro è principalmente composto da domande brevi e quotidiane, la differenza potrebbe sembrarti minore.
Per sviluppatori e utenti che eseguono workflow lunghi e multi-step, il miglioramento è più significativo.
Prezzi di Grok 4.7
Grok 4.7 parte da:
- $2 per 1 milione di token di input
- $0,50 per 1 milione di token di input cache
- $6 per 1 milione di token di output
Queste tariffe si applicano quando il prompt è sotto i 200K token.
Per prompt sopra i 200K token, il prezzo ufficiale dell’API aumenta a:
- $4 per 1 milione di token di input
- $1 per 1 milione di token di input cache
- $12 per 1 milione di token di output
Vale la pena notare questo modello a livelli perché Grok 4.7 ha una finestra di contesto da 500K.
Usare l’intera finestra di contesto può quindi costare più di richieste più brevi.
Che cos’è Grok 4.7 Fast?
xAI offre anche Grok 4.7 Fast.
È lo stesso modello sottostante servito su infrastrutture più veloci.
Secondo xAI, offre circa il doppio della velocità di output rispetto alle velocità standard di token, ma con token rate standard doppi.
Tuttavia, c’è una differenza importante sulla disponibilità:
Grok 4.7 Fast è attualmente disponibile tramite Cursor e Grok Build, ma non tramite la pubblica xAI API.
Questo rende il modello standard Grok 4.7 l’opzione principale per gli sviluppatori che costruiscono direttamente con la xAI API.
Dove puoi usare Grok 4.7?
Grok 4.7 è già disponibile su diverse piattaforme.
xAI API
Gli sviluppatori possono usare:
grok-4.7
tramite xAI Responses API o Chat Completions API.
Supporta strumenti tra cui:
- chiamata a funzioni
- ricerca web
- ricerca X
- esecuzione del codice
Grok Build
Grok 4.7 è il modello predefinito per Grok Build, l’agente di xAI per coding e creazione di app.
Cursor
Grok 4.7 è disponibile in Cursor.
Anche la variante Fast è disponibile lì.
Model Gateways
La documentazione di xAI elenca la disponibilità tramite piattaforme tra cui:
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
GitHub ha iniziato a distribuire Grok 4.7 a GitHub Copilot il 21 settembre.
È reso disponibile su tutti i piani Copilot Pro, Pro+, Max, Business ed Enterprise.
Le environment supportate includono:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot cloud agent
- GitHub Copilot app
- JetBrains
- Xcode
- Eclipse
Il rollout è graduale, quindi alcuni utenti potrebbero non vederlo subito.
Non giudicare Grok 4.7 da un singolo benchmark
I risultati ufficiali sono utili, ma una tabella di benchmark non dovrebbe essere la ragione finale per scegliere un modello.
I benchmark testano cose diverse.
Un modello che va bene su un benchmark di coding non è necessariamente la scelta migliore per:
- ricerca
- analisi di documenti
- scrittura
- assistenza clienti
- estrazione dati
- riassunti
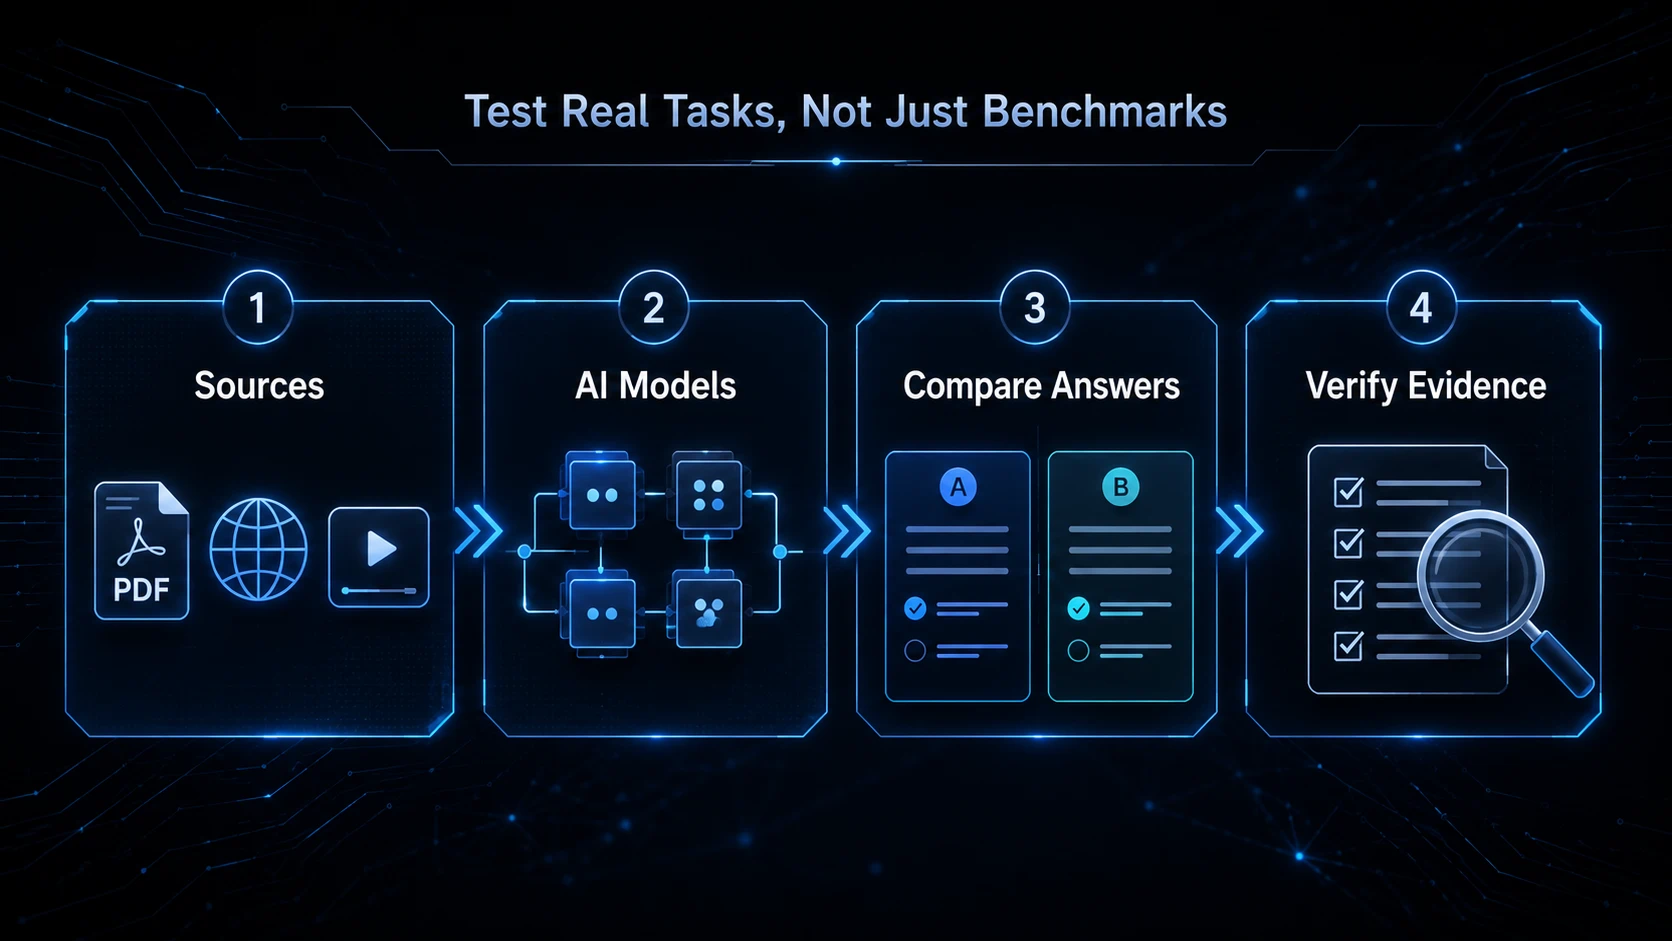
Un test migliore è confrontare i modelli usando lo stesso compito reale.
Per esempio:
- Assegna a ogni modello la stessa domanda.
- Fornisci gli stessi file sorgente.
- Usa le stesse istruzioni.
- Confronta le risposte finali.
- Controlla le informazioni mancanti e gli errori fattuali.
- Verifica le conclusioni importanti rispetto alle fonti originali.
Se il tuo lavoro coinvolge PDF, siti web, video, presentazioni o documenti di ricerca, strumenti come iWeaver possono aiutarti a organizzare quei materiali in un’unica posizione prima di confrontare le uscite dei modelli.
Questo rende più facile capire se un modello AI sia davvero utile per il tuo workflow, invece di essere semplicemente migliore in una classifica.
Grok 4.7 vale la pena usarlo?
Per il coding e i workflow agentici, Grok 4.7 è un aggiornamento significativo rispetto a Grok 4.6.
I dati ufficiali dei benchmark mostrano miglioramenti in ingegneria del software, lavoro da terminale, attività professionali, ingegneria elettrica, compiti legali e ragionamento clinico.
La combinazione di una finestra di contesto da 500K, prestazioni più forti sui compiti lunghi, verifica di sé migliorata, supporto degli strumenti e prezzi iniziali invariati dell’API rende inoltre il modello più pratico per workflow più grandi.
Questo però non significa che Grok 4.7 sarà il miglior modello per ogni compito.
I modelli hanno ancora punti di forza diversi e i risultati dei benchmark non sempre si traducono direttamente in output migliori nella vita reale.
Ma Grok 4.7 offre agli sviluppatori e agli utenti professionali un’opzione più forte rispetto a Grok 4.6—soprattutto quando un compito coinvolge molte fasi, grandi quantità di contesto o un uso esteso di strumenti.
Grok 4.7 non è solo un altro piccolo aggiornamento di Grok.
Usa un nuovo modello di base più grande e mette molta più enfasi sul coding a lunga durata, sul lavoro agentico, sulla verifica di sé e sui compiti professionali basati sulla conoscenza.
Rispetto a Grok 4.6, i numeri ufficiali mostrano miglioramenti chiari in diversi benchmark impegnativi, mentre il prezzo iniziale dell’API resta invariato.
La domanda più interessante ora non è se Grok 4.7 migliori rispetto a Grok 4.6 sulla carta.
È quanto di quel miglioramento si trasferisca in progetti reali.
Per sviluppatori, ricercatori e utenti che costruiscono workflow AI più lunghi, è lì che Grok 4.7 verrà valutato in definitiva.