
L’elaborazione intelligente dei documenti (IDP) utilizza l’IA e tecnologie correlate per trasformare il contenuto dei documenti in informazioni che un flusso di lavoro può utilizzare. Un sistema tipico classifica i documenti in arrivo, estrae i dati rilevanti, valida i risultati e passa le informazioni revisionate alla fase successiva. La vera prova è se il risultato sia abbastanza affidabile per l’azione che segue—non se il sistema sia in grado di leggere una pagina.
La spiegazione di AWS sull’IDP descrive queste fasi, includendo controlli rispetto a regole di business o dati esistenti. Questo passaggio di validazione è fondamentale: un importo plausibile in una fattura può comunque essere errato e un valore correttamente estratto può appartenere a una fattura che il tuo sistema ha già ricevuto.
Inizia con l’azione dopo l’estrazione
Prima di valutare uno strumento, completa questa frase: “Una volta che il documento è stato elaborato, dobbiamo…” La risposta potrebbe essere creare un record, assegnare un revisore, confrontare le informazioni con un ordine di acquisto oppure preparare un briefing. Ogni esito richiede controlli diversi e un livello di automazione diverso.
Se l’attività si conclude con una persona che legge un riepilogo, potrebbe essere sufficiente la comprensione del documento. Se l’output modifica un record in un altro sistema, serve anche uno schema definito, regole di validazione e un percorso per le eccezioni. Questi requisiti dovrebbero essere stabiliti prima del pilota, perché una semplice demo di estrazione non può dimostrare che l’intero flusso di lavoro sia pronto.
Le fasi di un flusso di lavoro IDP
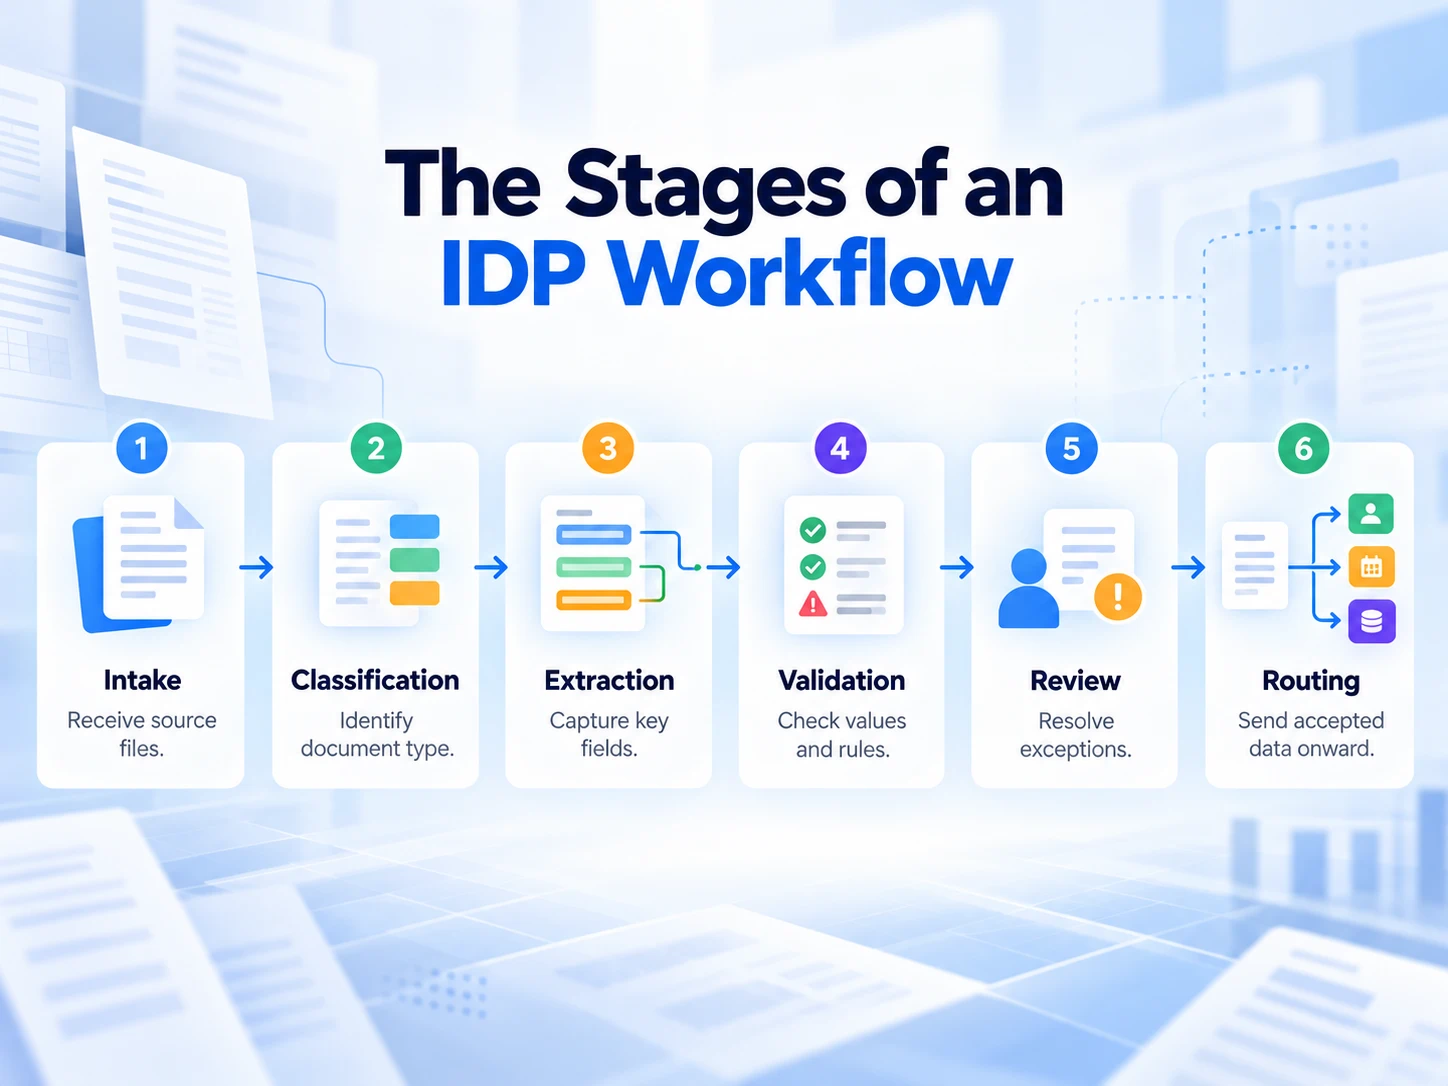
| Fase | Scopo | Esempio di errore non rilevato |
|---|---|---|
| Acquisizione | Ricevere e identificare i file di origine | Lo stesso file arriva due volte |
| Classificazione | Determinare il tipo di documento o la categoria rilevante | Una nota di credito viene trattata come una fattura |
| Estrazione | Catturare i campi necessari per l’attività | Un totale parziale viene registrato come totale |
| Validazione | Verificare valori, relazioni e informazioni richieste | Un totale non rispetta la regola di calcolo concordata |
| Revisione | Risolvere risultati ambigui o rifiutati | Una data poco chiara riceve un’ipotesi non giustificata |
| Instradamento | Inoltrare le informazioni accettate alla fase successiva | Un record valido viene inviato alla destinazione sbagliata |
Questo è un modello di pianificazione, non una garanzia che ogni prodotto IDP fornisca tutte e sei le fasi. Verifica quali componenti offre un servizio e quali devi costruire o configurare tu.
La classificazione determina la prossima interpretazione
I documenti possono sembrare simili pur servendo a scopi diversi. Una fattura, un ordine di acquisto e una nota di credito possono contenere nomi, date e importi, ma non dovrebbero attivare la stessa azione. La classificazione stabilisce quali regole di estrazione e quali requisiti di revisione si applicano.
La panoramica di Document Intelligence di Microsoft descrive classificatori personalizzati insieme ai modelli di estrazione. La sua distinzione illustra perché riconoscere il tipo di documento ed estrarne i contenuti siano lavori separati. Un flusso di lavoro dovrebbe anche definire cosa accade quando il tipo è incerto o esce dall’insieme previsto.
L’estrazione richiede una definizione chiara di ogni campo
“Estrarre la data” è ambiguo quando un file contiene la data di emissione, la data di servizio e la scadenza di pagamento. Definisci il campo di cui hai bisogno e come deve apparire nell’output. Includi regole per i valori mancanti e conserva le informazioni necessarie per verificare l’estrazione.
Ad esempio, uno schema di fattura potrebbe richiedere il nome del fornitore, il numero della fattura, la data della fattura, la valuta, il totale e l’imposta. Queste definizioni dei campi devono specificare quale valore scegliere quando un documento presenta più candidati. Aggiungere un campo è semplice; decidere cosa conta come risultato corretto richiede più attenzione.
La validazione controlla più della leggibilità
Alcuni controlli confermano che un valore abbia la forma prevista. Altri controllano le relazioni all’interno del documento o confrontano i dati estratti con un record considerato attendibile. Una data può essere formattata correttamente ma rappresentare l’evento sbagliato, e un totale può essere leggibile ma incoerente con le righe di dettaglio.
Definisci la regola di business e l’azione da intraprendere quando fallisce. Ad esempio, la mancanza del numero della fattura può richiedere una revisione, mentre la combinazione ricorrente fornitore-e-numero-fattura può attivare un controllo di duplicato. Superare un controllo del formato non dovrebbe autorizzare automaticamente un’azione a valle.
Esempio di fattura completo
Immagina una fattura del fornitore con questi dettagli: la data di emissione è 5 marzo, la data di scadenza è 4 aprile, il subtotale è 1.000 e il totale è 1.080. La valuta non è stampata in modo abbastanza chiaro da poter essere determinata. Questo è un esempio a scopo illustrativo, non un risultato misurato di un test di prodotto.
Un sistema di estrazione potrebbe restituire un record dall’aspetto ordinato con il 4 aprile come data della fattura, 1.000 come totale e una valuta stimata. Ciascun valore è plausibile preso singolarmente. Insieme, mostrano perché un flusso di lavoro IDP necessita di significati espliciti dei campi e di regole di revisione.
| Campo richiesto | Valore revisionato | Controllo di accettazione |
|---|---|---|
| Data della fattura | 5 marzo | Usa la data di emissione, non la data di scadenza |
| Data di scadenza | 4 aprile | Tienila separata dalla data della fattura |
| Totale | 1.080 | Identifica il totale finale e controlla i suoi componenti |
| Valuta | Non risolta | Lascia la valuta non risolta e richiedi una revisione |
La fase successiva corretta è risolvere la valuta prima di usare il record in contesti in cui la valuta è importante. Un record completo nell’aspetto creato indovinando è meno utile di un record incompleto che identifichi chiaramente cosa deve controllare un revisore.
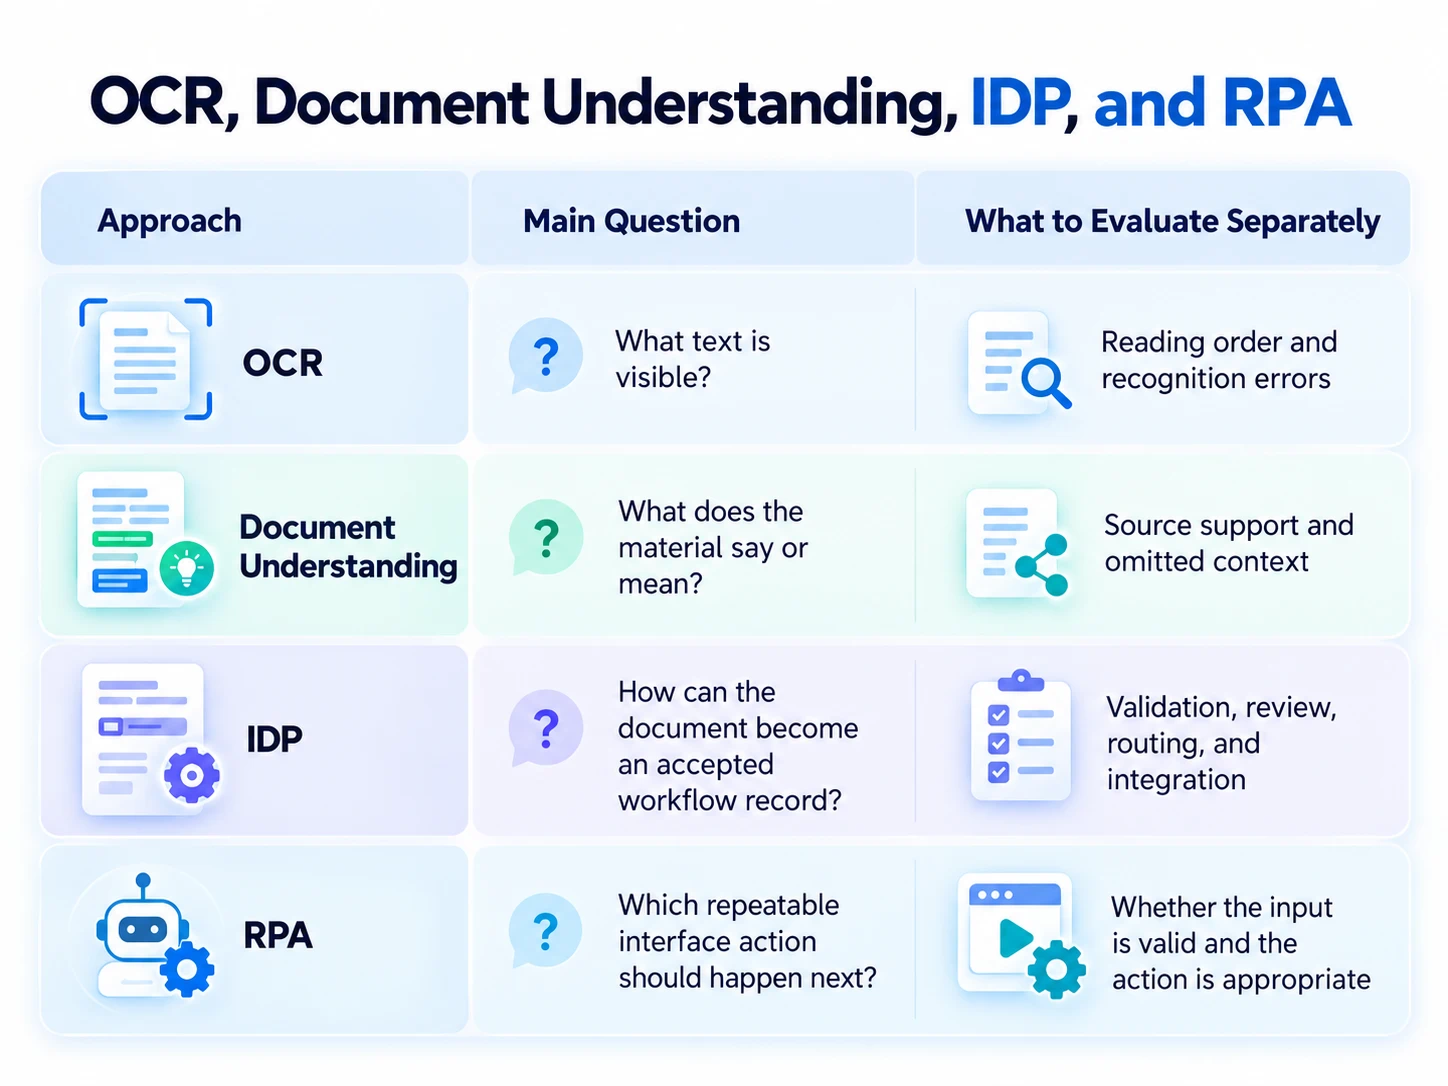
OCR, Document AI, IDP e RPA
Il Document AI di Google offre processori per OCR, estrazione e classificazione. Questi componenti dimostrano come un flusso di lavoro possa usare capacità diverse per fasi diverse. La presenza di un estrattore non ti dice se le regole di validazione o la gestione delle eccezioni siano state implementate.
| Approccio | La domanda principale a cui risponde | Cosa valutare separatamente |
|---|---|---|
| OCR | Qual è il testo visibile? | Ordine di lettura ed errori di riconoscimento |
| Comprensione del documento | Che cosa dice o significa questo materiale? | Supporto della fonte e contesto omesso |
| IDP | In che modo il documento può diventare un record accettato di flusso di lavoro? | Validazione, revisione, instradamento e integrazione |
| RPA | Quale azione ripetibile dell’interfaccia deve avvenire dopo? | Se l’input è valido e se l’azione è appropriata |
I confini sono pratici più che assoluti: i prodotti possono combinare più approcci. Usa questa distinzione per porre domande di valutazione migliori, invece di presumere che un’etichetta marketing definisca l’intero sistema.
Dove l’AI generativa aiuta—e dove le regole contano ancora
I modelli generativi possono interpretare istruzioni e linguaggio vario, rendendoli pertinenti per estrazioni flessibili e comprensione dei documenti. Google descrive un estrattore personalizzato basato su AI generativa nella sua offerta Document AI. Questo supporta l’affermazione di capacità per quel prodotto; non stabilisce un livello universale di accuratezza per ogni file o flusso di lavoro.
Per un pilota di AI per l’elaborazione intelligente dei documenti, definisci cosa al modello è consentito dedurre. Alcune attività necessitano di un valore normalizzato; altre richiedono una trascrizione diretta. Mantieni questi modi distinti così i revisori possono capire se un campo proviene da un’affermazione esplicita o da un’interpretazione.
Un prompt può chiedere “usa null quando manca”, ma il flusso di lavoro deve comunque verificare l’output. Non fare affidamento su spiegazioni scorrevoli come prova che un campo sia corretto. Rivedi il passaggio della fonte pertinente, la definizione del campo e qualunque regola applicata dopo l’estrazione.
Come progettare un pilota IDP utile
Scegli una famiglia di documenti e un solo esito
Parti da un’attività limitata, come l’estrazione dei campi specificati dalle fatture dei fornitori per la revisione. Definisci cosa produrrà il pilota e chi controllerà le eccezioni. Estendersi a più famiglie di documenti prima che il primo flusso di lavoro sia compreso può rendere gli errori più difficili da diagnosticare.
Crea un set di valutazione rappresentativo
Includi esempi ordinari e le variazioni che ti aspetti di ricevere: campi mancanti, layout non familiari, documenti multi-pagina, scansioni di scarsa qualità e duplicati. Fai in modo che un revisore stabilisca i risultati attesi prima dei test. Tieni anche un set separato “tenuto da parte” così la valutazione finale includa file che non hanno guidato le scelte di configurazione.
Misura gli esiti al livello giusto
La correttezza dei campi e l’accettazione del documento rispondono a domande diverse. Un sistema può acquisire correttamente la maggior parte dei campi mentre manca spesso proprio il campo necessario per completare l’attività. Registra quali campi falliscono, quanto spesso i documenti necessitano di revisione e cosa rende un record pronto per la fase successiva.
Usa queste definizioni in modo coerente:
- Correttezza del campo: campi valutati corretti divisi per tutti i campi valutati, usando una regola di corrispondenza documentata.
- Tasso di revisione: documenti che richiedono revisione umana divisi per documenti elaborati.
- Tasso di accettazione: documenti che soddisfano tutti i controlli di accettazione definiti divisi per documenti elaborati.
- Sforzo di revisione: tempo impiegato per risolvere le eccezioni, misurato con un punto di inizio e uno di fine coerenti.
Queste sono misure di valutazione suggerite, non affermazioni sulle prestazioni. Separa i campi mancanti dai valori errati e registra anche i fallimenti a valle oltre agli errori di estrazione. Questa distinzione ti aiuta a decidere se migliorare il parsing, riscrivere la definizione di un campo o regolare il percorso di revisione.
Testa la gestione degli errori prima di aumentare l’automazione
Controlla cosa succede quando un file non può essere letto, quando il tipo di documento è sconosciuto o quando i campi richiesti sono in conflitto. Il flusso di lavoro dovrebbe rendere visibile la condizione irrisolta e preservare abbastanza contesto per un revisore. Verifica che un record rifiutato non passi in modo silenzioso al sistema successivo.
Se valuti uno strumento “IDP AI”, chiedi di vedere il percorso delle eccezioni con i tuoi documenti rappresentativi. Una dimostrazione riuscita dovrebbe includere come viene gestito un fallimento, non solo come viene elaborato un file ordinario.
Dove si inserisce iWeaver
Alcuni compiti sui documenti si concludono con la comprensione, più che con un record operativo. Se stai leggendo report o preparando un briefing, iWeaver offre riepiloghi, conversazioni con IA e organizzazione delle conoscenze. Il suo AI Document Summarizer può essere un punto di partenza per rivedere il materiale di origine e decidere a cosa dare attenzione più da vicino.
Ad esempio, chiedi una panoramica delle affermazioni del report, delle prove e dei limiti prima di pianificare la tua analisi. Il flusso di lavoro pubblico sui documenti di iWeaver supporta riepiloghi personalizzati ed esplorazioni successive. Controlla l’originale quando un fatto conta e valuta separatamente eventuali capacità di estrazione o integrazione enterprise richieste.
Domande da porsi prima di scegliere un sistema IDP
L’elaborazione intelligente dei documenti è la stessa cosa dell’OCR?
L’OCR si concentra sul riconoscimento del testo. Un flusso di lavoro IDP aggiunge compiti come classificazione, estrazione, validazione, revisione e instradamento. Identifica quali di queste fasi servano davvero al tuo compito prima di confrontare i prodotti.
L’IDP può funzionare senza revisione umana?
Dipende dai documenti, dai criteri di accettazione e dalle conseguenze dell’errore. Definisci quali risultati possono procedere automaticamente e quali richiedono una revisione. Usa le evidenze del pilota per impostare queste regole, invece di presumere che l’automazione sia adatta a ogni input.
In che modo un flusso di lavoro IDP dovrebbe gestire le informazioni mancanti?
Rappresenta in modo esplicito il valore mancante e applica una regola definita. Un campo obbligatorio può causare un rifiuto o una revisione; un campo opzionale può restare vuoto. Indovinare un valore mancante può rendere il risultato più difficile da verificare e non sicuro da usare nella fase successiva.
Da cosa dovrei iniziare a testare?
Verifica che i campi richiesti per la prossima azione siano acquisiti correttamente e convalidati. Poi testa le eccezioni, i duplicati e la destinazione dei record accettati. Un punteggio di estrazione a livello alto non è sufficiente se il campo critico o il percorso degli errori restano poco affidabili.
Rendere la prima revisione del flusso di lavoro verificabile
Scegli un’attività sui documenti ristretta, definisci l’output accettato e testa sia file ordinari sia eccezioni. Tratta l’estrazione come una fase in un processo il cui risultato finale deve essere verificato. Quando l’obiettivo immediato è comprendere un documento, inizia da un riepilogo basato sulla fonte e usalo per guidare la tua revisione.