
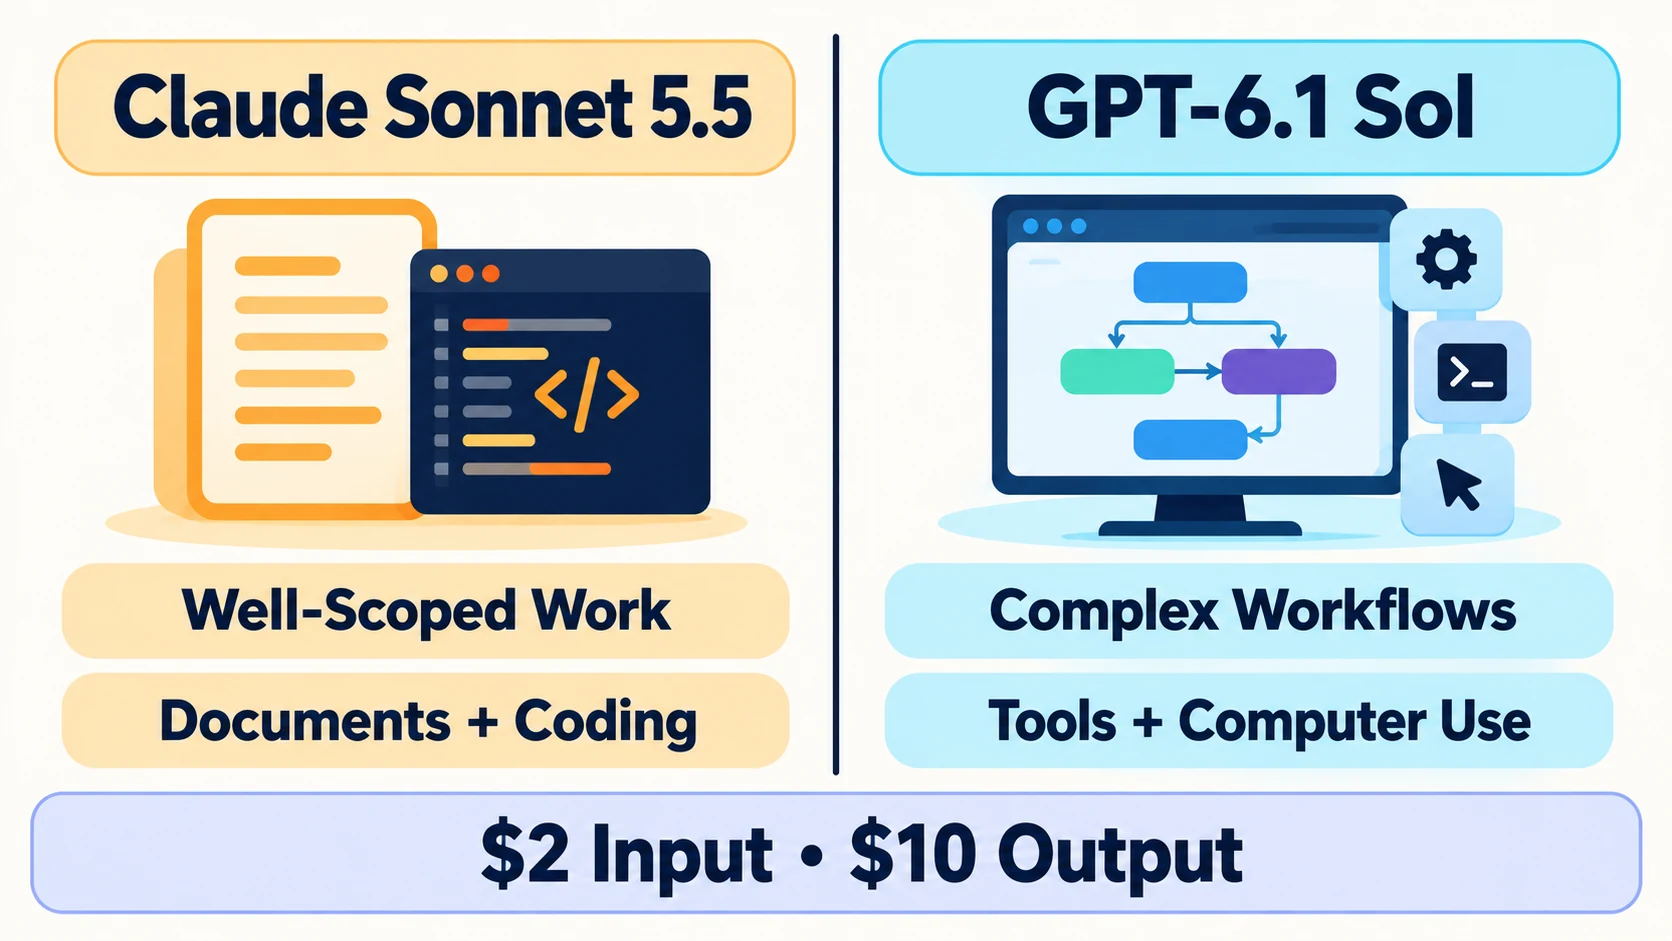
Claude Sonnet 5.5 e GPT-6.1 Sol hanno gli stessi prezzi standard dei token dell’API, ma sono pensati per punti di forza diversi. Sonnet 5.5 è posizionato per una programmazione rapida e ben delimitata e per attività professionali. GPT-6.1 Sol mira a una codifica complessa, all’uso del computer, al lavoro guidato da strumenti e ai flussi di lavoro professionali, offrendo prestazioni quasi “Astra” a un costo inferiore.
La scelta pratica dipende dal tipo di attività. Sonnet 5.5 merita una prova per la codifica delimitata, documenti rifiniti, presentazioni e fogli di calcolo. GPT-6.1 Sol è un’ottima opzione quando ti serve una finestra di contesto molto ampia, gli strumenti della Responses API di OpenAI o un flusso di lavoro multi-step. iWeaver offre una prova gratuita di GPT-6.1 Sol, rendendo possibile testare il modello sui tuoi documenti e sulle tue attività di ricerca prima di decidere.
Claude Sonnet 5.5 vs GPT-6.1 Sol: a colpo d’occhio
| Dettaglio | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| Prezzo input standard | $2 per 1M token | $2 per 1M token |
| Prezzo output standard | $10 per 1M token | $10 per 1M token |
| Prezzo lettura cache | $0,20 per 1M token | $0,10 per 1M token |
| Finestra di contesto | Controlla la piattaforma Claude selezionata | 1.050.000 token |
| Output massimo | Controlla la piattaforma Claude selezionata | 128.000 token |
| Focus dichiarato | Codifica ben delimitata e attività professionali | Codifica complessa, uso del computer e lavoro professionale |
| Controllo del ragionamento | Sforzo regolabile | Basso, medio, alto, xhigh e max |
| Nome modello API | claude-sonnet-5-5 |
gpt-6.1-sol |
Le cifre relative a GPT-6.1 Sol provengono dalla documentazione dei modelli di OpenAI. I prezzi e il posizionamento di Sonnet 5.5 derivano dall’annuncio del rilascio di Anthropic. I prezzi per contesti lunghi, l’elaborazione batch, le modalità rapide, le scritture in cache, le chiamate agli strumenti e i termini del provider cloud possono cambiare il costo finale.
Coding: il controllo dell’ambito conta tanto quanto la capacità grezza
Anthropic posiziona Sonnet 5.5 come un modello rapido per il lavoro professionale quotidiano, la correzione dei bug e attività con ambito chiaramente definito. I materiali di rilascio riportano risultati di codifica solidi, tra cui 70,6% su Terminal-Bench 4.0 e 46,2% con sforzo massimo su FrontierCode 1.1 Main.
GPT-6.1 Sol è posizionato per la codifica complessa e il lavoro “agentic”. OpenAI inoltre gli fornisce accesso all’esecuzione del codice, a una shell ospitata, all’applicazione di patch, all’uso del computer e ad altri strumenti tramite la Responses API.
Questi fatti non stabiliscono un vincitore universale. Una valutazione della codifica dovrebbe usare la stessa issue del repository, le stesse istruzioni, lo stesso ambiente e lo stesso budget di tempo. Verifica se il modello ha trovato la causa giusta, ha modificato solo i file necessari, ha eseguito i controlli appropriati e si è fermato quando l’attività era completata.
Scegli Sonnet 5.5 per una prova quando l’attività è delimitata e conta un’iterazione veloce. Scegli GPT-6.1 Sol per una prova quando il lavoro richiede un contesto più ampio del repository, il coordinamento degli strumenti o più fasi di implementazione e verifica.
Documenti e knowledge work
Sonnet 5.5 è posizionato in modo esplicito per creare documenti, presentazioni e fogli di calcolo curati. Anche le evidenze del rilascio di Anthropic sottolineano il lavoro di conoscenza professionale e un miglioramento dell’efficienza rispetto a Sonnet 5.
GPT-6.1 Sol offre una finestra di contesto documentata da 1.050.000 token e fino a 128.000 token di output. Questo lo rende un’opzione interessante per grandi insiemi di documenti, sintesi di ricerche, revisione di policy e deliverable strutturati e dettagliati.
La capacità di contesto da sola non dimostra la qualità dei documenti. Testa entrambi i modelli con lo stesso pacchetto di sorgenti e chiedi di estrarre le figure, riconciliare i passaggi in conflitto, distinguere evidenze da inferenze e mostrare da dove proviene ciascuna conclusione. Il modello che produce un risultato più verificabile può essere più prezioso di quello che scrive la prima bozza più fluida.
Strumenti e compatibilità con il flusso di lavoro
Il vantaggio più chiaro di GPT-6.1 Sol è la superficie di strumenti documentata tramite la Responses API. Supporta web search, file search, generazione di immagini, esecuzione del codice, shell ospitata, uso del computer, MCP e ricerca degli strumenti. Questo può ridurre l’attrito di integrazione per i team che stanno già costruendo sullo stack agent di OpenAI.
Sonnet 5.5 è disponibile tramite i prodotti di Claude, la Claude Platform, AWS, Google Cloud e Microsoft Azure. Potrebbe adattarsi in modo più naturale quando un’organizzazione usa già questi ambienti o ha prompt e valutazioni ottimizzati per Claude.
Conta anche la piattaforma attorno al modello. Logging, permessi, gestione delle sorgenti, passaggi di revisione, requisiti dei dati e flusso di lavoro del team possono superare una piccola differenza in un benchmark.
Per chi desidera la baseline precedente, può consultare il Claude Sonnet 5.5 vs GPT-6 comparison pubblicato da iWeaver prima di valutare cosa cambia con l’aggiornamento alla 6.1.
Costi: stesso prezzo dei token, costo diverso in base all’attività
Entrambi i modelli elencano prezzi standard di $2 per un milione di token di input e $10 per un milione di token di output. Questo non significa che costino uguale per completare un’attività.
Il costo totale dell’attività include dimensione del prompt, comportamento della cache, sforzo di ragionamento, chiamate agli strumenti, tentativi, lunghezza dell’output e revisione umana. Anthropic afferma che Sonnet 5.5 può usare meno token e funzionare più velocemente di Sonnet 5, ma si tratta di un confronto con il predecessore—non di una prova che sia più economico di GPT-6.1 Sol.
Misura il costo totale per raggiungere un risultato accettabile. Un modello che richiede meno correzioni può risultare più conveniente anche se una singola risposta è più lunga.
Quale modello dovresti scegliere?
Prova Claude Sonnet 5.5 quando la tua priorità è la codifica ben delimitata, una rapida iterazione o documenti rifiniti e output in stile ufficio. Le sue migliori evidenze pubbliche e il posizionamento del prodotto si allineano a queste attività.
Prova GPT-6.1 Sol quando ti serve una finestra di contesto ampia, l’ecosistema di strumenti di OpenAI, un lavoro complesso multi-step o un’alternativa a costi più bassi rispetto ad Astra. È anche l’opzione più naturale quando la tua applicazione dipende già dalla Responses API.
Per una decisione equa, esegui tre attività rappresentative invece di un singolo prompt generico: un’attività di routine, un’attività difficile e un’attività ricca di sorgenti. Valuta correttezza, completezza, latenza, token totali, modifiche non necessarie e tempo di revisione.
Puoi iniziare una prova gratuita di GPT-6.1 Sol su iWeaver e valutarlo con i tuoi documenti o con il tuo flusso di ricerca. Il miglior modello è quello che soddisfa il tuo standard di qualità con il minor impegno totale—non quello con il titolo più “rumoroso”.