
GPT-6.1 Sol è il modello bilanciato di OpenAI per una programmazione complessa, l’uso del computer e il lavoro professionale. OpenAI lo posiziona come in grado di offrire prestazioni “quasi-Astra” a un prezzo più basso, rendendolo la scelta intermedia più pratica per chi ha bisogno di qualcosa di più di un modello leggero, ma non vuole sostenere i costi di Astra per ogni attività.
iWeaver ora offre una prova gratuita di GPT-6.1 Sol, dando agli utenti un modo diretto per testare il modello su ricerca, documenti, scrittura, analisi e altre attività di knowledge work prima di decidere quanto si adatti al proprio flusso di lavoro.
GPT-6.1 Sol in sintesi
| Dettaglio | GPT-6.1 Sol |
|---|---|
| Meglio per | Programmazione complessa, uso del computer, ricerca e lavoro professionale |
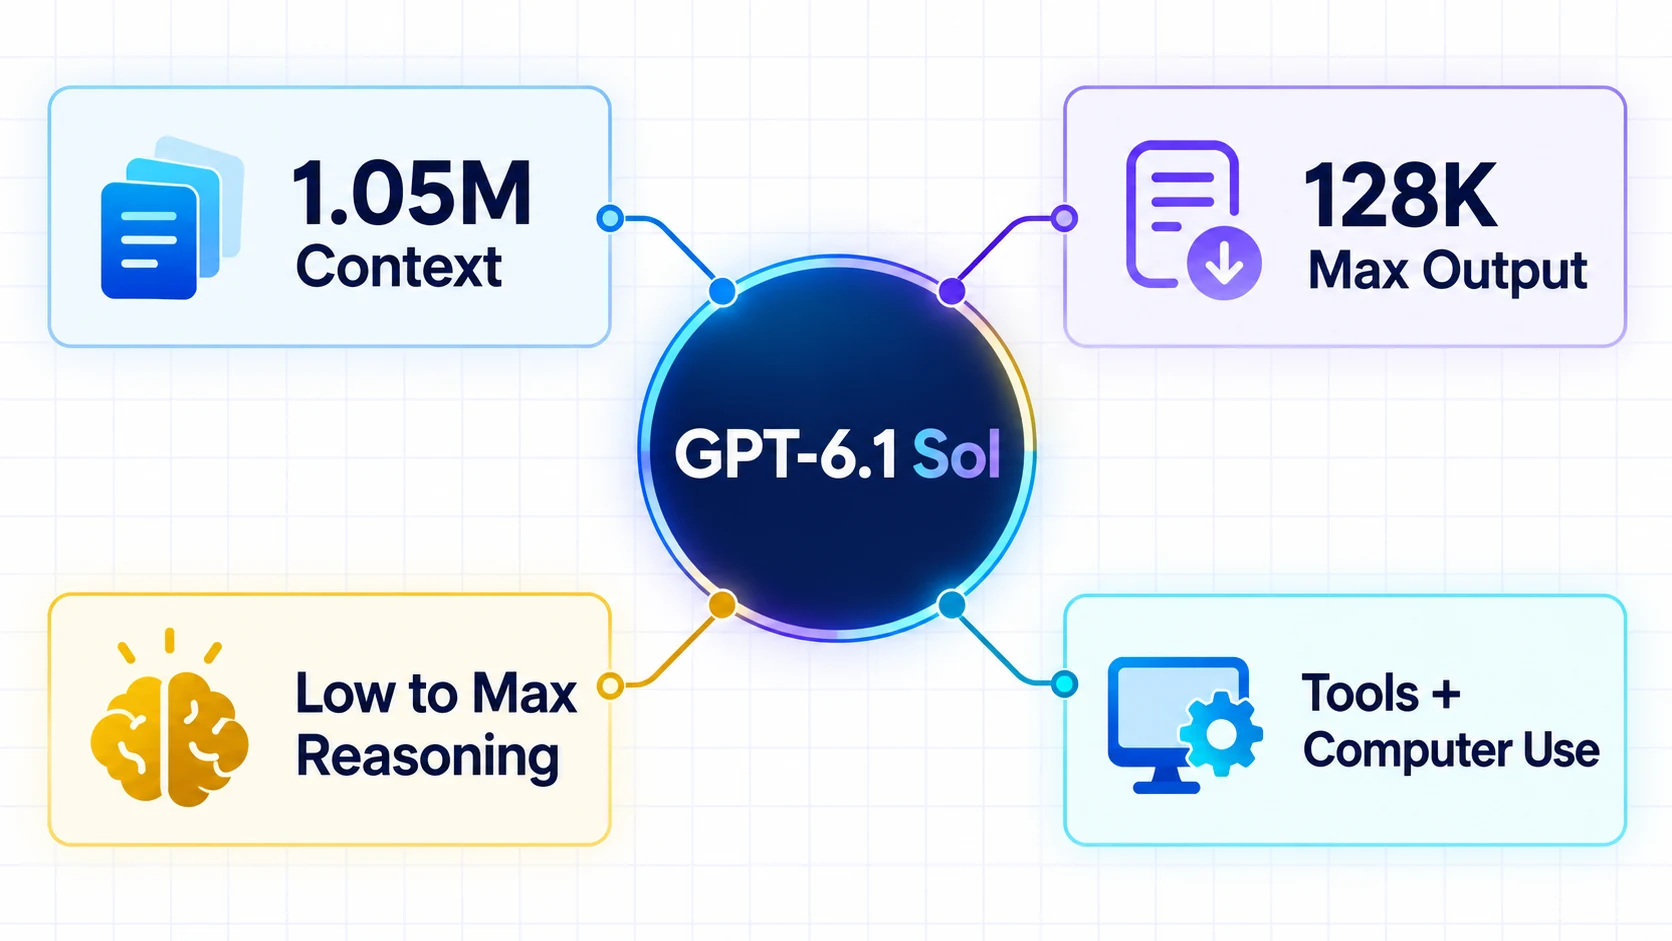
| Finestra di contesto | 1.050.000 token |
| Output massimo | 128.000 token |
| Knowledge cutoff | 30 aprile 2026 |
| Input immagine | Supportato |
| Input audio e video | Non supportati |
| Effort di ragionamento | Basso, medio, alto, xhigh e max |
| Prezzo input API standard | $2 per 1M token |
| Prezzo output API standard | $10 per 1M token |
| Fine-tuning | Non supportato |
Queste specifiche provengono dalla pagina ufficiale del modello GPT-6.1 Sol. I prezzi API possono cambiare con prompt a lungo contesto, modalità di elaborazione, caching, elaborazione regionale e chiamate agli strumenti, quindi le tariffe standard per token sono solo un punto di partenza per le stime dei costi.
Cosa c’è di nuovo in GPT-6.1 Sol?
GPT-6.1 Sol occupa lo spazio tra GPT-6 Astra e GPT-6 Luna. Astra è pensato per il lavoro end-to-end più impegnativo, mentre Luna dà priorità alle attività efficienti ad alto volume. Sol mira a mantenere gran parte delle capacità di Astra a un prezzo per token significativamente più basso.
Per più contesto sul livello più alto, leggi la precedente panoramica su GPT-6 Astra di iWeaver, che spiega il ruolo che Astra svolge nel lavoro end-to-end richiesto.
Il modello è costruito per lavori che coinvolgono più passaggi collegati, invece di una singola risposta breve. Gli esempi includono la revisione di un ampio set di documenti, l’indagine su un problema tecnico, la coordinazione degli strumenti, la produzione di un report strutturato o lo svolgimento di un task di coding dalla diagnosi fino alla verifica.
“Prestazioni quasi-Astra” è la posizione di prodotto di OpenAI, non una garanzia che Sol corrisponda ad Astra su ogni prompt. La domanda utile è se Sol soddisfa i criteri di accettazione per il tuo compito a un costo totale più basso.
Una finestra di contesto da 1,05M token
GPT-6.1 Sol supporta una finestra di contesto da 1.050.000 token. Questo offre spazio per basi di codice di grandi dimensioni, report lunghi, più paper, trascrizioni, documenti di policy o una storia di progetto estesa.
Una finestra di contesto ampia non significa che ogni dettaglio caricato riceva automaticamente la stessa attenzione. I risultati migliori dipendono comunque da una chiara organizzazione delle fonti e da una richiesta precisa. Per un task su un documento di grandi dimensioni, dì al modello:
- Quali file sono autorevoli.
- Quali domande deve rispondere.
- Quali prove dovrebbe citare o a cui fare riferimento.
- Come deve essere strutturato l’output.
- Quali incertezze deve segnalare invece di ipotizzare.
iWeaver aggiunge un flusso di lavoro pratico intorno a questo processo. Puoi portare il materiale di partenza in un’unica area di lavoro, definire l’output richiesto e continuare a rifinire il risultato invece di trattare il modello come una semplice chat “one-shot”.
Effort di ragionamento: dal basso al max
GPT-6.1 Sol supporta cinque livelli di effort di ragionamento: low, medium, high, xhigh e max. Medium è l’impostazione predefinita documentata.
Un effort più basso può andare bene per estrazione di routine, riscrittura, classificazione e domande con ambito chiaramente definito. Un effort più alto è più adatto quando un task richiede pianificazione, riconciliazione di prove in conflitto, debugging complesso o un’analisi accurata multi-step. Più ragionamento non è automaticamente meglio: può aumentare la latenza e i costi senza migliorare una risposta semplice.
Il modello non supporta l’effort di ragionamento none o minimal. I developer che migrano un’applicazione dovrebbero anche notare che il tool calling appartiene alla Responses API. Chat Completions è supportata solo per richieste senza strumenti.
Cosa può fare GPT-6.1 Sol?
Analizza documenti e ricerca
Il modello può lavorare su raccolte di fonti lunghe, estrarre affermazioni, confrontare sezioni, identificare contraddizioni e produrre output strutturati. Il risultato richiede comunque una verifica delle fonti quando conta l’accuratezza.
Gestisci task di coding complessi
GPT-6.1 Sol è progettato per lavori software che richiedono contesto del repository, uso di strumenti, più modifiche e verifica. Una buona valutazione dovrebbe misurare correttezza, cambiamenti non necessari, risultati dei test, tempo trascorso e effort del revisore—non solo se il modello ha prodotto codice.
Coordina gli strumenti
Tramite la Responses API, GPT-6.1 Sol supporta strumenti tra cui web search, file search, esecuzione del codice, uso del computer, generazione di immagini, MCP e tool search. Disponibilità e addebiti possono variare in base allo strumento e all’ambiente.
Crea output professionali
Il modello può aiutare a trasformare il materiale di partenza in report, brief, piani, tabelle e bozze strutturate. Il suo output massimo ampio supporta consegne sostanziali, anche se prompt concisi e revisione a fasi sono in genere più affidabili rispetto alla richiesta di una risposta finale enorme in un unico passaggio.
Limiti di GPT-6.1 Sol
GPT-6.1 Sol può ancora interpretare male una fonte, trascurare un’eccezione, produrre codice non corretto o formulare un’inferenza con troppa sicurezza. Anche il knowledge cutoff significa che le informazioni attuali potrebbero richiedere navigazione o fonti aggiornate fornite.
Per i lavori con conseguenze, verifica citazioni, calcoli, riferimenti, esecuzione del codice e conclusioni di business. Tratta il modello come un lavoratore competente dentro un processo verificabile, non come l’autorità finale.
Come provare GPT-6.1 Sol
Il modo più veloce per valutare il modello è usarlo su un task il cui risultato corretto conosci già. Scegli un report reale, una domanda di ricerca, un set di documenti o un problema di coding e definisci cosa deve contenere una risposta riuscita.
Puoi provare GPT-6.1 Sol con una prova gratuita su iWeaver. Aggiungi il tuo materiale di partenza, descrivi il risultato richiesto e confronta l’output con il tuo flusso di lavoro abituale. Valutalo in base a accuratezza, completezza, tempo risparmiato e quanto bisogno c’è di revisione del risultato.
Una valutazione del genere a livello di task ti dice di più di un semplice punteggio di benchmark—e ti aiuta a decidere quando Sol è sufficiente e quando vale la pena usare un diverso livello di modello.