
Kimi K3.1 Pro ha tariffe base API di input e output pubblicate inferiori a quelle di Claude Opus 5.5. Se sia una scelta migliore dipende dal compito: il numero di tentativi, correzioni e revisioni umane può contare più della tariffa per token.
Entrambi i modelli vengono posizionati per attività complesse di coding e knowledge work. Questo confronto usa documentazione ufficiale e risultati pubblicati dai vendor, invece di un test indipendente hands-on. L’obiettivo è aiutarti a scegliere una valutazione utile, quindi decidere in base al lavoro che produce.
Prezzi API: confronta lo stesso tipo di utilizzo
Per il contesto di lancio dietro questo confronto, vedi le nuove funzionalità di Kimi K3.1 Pro.
Le seguenti tariffe in dollari USA sono state verificate il 24 ottobre 2026:
| Per milione di token | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Input base | $2 | $4 |
| Output base | $10 | $20 |
| Cache hit/lettura | $0.20 | $0.20 |
Queste sono tariffe API. Le abbonamenti per consumatori, i servizi di terze parti e le modalità accelerate hanno condizioni separate.
Considera una richiesta ipotetica con 100.000 token di input non in cache e 10.000 token di output. Con queste tariffe base, il costo di input e output sarebbe di $0.30 con K3.1 Pro e $0.60 con Opus 5.5. Questo calcolo esclude scritture in cache, strumenti, retry e altre spese. Illustra la differenza di tariffa; non è il costo di un compito misurato.
Per attività ripetute, registra la fattura completa e il tempo necessario per raggiungere un risultato accettato. Una richiesta più economica può diventare un flusso di lavoro più costoso se richiede correzioni estese. Una richiesta più cara deve giustificare il proprio prezzo tramite l’esito che consegna.
Coding: guarda oltre un punteggio di benchmark ravvicinato
Il report di rilascio di Kimi posiziona K3.1 Pro vicino a Opus 5.5 su Terminal-Bench 4.0. Questi risultati sono una prova relativa a uno specifico setup di valutazione, non una garanzia sul tuo repository.
Per un confronto di coding utile, scegli un compito con un fallimento noto e un test di accettazione chiaro. Fornisci a ciascun modello lo stesso stato del progetto, la descrizione dell’issue, l’accesso agli strumenti e il budget di tempo. Tieni copie separate, così che un singolo run non possa beneficiare delle modifiche dell’altro.
Dopo ogni run, ispeziona tre aspetti: se l’issue è risolta, se è cambiato qualche comportamento non correlato e se la spiegazione corrisponde alla modifica effettiva. Registra qualsiasi intervento manuale. Se un modello ha bisogno di un suggerimento a metà strada, quell’intervento appartiene al risultato.
Una piccola riparazione dell’interfaccia e un test di refactor su più file mettono alla prova capacità diverse. Includile entrambe solo se rappresentano entrambe il tuo carico di lavoro. Un singolo demo riuscito è troppo limitato come base per spostare l’intero flusso di lavoro di ingegneria.
Analisi dei documenti: verifica se le conclusioni resistono a una verifica
Per il lavoro di ricerca, il confronto dovrebbe includere una domanda che non possa essere risolta riassumendo un singolo documento. Usa una raccolta di fonti con una figura non aggiornata, un’affermazione qualificata o un’apparente discrepanza.
Prova lo stesso prompt con entrambi i modelli:
Confronta i report forniti. Identifica le affermazioni che concordano, quelle in conflitto e quelle che non possono essere riconciliate sulla base delle evidenze disponibili. Cita la fonte e la posizione per ciascuna. Separa i fatti riportati dalla tua interpretazione.
Rivedi le risposte senza guardare prima le etichette del modello. Conta le affermazioni prive di supporto e le qualifiche mancate. Verifica se uno dei due modelli risolve una divergenza inventando una spiegazione.
Se usi iWeaver per preparare la raccolta di fonti, l’AI Document Summarizer può aiutarti a stabilire una panoramica. Mantieni coerenti gli input effettivi del confronto; dare a un modello un riepilogo curato e all’altro file grezzi crea un esperimento diverso.
Quando dovresti valutare prima K3.1 Pro?
Usa Come usare Kimi K3.1 Pro per impostare un primo task e controllare il risultato.
Inizia con K3.1 Pro quando le tariffe API pubblicate più basse affrontano davvero un vincolo di costo e hai un’attività ripetibile da testare. È anche un candidato ragionevole quando l’attenzione a coding e ricerca del nuovo rilascio corrisponde al lavoro che devi svolgere.
Kimi K3.1 Pro è disponibile in iWeaver e iWeaver offre una prova gratuita del modello. Un task documentale a perimetro definito è una prima valutazione pratica: scegli fonti che conosci, specifica l’output e verifica le affermazioni consequenziali.
Le condizioni della prova non stabiliscono il costo di utilizzo dell’API di Kimi. Valuta ogni percorso di accesso alle proprie condizioni.
Quando dovresti tenere Opus 5.5 nel confronto?
Prima di pagare l’output accelerato, rivedi Kimi K3.1 Pro vs. Highspeed per separare la velocità dalla qualità del task.
Mantieni Opus nella valutazione quando hai già un flusso di lavoro che funziona bene con esso. Un processo consolidato ha valore: prompt, strumenti, abitudini di revisione e output accettati richiedono tempo per essere ricostruiti.
Esegui K3.1 Pro su un campione rappresentativo prima di cambiare. Includi un task ordinario, un task difficile e un caso che il tuo flusso di lavoro attuale gestisce male. Un nuovo modello è più utile quando risolve un problema concreto o riduce il costo di un risultato accettato.
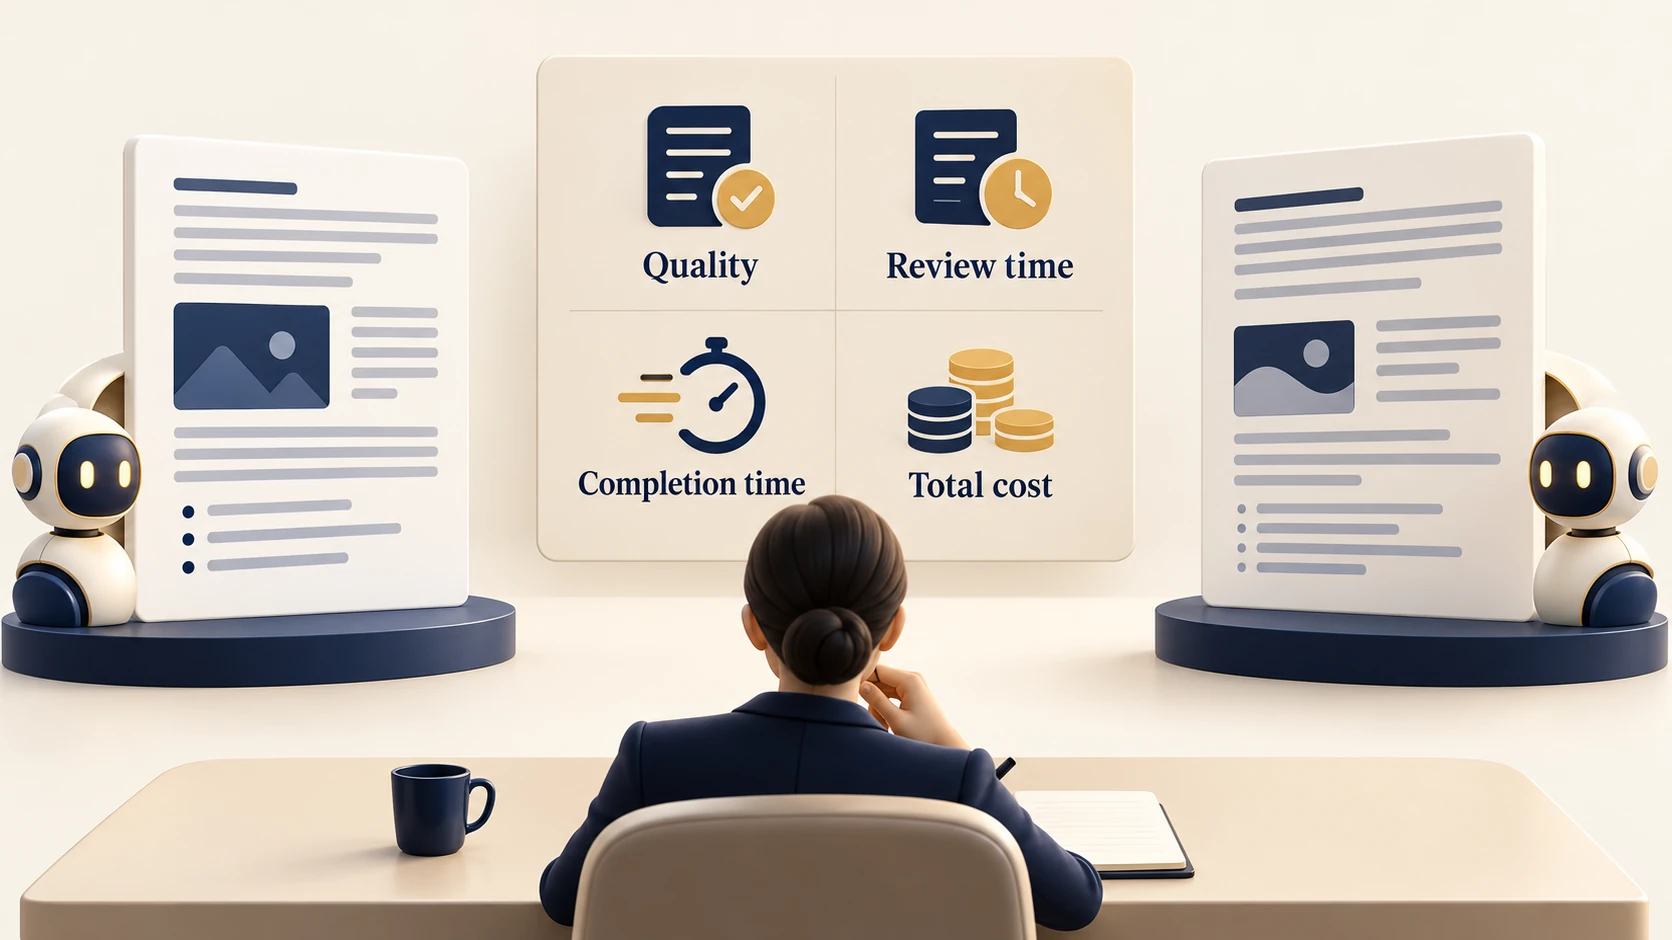
Per una scelta finale, usa una semplice scheda: output accettato, tempo di correzione, tempo di completamento e costo totale. Pesa questi fattori in base al lavoro. Un team di ricerca potrebbe mettere al primo posto la qualità delle evidenze; un sistema di batch processing potrebbe dare più importanza al costo una volta raggiunta una soglia minima di qualità.
Non c’è bisogno di dichiarare un modello vincitore in ogni task. Scegli K3.1 Pro quando consegna un risultato migliore per i tuoi vincoli e conserva Opus quando la tua valutazione supporta il mantenimento.