
Claude Opus 5.5 e a família do OpenAI’s GPT-6 agora competem por muitas das mesmas cargas de trabalho exigentes de IA — mas adotam abordagens diferentes.
A Anthropic posiciona o Claude Opus 5.5 para programação agentic de longa duração e trabalho profissional de conhecimento. A OpenAI divide o GPT-6 em três modelos: Astra para as tarefas fim-a-fim mais difíceis, Sol para codificação complexa e agentes, e Luna para cargas de trabalho focadas e de alto volume.
Por isso, a comparação útil já não é simplesmente Claude vs GPT.
É:
Claude Opus 5.5 vs GPT-6 Astra, Sol e Luna — qual modelo se encaixa na sua carga de trabalho real?
Claude Opus 5.5 vs GPT-6 em um Relance
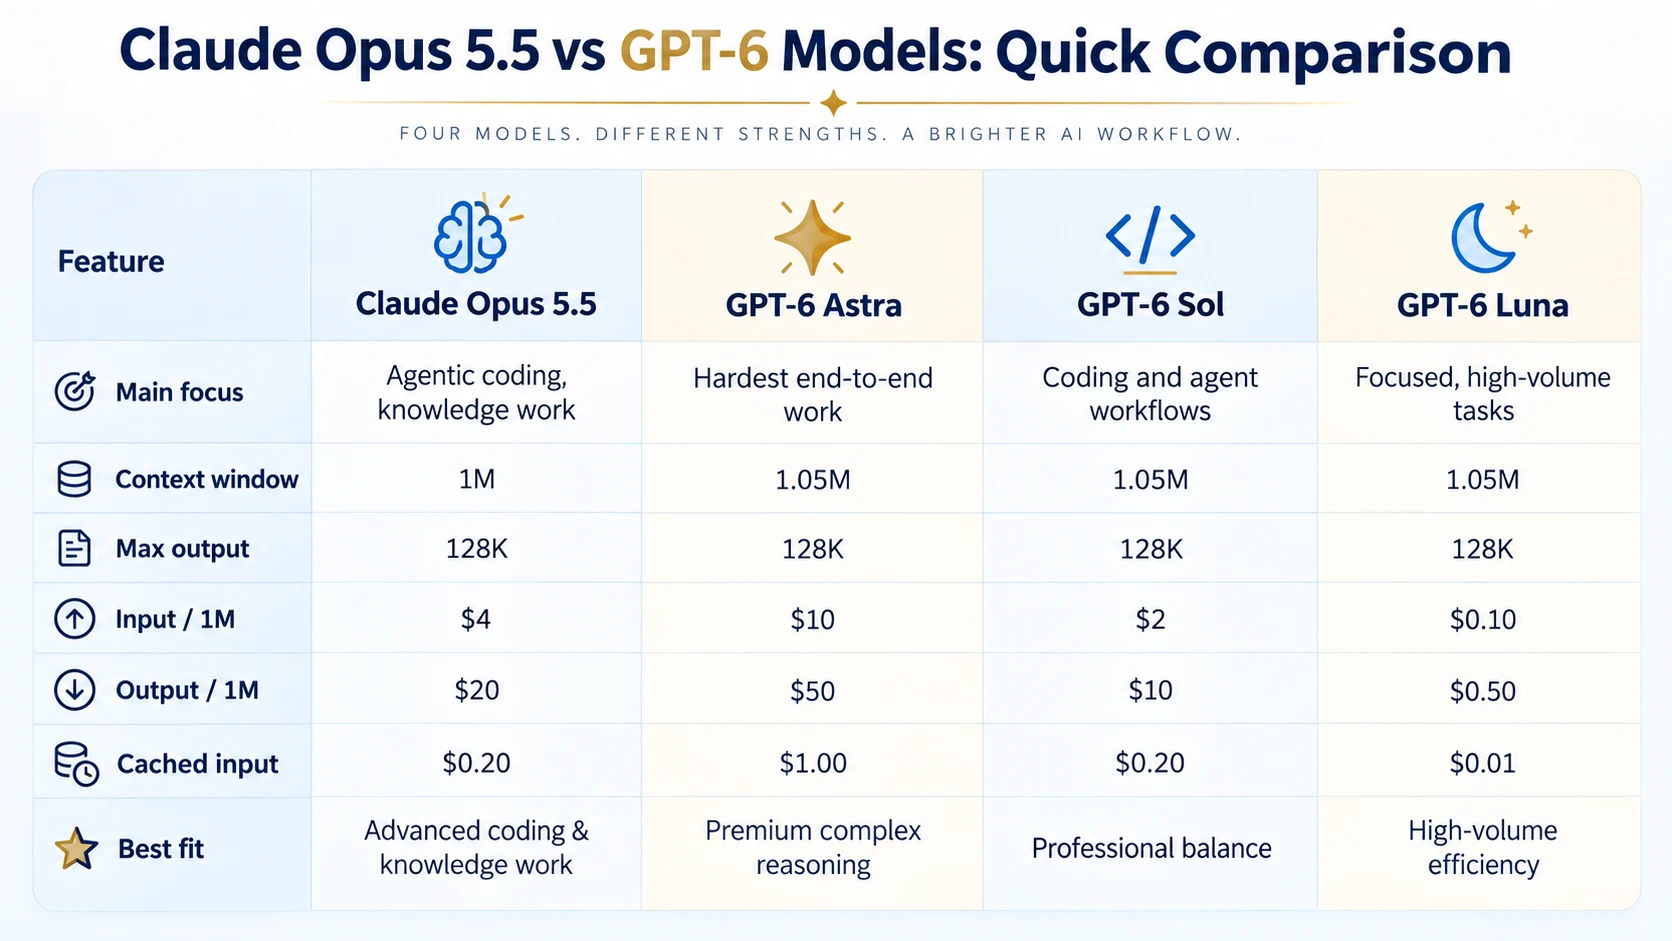
| Feature | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| Main focus | Agentic coding, knowledge work | Hardest end-to-end work | Coding and agent workflows | Focused, high-volume tasks |
| Context window | 1M | 1.05M | 1.05M | 1.05M |
| Max output | 128K | 128K | 128K | 128K |
| Input / 1M | $4 | $10 | $2 | $0.10 |
| Output / 1M | $20 | $50 | $10 | $0.50 |
| Cached input | $0.20 | $1.00 | $0.20 | $0.01 |
| Knowledge cutoff | June 2026 | Apr. 30, 2026 | Apr. 20, 2026 | May 18, 2026 |
O Claude Opus 5.5 oferece uma janela de contexto de 1M tokens e uma saída padrão de 128K, enquanto os três modelos do GPT-6 oferecem uma janela de contexto ligeiramente maior de 1.05M, com o mesmo limite máximo de saída de 128K.
Claude Opus 5.5 vs GPT-6 Astra
O GPT-6 Astra é a comparação direta mais próxima do Claude Opus 5.5 quando a tarefa envolve raciocínio difícil, codificação, pesquisa ou agentes de longa duração.
A OpenAI descreve o Astra como seu modelo mais capaz para o trabalho fim-a-fim mais difícil, incluindo raciocínio complexo, codificação, uso de computador, pesquisa e criação de documentos. A Anthropic descreve o Opus 5.5 como um modelo para programação agentic de longa duração e trabalho de conhecimento.
A maior diferença prática é o preço.
O Claude Opus 5.5 custa:
- $4 / 1M tokens de entrada
- $20 / 1M tokens de saída
O GPT-6 Astra custa:
- $10 / 1M tokens de entrada
- $50 / 1M tokens de saída
Com as taxas listadas padrão, o Opus 5.5 custa, portanto, 60% menos por token de entrada e de saída do que o Astra.
O Astra até oferece uma janela de contexto um pouco maior — 1.05M versus 1M — mas essa diferença é relativamente pequena em comparação com a diferença de preço.
O que mostram os benchmarks?
Os resultados publicados do Opus 5.5 pela Anthropic incluem comparações diretas com o GPT-6 Astra.
Nos testes da Anthropic, o Opus 5.5 teve pontuação mais alta em benchmarks incluindo Terminal-Bench 4.0 e FrontierCode v1.1, enquanto o GPT-6 Astra teve melhor desempenho em testes como AutomationBench e Terminal-Bench-Science 0.1. A Anthropic também observa que diferenças de benchmark devem ser interpretadas com cuidado, porque as condições de teste e a incerteza estatística variam.
Isso dificulta reduzir a comparação a uma única pontuação geral.
Para fluxos de trabalho reais, o teste mais adequado costuma ser se o modelo consegue concluir sua tarefa de codificação, pesquisa ou agente de forma confiável — e quanto custa concluir essa tarefa inteira.
Claude Opus 5.5 vs GPT-6 Sol
O GPT-6 Sol pode, na verdade, ser a alternativa mais interessante ao Opus 5.5 para muitos usuários profissionais.
Ambos os modelos são posicionados explicitamente em torno de fluxos de trabalho de codificação e agentic.
Mas seus preços são diferentes:
| Model | Input / 1M | Output / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
O GPT-6 Sol custa metade do valor por token padrão de entrada e de saída.
Ele também oferece uma janela de contexto de 1.05M em comparação com os 1M do Opus 5.5. Ambos oferecem suporte a até 128K tokens de saída.
Isso faz com que o Sol valha a pena considerar para cargas de trabalho frequentes como:
- Codificação diária
- Revisão de código
- Agentes de IA
- Fluxos de trabalho baseados em ferramentas
- Pesquisa
- Análise de documentos
- Automação de negócios
O Opus 5.5 fica mais interessante quando você quer o raciocínio da classe Opus da Anthropic e o foco em tarefas agentic de longa duração, enquanto o Sol é posicionado como uma opção mais consciente de custos para codificação e cargas de trabalho de agentes recorrentes.
Claude Opus 5.5 vs GPT-6 Luna
O Claude Opus 5.5 e o GPT-6 Luna miram em cargas de trabalho bem diferentes.
O Luna é o modelo GPT-6 mais eficiente da OpenAI para tarefas focadas e de alto volume. O preço da API é apenas:
- $0.10 / 1M tokens de entrada
- $0.50 / 1M tokens de saída
Isso fica bem abaixo dos preços do Opus 5.5 de $4 / $20.
O Luna faz mais sentido para tarefas como:
- Classificação
- Extração de informações
- Formatação
- Resumos curtos
- Processamento de conteúdo
- Automação repetitiva
O Opus 5.5 mira no extremo oposto do espectro de carga de trabalho: codificação complexa, trabalho de conhecimento mais profundo e tarefas que podem exigir raciocínio sustentado em muitos passos.
Assim, esta é menos uma disputa direta modelo vs modelo e mais sobre decidir se uma tarefa precisa, ou não, de um modelo avançado de raciocínio.
Preços: Onde cada modelo se encaixa
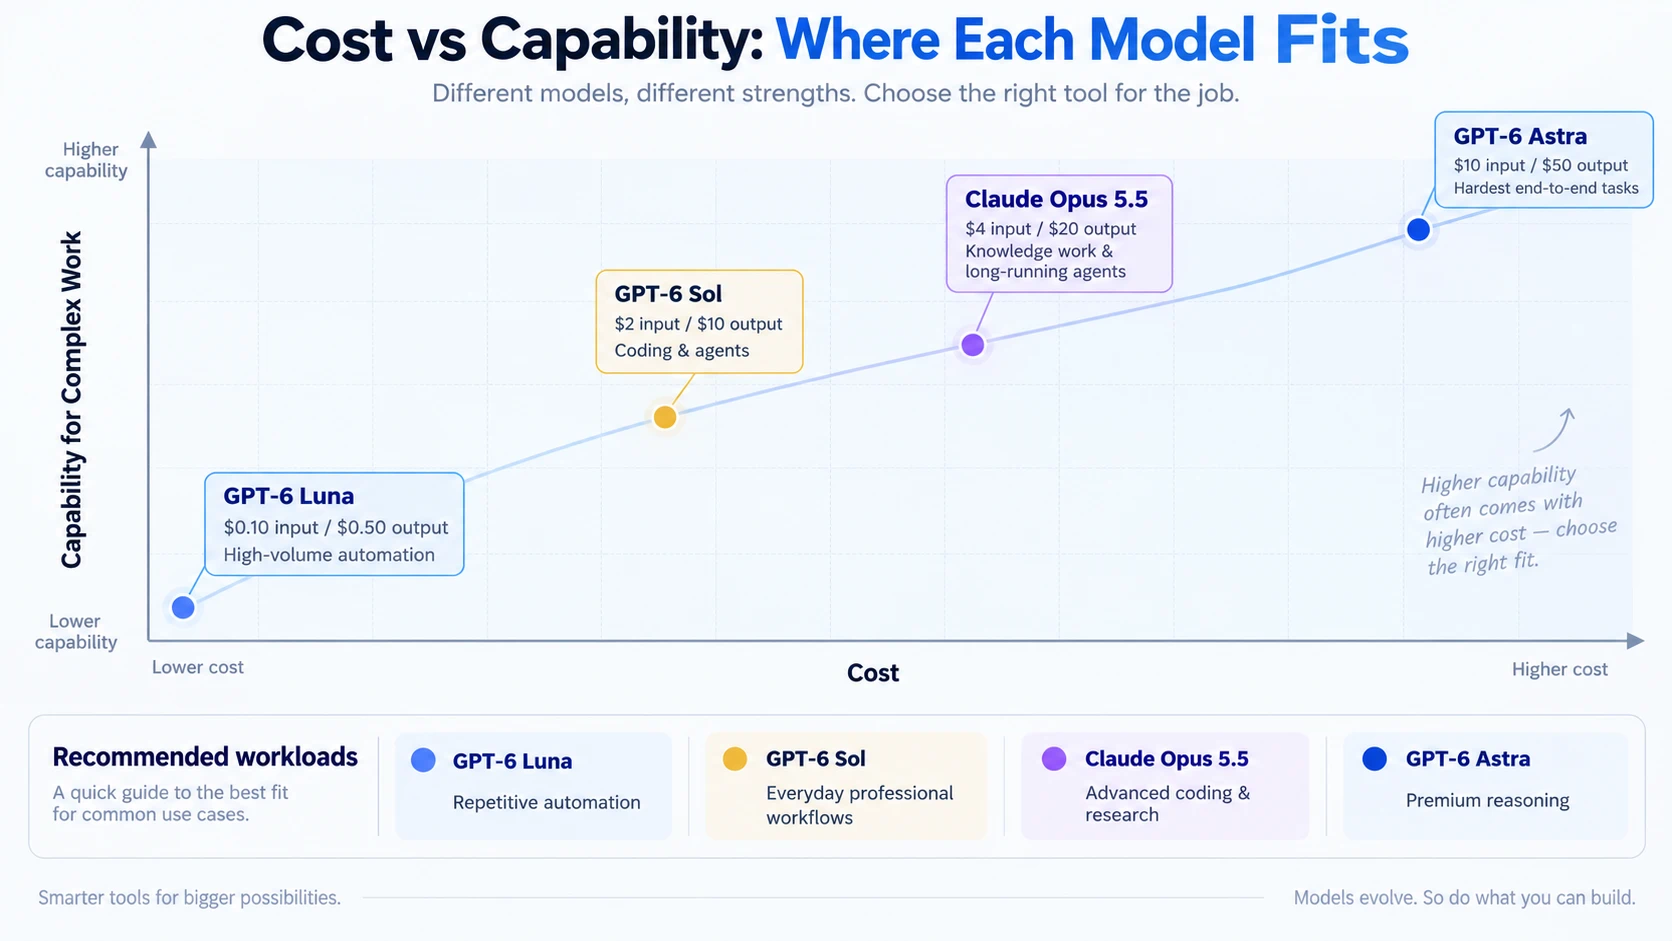
A escada de preços torna o posicionamento especialmente claro.
| Model | Input | Output | Relative Position |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | Alta eficiência em alto volume |
| GPT-6 Sol | $2 | $10 | Equilíbrio para profissionais |
| Claude Opus 5.5 | $4 | $20 | Codificação avançada & trabalho de conhecimento |
| GPT-6 Astra | $10 | $50 | Raciocínio premium fim-a-fim |
Estes são os preços padrão listados por token. A OpenAI aplica preços mais altos para solicitações do GPT-6 com mais de 272K tokens de entrada, então cargas de trabalho com contexto muito longo podem alterar o cálculo de custo.
A Anthropic também oferece prompt caching no Opus 5.5 por $0.20 por milhão de tokens de cache-read, o que pode importar para agentes que reutilizam contextos grandes repetidamente.
Qual modelo se encaixa em qual tarefa?
Uma forma prática de comparar os quatro modelos é por carga de trabalho, e não por marca.
| Task | Models worth testing |
|---|---|
| Difficult end-to-end reasoning | Claude Opus 5.5 / GPT-6 Astra |
| Large coding projects | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Long-running agents | Claude Opus 5.5 / GPT-6 Sol / Astra |
| Everyday professional coding | GPT-6 Sol / Claude Opus 5.5 |
| Research and knowledge work | Claude Opus 5.5 / GPT-6 Astra / Sol |
| High-volume extraction | GPT-6 Luna |
| Classification and formatting | GPT-6 Luna |
| Repetitive automation | GPT-6 Luna / Sol |
Não há motivo para que cada etapa de um fluxo de trabalho precise usar o mesmo modelo.
Um agente em produção pode usar o Luna para extração leve, o Sol para etapas regulares de raciocínio e direcionar tarefas particularmente difíceis para o Astra ou o Opus 5.5.
Isso pode importar mais em custo do que escolher um único modelo para tudo.
Experimente o Claude Opus 5.5 e a série GPT-6 no iWeaver
Especificações e benchmarks são úteis, mas nem sempre preveem qual modelo funciona melhor com seus próprios documentos, prompts ou fluxo de trabalho.
iWeaver permite que você teste Claude Opus 5.5 junto com a série GPT-6, incluindo GPT-6 Astra, Sol e Luna, sem precisar criar integrações de API separadas.
iWeaver também oferece créditos diários gratuitos, para que você possa testar a mesma tarefa real em diferentes modelos — por exemplo:
- Resumir PDFs
- Comparar vários documentos
- Pesquisa e análise
- Escrita
- Extração de conhecimento
- Perguntas de codificação
Executar a mesma tarefa em vários modelos torna muito mais fácil comparar profundidade de resposta, velocidade e utilidade do que depender apenas de números de benchmark.
Se você quiser começar especificamente com o modelo carro-chefe da OpenAI, veja nosso guia sobre como usar o GPT-6 Astra gratuitamente.
O Claude Opus 5.5 ocupa uma posição interessante no mercado atual de modelos de ponta.
Ele custa substancialmente menos do que o GPT-6 Astra, enquanto mira casos de uso de codificação, agentes e trabalho de conhecimento com exigência semelhante. O GPT-6 Sol reduz o custo do Opus 5.5 e foca fortemente em codificação e agentes, enquanto o GPT-6 Luna atende a uma necessidade diferente: processamento barato em escala.
A pergunta útil, portanto, não é simplesmente “Claude Opus 5.5 ou GPT-6?”
É se sua tarefa precisa de raciocínio de ponta, desempenho profissional equilibrado ou eficiência em alto volume.
Por isso, testar o mesmo fluxo de trabalho entre Opus 5.5, Astra, Sol e Luna costuma ser mais informativo do que escolher apenas entre tabelas de benchmark.