
Claude Sonnet 5.5 e Claude Opus 5.5 são separados menos por uma hierarquia simples de “bom versus melhor” e mais pelo formato da tarefa. A Anthropic posiciona o Sonnet como a opção mais rápida e de menor custo para trabalhos cotidianos bem delimitados, enquanto o Opus é voltado para problemas complexos e abertos que exigem julgamento cuidadoso em muitos passos. O Sonnet custa metade do preço por token padrão de entrada e saída, ainda assim fica surpreendentemente perto do Opus em várias avaliações publicadas.
Um benchmark pode mostrar se um modelo teve sucesso em um cenário controlado, mas pode não capturar o quão consistentemente ele lida com ambiguidades ou mantém restrições concorrentes em vista durante um projeto longo. Escolher entre os dois é uma decisão de roteamento: use o modelo menos caro que atenda aos requisitos de qualidade e risco da tarefa.
Sonnet 5.5 vs Opus 5.5 em resumo
| Detalhe | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Data de lançamento | 28 de setembro de 2026 | 22 de setembro de 2026 |
| Preço da entrada padrão | US$ 2 por 1M tokens | US$ 4 por 1M tokens |
| Preço da saída padrão | US$ 10 por 1M tokens | US$ 20 por 1M tokens |
| Preço de leitura de cache | US$ 0,20 por 1M tokens | US$ 0,20 por 1M tokens |
| Preço de gravação em cache | US$ 2,50 por 1M tokens | US$ 5 por 1M tokens |
| Função declarada | Trabalho cotidiano rápido e bem delimitado | Trabalho complexo que exige julgamento sustentado |
| Nome do modelo na API | claude-sonnet-5-5 |
claude-opus-5-5 |
Os números acima vêm dos anúncios oficiais da Anthropic para Sonnet 5.5 e Opus 5.5. São tarifas padrão de API; modo rápido, inferência regional, plataformas em nuvem e acesso por assinatura podem seguir regras de preços ou uso diferentes.
O que os benchmarks realmente mostram
O Sonnet 5.5 fica perto do Opus 5.5 em várias avaliações reportadas pela Anthropic, mas a vantagem muda conforme a tarefa. É exatamente por isso que os dois modelos não devem ser reduzidos a uma única pontuação.
| Benchmark | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 66,4% |
| FrontierCode 1.1 Main | 46,2% no Máximo | 54,4% |
| CursorBench 4.0 | 55,5% | 57,8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
O Sonnet lidera no resultado publicado do Terminal-Bench, enquanto o Opus lidera em FrontierCode, CursorBench, GDPval-AA e AA-Briefcase. A pequena diferença no GDPval-AA chama atenção, mas a Anthropic afirma explicitamente que o Opus continua claramente mais forte na experiência de avaliadores internos e externos em trabalhos complexos e abertos que exigem julgamento sustentado. As configurações de benchmark e os níveis de esforço também diferem, então uma diferença numérica de dois pontos não deve ser confundida com um veredito completo de capacidade.
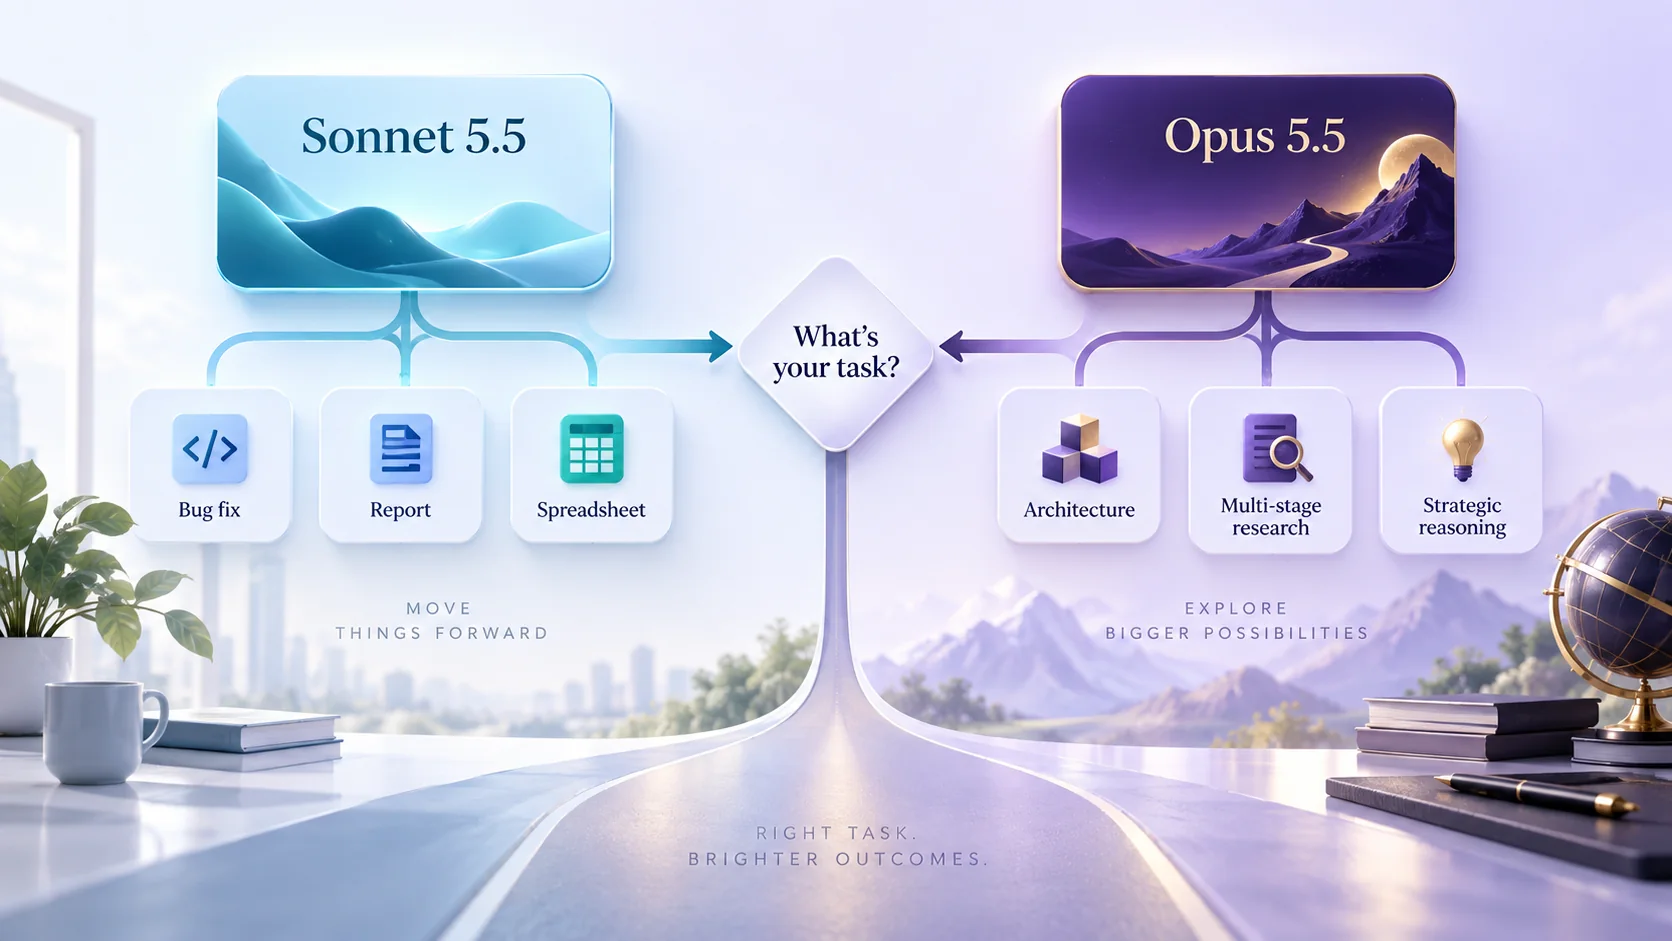
O Sonnet faz sentido quando o sucesso pode ser descrito com clareza e verificado sem interpretações extensas. Exemplos incluem corrigir um bug reproduzível, transformar um conjunto de dados conhecido, resumir uma coleção definida de documentos, redigir uma apresentação a partir de achados aprovados ou aplicar uma reescrita consistente em muitos arquivos. Essas tarefas ainda podem ser exigentes, mas têm limites e uma linha de chegada reconhecível.
A diferença de preço se torna importante em escala. Os tokens padrão de entrada e saída custam metade do valor do Opus, enquanto as leituras de cache têm o mesmo custo. A Anthropic também diz que o Sonnet 5.5 gera a saída mais de 30% mais rápido que o Sonnet 5, embora não apresente essa afirmação como uma comparação direta de velocidade com o Opus 5.5. As equipes devem medir a latência com a própria carga, em vez de presumir que o nome do nível preveja o tempo de resposta em todo ambiente.
Para fluxos de trabalho recorrentes, o esforço ajustável do Sonnet pode ajudar a controlar o custo. Um esforço menor pode ser adequado para classificação, formatação ou rascunhos de rotina; um esforço maior pode ser justificado para mudanças de código ou análises que precisam de mais verificação. A prática importante é definir testes de aceitação e elevar os casos difíceis em vez de usar o esforço máximo para tudo.
Quando o Opus 5.5 justifica seu preço mais alto
O Opus é o candidato mais forte quando o modelo precisa definir o problema enquanto trabalha. Uma migração complexa de código, uma estratégia entre áreas, uma investigação em várias etapas ou uma análise ambígua pode exigir que o modelo revise premissas, equilibre restrições e mantenha a coerência ao longo de uma longa cadeia de ações. São exatamente essas as situações que a Anthropic quer dizer com “julgamento sustentado”.
O cálculo de valor também muda com o risco. Se um revisor sênior precisa passar horas corrigindo uma resposta plausível, mas sutilmente incorreta, economizar em tokens foi uma economia falsa. O Opus pode valer a taxa mais alta quando uma única execução bem-sucedida evita retrabalho significativo, mas ainda assim deve ser avaliado com critérios explícitos; um selo premium não elimina a necessidade de checagens de fonte, testes e aprovação humana.
Codificação: faça o roteamento pelo escopo, não pela reputação
Para codificação, comece pelo limite da tarefa. O Sonnet é um padrão forte para um bug localizado, um endpoint bem especificado, geração de testes ou uma refatoração contida. O Opus é mais defensável para trabalho arquitetural, coordenação entre vários repositórios, uma migração com requisitos incompletos ou uma investigação em que a causa raiz seja desconhecida.
Rode ambos os modelos em uma amostra representativa antes de formalizar o roteamento. Avalie correção, risco de regressão, edições desnecessárias, qualidade dos testes, tempo decorrido, uso de tokens e esforço do revisor. A observação da Anthropic sobre o FrontierCode também é relevante aqui: mais raciocínio pode levar um agente a fazer mudanças fora do escopo solicitado, então qualidade inclui saber quando parar.
Pesquisa e trabalho com documentos
As pontuações do Sonnet quase ao nível do Opus nas avaliações de trabalho com conhecimento da Anthropic o tornam uma escolha convincente para fluxos de documentos estruturados. Se o trabalho é comparar cinco relatórios, extrair campos especificados ou transformar anotações aprovadas em um esboço de deck, o Sonnet pode entregar a qualidade necessária com menor custo. O Opus fica mais atraente quando as fontes entram em conflito, a pergunta de pesquisa evolui ou o modelo precisa criar e defender escolhas interpretativas difíceis.
Qualquer que seja o modelo que você selecione, a preparação das fontes muitas vezes determina a qualidade da saída. Arquivos duplicados, versões pouco claras e contexto ausente podem comprometer até mesmo um modelo forte. O AI Summarizer da iWeaver pode ajudar a organizar arquivos e links mistos em resumos, pontos-chave, briefings executivos ou anotações estruturadas antes de começar a análise em nível mais alto. Isso é um fluxo complementar de informações; não implica que qualquer um dos modelos Claude esteja atualmente selecionável dentro do iWeaver.
Uma regra prática de roteamento
Use o Sonnet primeiro quando a tarefa tiver entradas claras, uma entrega clara e um método de validação direto. Faça escalonamento para o Opus quando o problema continuar ambíguo após esclarecimentos, abranger muitas etapas dependentes, tiver um custo alto de erro ou falhar repetidamente nos testes de aceitação do Sonnet. Essa abordagem geralmente oferece um equilíbrio de custo e qualidade mais útil do que escolher um modelo para cada solicitação.
A decisão final deve se basear na economia de tarefas concluídas. Acompanhe o total de tokens, o uso de cache, as tentativas, a latência, o tempo do revisor e a severidade das falhas em exemplos reais. Os ganhos do benchmark do Sonnet 5.5 o tornam um padrão cotidiano credível; o Opus 5.5 permanece a escolha deliberada quando complexidade e julgamento justificam pagar mais. Para explorar o modelo de menor custo em detalhes, veja Claude Sonnet 5.5: Benchmarks, Pricing, Features & What’s New, ou continue com How to Use Claude Sonnet 5.5.