
A Grok 4.7 já está oficialmente disponível. Lançado em 21 de setembro de 2026, o Grok 4.7 é o modelo de fronteira mais recente da xAI para codificação, tarefas agentic (orientadas a agentes) e trabalhos profissionais de conhecimento.
Isso vai além de uma atualização pequena do Grok 4.6. A xAI diz que o Grok 4.7 usa um novo modelo-base, maior, um ciclo mais longo de reinforcement learning e um treinamento que dá mais peso a tarefas difíceis que podem levar horas para serem concluídas. Ele também aprimora a auto-verificação e o gerenciamento de longos contextos—duas áreas que importam muito mais nos fluxos de trabalho reais do que simplesmente responder prompts curtos. E, ao contrário das primeiras especulações sobre o Grok 4.7, agora temos especificações oficiais e resultados de benchmarks para comparar.
Data de lançamento do Grok 4.7
O Grok 4.7 foi lançado oficialmente. Ele está disponível via a API da xAI como: grok-4.7
No lançamento, a xAI também disponibilizou o modelo em várias plataformas de codificação e IA, incluindo Grok Build e Cursor. O GitHub também começou a disponibilizar o Grok 4.7 para usuários do GitHub Copilot.
Para mais contexto sobre a geração anterior, você também pode conferir nossa análise do Grok 4.6.
Especificações do Grok 4.7 em resumo
Aqui estão as principais especificações oficiais.
| Especificação | Grok 4.7 |
|---|---|
| Data de lançamento | 21 de setembro de 2026 |
| Nome do modelo | grok-4.7 |
| Janela de contexto | 500.000 tokens |
| Corte de conhecimento | Maio de 2026 |
| Modalidades de entrada | Texto e imagem |
| Modalidade de saída | Texto |
| Limite de saída de texto | Sem limite fixo de saída de texto |
| Níveis de raciocínio | Baixo, Médio, Alto, XHigh |
| Raciocínio padrão | Alto |
| Chamada de funções | Suportada |
| Busca na web | Suportada |
| Busca X | Suportada |
| Execução de código | Suportada |
| Suporte à API | Responses API, Chat Completions |
A janela de contexto de 500K é especialmente útil para documentos longos, grandes bases de código, projetos com múltiplos arquivos, tarefas de pesquisa e fluxos de trabalho de agentes que precisam manter muita informação ao longo do tempo.
O Grok 4.7 também oferece suporte a quatro níveis de raciocínio:
- Baixo
- Médio
- Alto
- XHigh
Isso permite que desenvolvedores ajustem o equilíbrio entre velocidade e profundidade de raciocínio de acordo com a tarefa.
O que há de novo no Grok 4.7?
As mudanças mais importantes não são recursos novos e chamativos de interface.
Elas são melhorias na forma como o modelo lida com trabalhos mais longos e mais difíceis.
1. Um novo modelo-base, maior e melhor
O Grok 4.7 foi construído sobre um novo modelo-base maior, em comparação ao Grok 4.6.
Isso importa porque não se trata apenas do Grok 4.6 com um treinamento pós-ajuste adicional.
O próprio modelo subjacente mudou.
Em seguida, a xAI o treinou com um ciclo mais longo de reinforcement learning em uma mistura mais difícil de tarefas, dando mais ênfase a problemas que podem levar muitas horas para serem concluídos.
O objetivo é claro:
fazer o Grok ficar melhor em finalizar trabalhos difíceis—não apenas começá-los bem.
2. Melhor desempenho em tarefas longas
Muitos modelos de IA parecem impressionantes com prompts curtos, mas se tornam menos confiáveis conforme a tarefa fica mais longa.
Isso pode aparecer como:
- instruções esquecidas
- decisões inconsistentes
- trabalho repetido
- dependências ignoradas
- erros que nunca são verificados
- uso ruim do contexto anterior
O Grok 4.7 é treinado especificamente para ter melhor desempenho em tarefas executadas por mais tempo.
Isso é especialmente relevante para agentes de codificação, fluxos de pesquisa, criação de documentos e trabalho profissional que envolve múltiplas etapas.
3. Melhor auto-verificação
Outra mudança importante é a verificação interna mais forte.
Em vez de apenas gerar uma resposta e seguir em frente, o Grok 4.7 foi projetado para verificar seu próprio trabalho com mais cuidado.
Isso importa em tarefas como:
- depurar código
- editar projetos grandes
- verificar cálculos
- revisar documentos
- seguir instruções longas
- usar várias ferramentas em sequência
Claro, auto-verificação não significa que o modelo não pode cometer erros.
A revisão humana ainda é importante em trabalhos de alto risco.
Mas uma checagem interna melhor pode reduzir falhas óbvias durante fluxos de trabalho longos.
4. Agente e trabalho com conhecimento mais fortes
O Grok 4.7 também foi treinado para entender melhor o Grok Bot da xAI.
Isso torna o modelo especialmente relevante para tarefas no estilo de agentes, em que a IA precisa fazer mais do que responder a uma única pergunta.
Por exemplo:
- inspecionar arquivos
- buscar informações
- escrever código
- executar ferramentas
- revisar resultados
- revisar seu próprio trabalho
- continuar até que uma tarefa maior seja concluída
Isso reflete uma mudança mais ampla na IA de fronteira.
A pergunta principal já não é apenas:
O modelo consegue responder a essa pergunta?
Agora, cada vez mais:
O modelo consegue concluir a tarefa inteira?
Benchmarks do Grok 4.7
A xAI publicou resultados de benchmarks comparando o Grok 4.7 com o Grok 4.6 e outros modelos de fronteira.
Os resultados mostram ganhos especialmente perceptíveis em codificação, tarefas baseadas no terminal, engenharia e trabalho profissional de conhecimento.
Para uma comparação mais limpa, a tabela abaixo foca em Grok 4.7 vs Grok 4.6.
| Benchmark | Grok 4.7 | Grok 4.6 | Variação |
|---|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% | +5,9 pts |
| DeepSWE v1.1 | 71,0% | 65,2% | +5,8 pts |
| AA Briefcase v1.1 | 1.657 | 1.546 | +111 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | +17,7 pts |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | +3,8 pts |
| HealthBench Professional | 56,7% | 48,5% | +8,2 pts |
| EEBench | 64,0% | 53,0% | +11,0 pts |
O maior salto neste conjunto aparece em Terminal-Bench 4.0, em que o Grok 4.7 tem 38,0% contra 20,3% do Grok 4.6.
Isso é particularmente relevante para fluxos de trabalho de codificação agentic que envolvem comandos de terminal, ferramentas, repositórios e execução em várias etapas.
O Grok 4.7 também mostra ganhos perceptíveis em benchmarks de engenharia elétrica, trabalho profissional de conhecimento, engenharia de software e raciocínio clínico.
Grok 4.7 vs Grok 4.6
Os números de benchmark tornam a mudança entre gerações mais fácil de enxergar.
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Status | Geração anterior | Geração mais recente |
| Modelo-base | Modelo anterior | Novo modelo-base, maior |
| Janela de contexto | — | 500K tokens |
| Tarefas longas | Forte | Melhorado |
| Auto-verificação | Forte | Melhorado |
| CursorBench 4.0 | 40,4% | 46,3% |
| DeepSWE v1.1 | 65,2% | 71,0% |
| Terminal-Bench 4.0 | 20,3% | 38,0% |
| EEBench | 53,0% | 64,0% |
| Preço de entrada de API | US$ 2 / 1M tokens | Começa em US$ 2 / 1M tokens |
| Preço de saída de API | US$ 6 / 1M tokens | Começa em US$ 6 / 1M tokens |
Portanto, o maior motivo para sair do Grok 4.6 e ir para o Grok 4.7 não é apenas um único recurso de destaque.
É a combinação de:
melhor codificação + melhor desempenho em tarefas longas + melhor gerenciamento de contexto + auto-checagem mais forte.
Se sua demanda consiste principalmente em perguntas curtas do dia a dia, a diferença pode parecer menor.
Para desenvolvedores e usuários que executam fluxos de trabalho longos e em múltiplas etapas, a melhoria é mais significativa.
Preços do Grok 4.7
O Grok 4.7 começa em:
- US$ 2 por 1 milhão de tokens de entrada
- US$ 0,50 por 1 milhão de tokens de entrada em cache
- US$ 6 por 1 milhão de tokens de saída
Essas tarifas se aplicam quando o prompt está abaixo de 200K tokens.
Para prompts acima de 200K tokens, o preço oficial da API aumenta para:
- US$ 4 por 1 milhão de tokens de entrada
- US$ 1 por 1 milhão de tokens de entrada em cache
- US$ 12 por 1 milhão de tokens de saída
Vale notar essa precificação em níveis porque o Grok 4.7 tem uma janela de contexto de 500K.
Usar a janela de contexto completa pode, portanto, custar mais do que solicitações mais curtas.
O Grok 4.7 Fast é o quê?
A xAI também oferece o Grok 4.7 Fast.
Trata-se do mesmo modelo subjacente, executado em infraestrutura mais rápida.
De acordo com a xAI, ele entrega cerca de o dobro da velocidade de saída, com o dobro das taxas padrão de tokens.
No entanto, há uma diferença importante de disponibilidade:
o Grok 4.7 Fast está disponível atualmente via Cursor e Grok Build, mas não via API pública da xAI.
Isso faz com que o modelo padrão do Grok 4.7 seja a principal opção para desenvolvedores que constroem diretamente com a API da xAI.
Onde você pode usar o Grok 4.7?
O Grok 4.7 já está disponível em várias plataformas.
API da xAI
Desenvolvedores podem usar:
grok-4.7
pela xAI Responses API ou Chat Completions API.
Ele suporta ferramentas, incluindo:
- chamada de funções
- busca na web
- busca X
- execução de código
Grok Build
O Grok 4.7 é o modelo padrão do Grok Build, o agente de codificação e criação de apps da xAI.
Cursor
O Grok 4.7 está disponível no Cursor.
A variante Fast também está disponível por lá.
Model Gateways
A documentação da xAI lista disponibilidade por plataformas incluindo:
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
O GitHub começou a disponibilizar o Grok 4.7 para o GitHub Copilot em 21 de setembro.
Ele está sendo disponibilizado em todos os planos Copilot Pro, Pro+, Max, Business e Enterprise.
Ambientes compatíveis incluem:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- agente em nuvem do GitHub Copilot
- aplicativo do GitHub Copilot
- JetBrains
- Xcode
- Eclipse
A distribuição é gradual, então alguns usuários podem não ver isso imediatamente.
Não julgue o Grok 4.7 por um único benchmark
Os resultados oficiais são úteis, mas uma tabela de benchmark não deve ser o motivo final para escolher um modelo.
Benchmarks diferentes testam coisas diferentes.
Um modelo que vai bem em um benchmark de codificação não necessariamente é a melhor escolha para:
- pesquisa
- análise de documentos
- escrita
- suporte ao cliente
- extração de dados
- sumarização
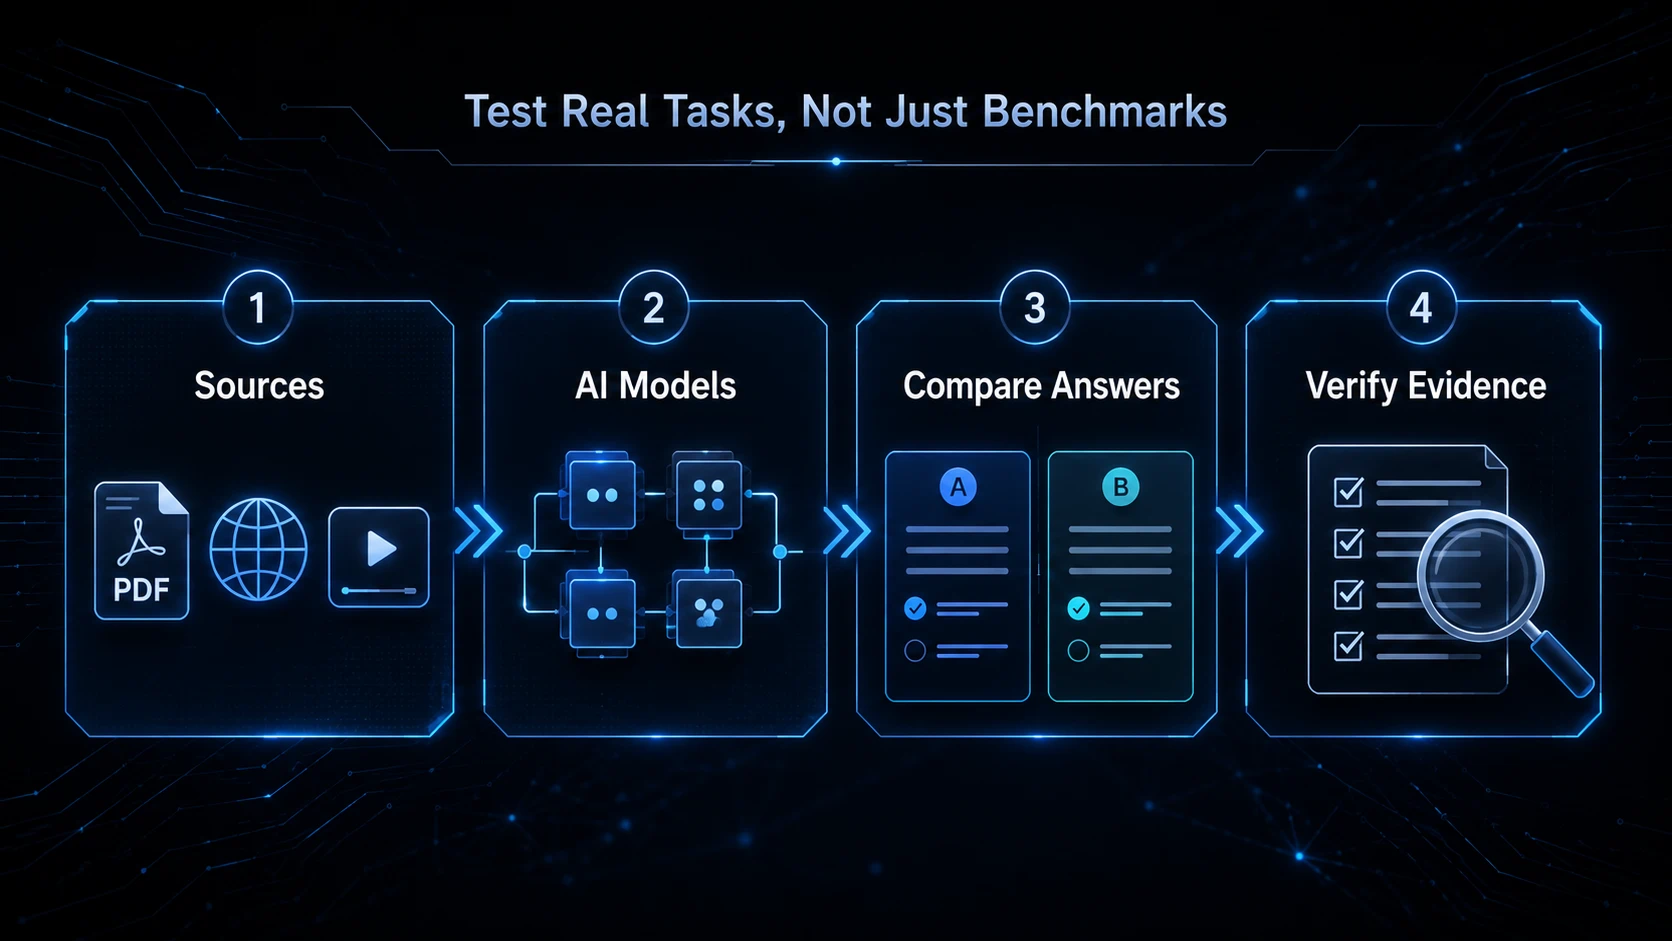
Um teste melhor é comparar modelos usando a mesma tarefa real.
Por exemplo:
- Dê a cada modelo a mesma pergunta.
- Forneça os mesmos arquivos de origem.
- Use as mesmas instruções.
- Compare as respostas finais.
- Verifique informações ausentes e erros factuais.
- Valide conclusões importantes contra as fontes originais.
Se seu trabalho envolver PDFs, sites, vídeos, apresentações ou documentos de pesquisa, ferramentas como iWeaver podem ajudar a organizar esses materiais em um só lugar antes de você comparar as saídas dos modelos.
Isso facilita avaliar se um modelo de IA é realmente útil para seu fluxo de trabalho—em vez de simplesmente ser melhor em um ranking.
O Grok 4.7 vale a pena usar?
Para codificação e fluxos de trabalho agentic, o Grok 4.7 é uma atualização significativa em relação ao Grok 4.6.
Os dados oficiais de benchmark mostram melhorias em engenharia de software, trabalho no terminal, tarefas profissionais, engenharia elétrica, tarefas legais e benchmarks de raciocínio clínico.
A combinação de uma janela de contexto de 500K, melhor desempenho em tarefas longas, auto-verificação aprimorada, suporte a ferramentas e o preço inicial inalterado da API também torna o modelo mais prático para fluxos de trabalho maiores.
Isso não significa que o Grok 4.7 será o melhor modelo para toda e qualquer tarefa.
Modelos diferentes ainda têm forças diferentes, e os resultados de benchmark nem sempre se traduzem diretamente em melhor saída no mundo real.
Mas o Grok 4.7 oferece aos desenvolvedores e usuários profissionais uma opção mais forte do que o Grok 4.6—especialmente quando uma tarefa envolve muitas etapas, grandes volumes de contexto ou uso prolongado de ferramentas.
O Grok 4.7 não é apenas mais uma atualização pequena da Grok.
Ele usa um novo modelo-base, maior, e dá muito mais ênfase a codificação de longa duração, trabalho agentic, auto-verificação e tarefas profissionais de conhecimento.
Em comparação ao Grok 4.6, os números oficiais mostram melhorias claras em vários benchmarks exigentes, enquanto o preço inicial da API permanece inalterado.
A pergunta mais interessante agora não é se o Grok 4.7 tem desempenho melhor do que o Grok 4.6 no papel.
É o quanto dessa melhoria se mantém em projetos reais.
Para desenvolvedores, pesquisadores e usuários que constroem fluxos de trabalho de IA mais longos, é aí que o Grok 4.7 será, no fim, testado.