
O processamento inteligente de documentos (IDP) usa IA e tecnologias relacionadas para transformar o conteúdo de documentos em informações que um fluxo de trabalho pode usar. Um sistema típico classifica documentos recebidos, extrai dados relevantes, valida os resultados e encaminha as informações revisadas para a próxima etapa. O teste real é se o resultado é confiável o bastante para a ação que vem depois — e não se o sistema consegue ler uma página.
A explicação do IDP da AWS descreve essas etapas, incluindo verificações contra regras de negócio ou dados existentes. Essa etapa de validação importa: um valor plausível de um pedido de fatura ainda pode estar errado, e um valor extraído corretamente pode pertencer a uma fatura que seu sistema já recebeu.
Comece com a ação após a extração
Antes de avaliar uma ferramenta, termine esta frase: “Depois que o documento for processado, precisamos…” A resposta pode ser criar um registro, atribuir um revisor, comparar informações com uma ordem de compra ou preparar um briefing. Cada resultado exige verificações diferentes e um nível diferente de automação.
Se a tarefa terminar com uma pessoa lendo um resumo, a compreensão do documento pode ser suficiente. Se a saída altera um registro em outro sistema, você também precisa de um esquema definido, regras de validação e um caminho para exceções. Esses requisitos devem ser estabelecidos antes do piloto, porque apenas uma demonstração de extração não pode mostrar que todo o fluxo de trabalho está pronto.
As etapas de um fluxo de trabalho de IDP
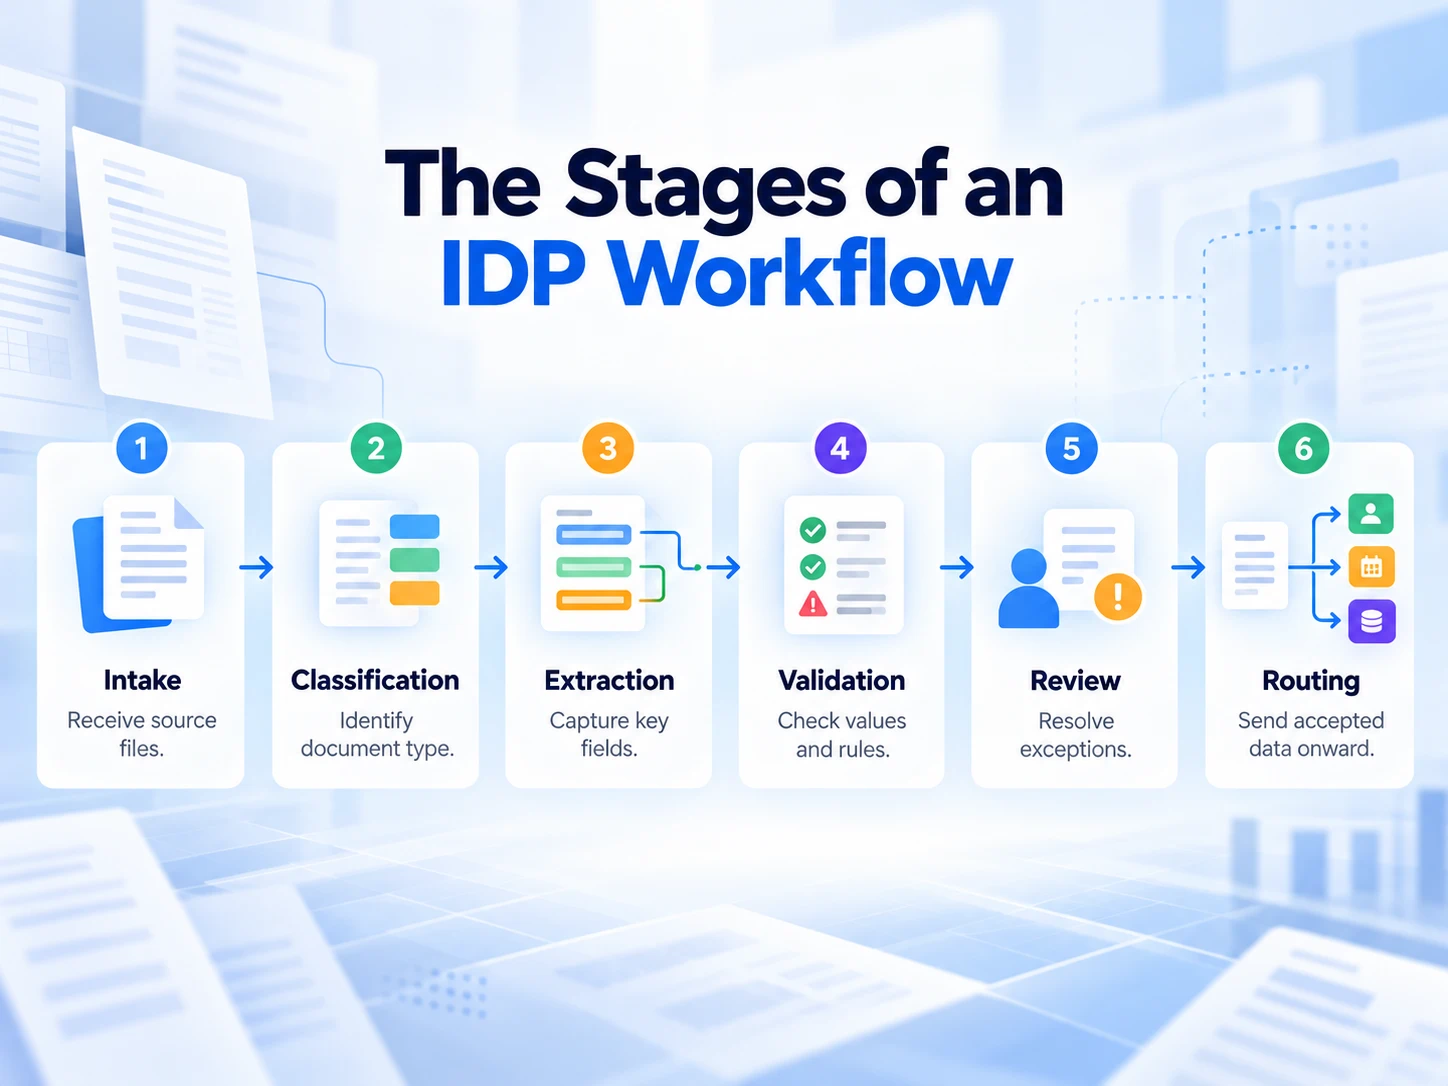
| Etapa | Finalidade | Exemplo de falha que não detectar |
|---|---|---|
| Recebimento (Intake) | Receber e identificar os arquivos de origem | O mesmo arquivo chega duas vezes |
| Classificação | Determinar o tipo de documento ou categoria relevante | Uma nota de crédito é tratada como fatura |
| Extração | Capturar os campos necessários para a tarefa | Um subtotal é capturado como o total |
| Validação | Verificar valores, relacionamentos e informações exigidas | O total falha na regra de cálculo acordada |
| Revisão | Resolver resultados ambíguos ou rejeitados | Uma data pouco clara recebe um palpite injustificado |
| Encaminhamento (Routing) | Enviar as informações aceitas para a próxima etapa | Um registro válido é enviado ao destino errado |
Isso é um modelo de planejamento, e não uma garantia de que todo produto de IDP forneça todas as seis etapas. Verifique quais componentes um serviço oferece e quais você precisa construir ou configurar.
A classificação escolhe a próxima interpretação
Documentos podem parecer semelhantes enquanto servem a propósitos diferentes. Uma fatura, uma ordem de compra e uma nota de crédito podem conter nomes, datas e valores, mas não devem acionar a mesma ação. A classificação determina quais regras de extração e requisitos de revisão se aplicam.
A visão geral de Document Intelligence da Microsoft descreve classificadores personalizados junto com modelos de extração. A distinção mostra por que reconhecer o tipo de documento e extrair seu conteúdo são trabalhos separados. Um fluxo de trabalho também deve definir o que acontece quando o tipo é incerto ou cai fora do conjunto esperado.
A extração precisa de uma definição clara de cada campo
“Extrair a data” é ambíguo quando um arquivo contém a data de emissão, a data do serviço e o prazo de pagamento. Defina o campo que você precisa e a forma como ele deve aparecer na saída. Inclua regras para valores ausentes e preserve as informações necessárias para verificar a extração.
Por exemplo, um esquema de fatura pode solicitar o nome do fornecedor, número da fatura, data da fatura, moeda, total e imposto. Essas definições de campo devem especificar qual valor escolher quando o documento apresentar vários candidatos. Adicionar um campo é fácil; decidir o que conta como um resultado correto exige mais cuidado.
A validação verifica mais do que legibilidade
Algumas verificações confirmam que um valor tem o formato esperado. Outras verificam relações dentro do documento ou comparam dados extraídos com um registro confiável. Uma data pode estar corretamente formatada, mas representar o evento errado; e um total pode estar legível, porém inconsistente com os itens.
Defina a regra de negócio e a ação quando ela falhar. Por exemplo, um número de fatura ausente pode exigir revisão, enquanto uma combinação repetida de fornecedor e número de fatura pode acionar uma verificação de duplicidade. Passar na verificação de formato não deve autorizar automaticamente uma ação a jusante.
Um exemplo prático de fatura
Imagine uma fatura de fornecedor com estes detalhes: a data de emissão é 5 de março, a data de vencimento é 4 de abril, o subtotal é 1.000 e o total é 1.080. A moeda não é impressa com clareza suficiente para determinar. Este é um exemplo ilustrativo, não um resultado medido de um teste de produto.
Um sistema de extração pode retornar um registro com boa aparência, usando 4 de abril como data da fatura, 1.000 como total e uma moeda estimada. Cada valor é plausível isoladamente. Juntos, eles mostram por que um fluxo de trabalho de IDP precisa de significados explícitos para os campos e regras de revisão.
| Campo solicitado | Valor revisado | Verificação de aceitação |
|---|---|---|
| Data da fatura | 5 de março | Use a data de emissão, não a data de vencimento |
| Data de vencimento | 4 de abril | Mantenha separada da data da fatura |
| Total | 1.080 | Identifique o total final e inspecione seus componentes |
| Moeda | Não resolvida | Deixe não resolvida e solicite revisão |
A próxima etapa correta é resolver a moeda antes de usar o registro onde a moeda importa. Um registro completo criado por suposição é menos útil do que um registro incompleto que identifique claramente o que um revisor precisa verificar.
OCR, Document AI, IDP e RPA
O Document AI do Google oferece processadores para OCR, extração e classificação. Esses componentes mostram como um fluxo de trabalho pode usar diferentes capacidades para diferentes etapas. A existência de um extrator não diz se suas regras de validação ou o tratamento de exceções foram implementados.
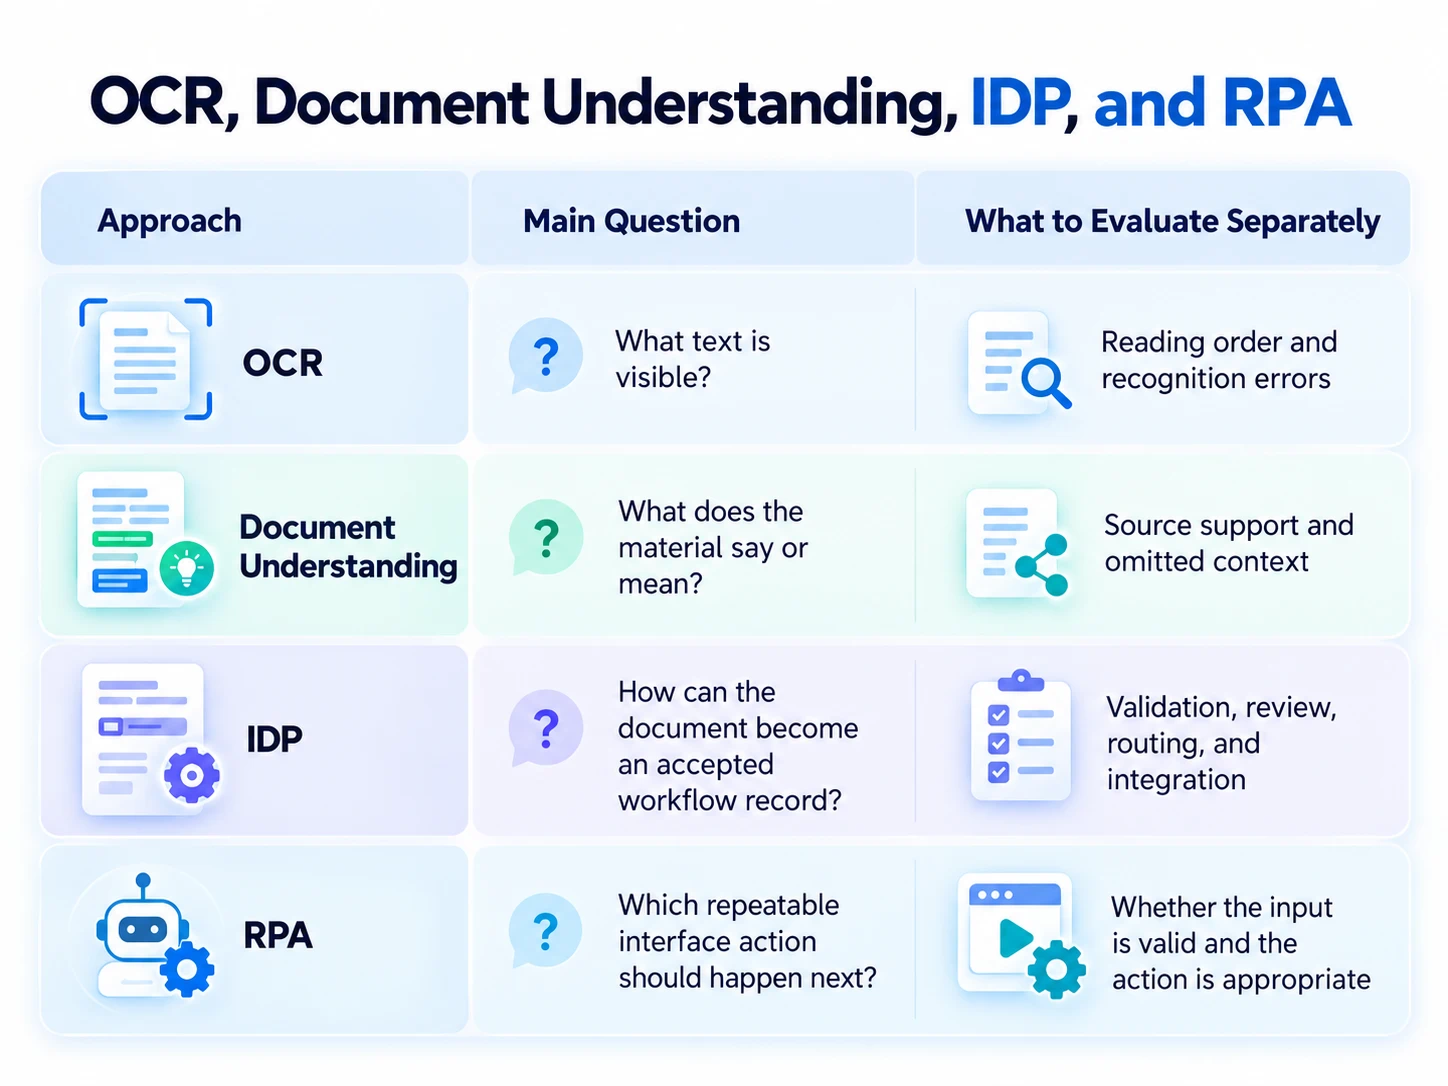
| Abordagem | Principal pergunta que responde | O que avaliar separadamente |
|---|---|---|
| OCR | Qual texto está visível? | Ordem de leitura e erros de reconhecimento |
| Compreensão de documento | O que este material diz ou significa? | Suporte da fonte e contexto omitido |
| IDP | Como o documento pode se tornar um registro aceito do fluxo de trabalho? | Validação, revisão, encaminhamento e integração |
| RPA | Qual ação de interface repetível deve acontecer em seguida? | Se a entrada é válida e se a ação é apropriada |
Os limites são práticos, não absolutos: produtos podem combinar várias abordagens. Use essa distinção para fazer melhores perguntas de avaliação, em vez de presumir que um rótulo de marketing define todo o sistema.
Onde a IA generativa ajuda — e onde as regras ainda importam
Modelos generativos podem interpretar instruções e linguagem variada, o que os torna relevantes para extração e compreensão de documentos mais flexíveis. O Google descreve um extrator personalizado baseado em IA generativa em sua oferta de Document AI. Isso dá suporte à alegação de capacidade desse produto; não estabelece um nível universal de precisão para todo arquivo ou fluxo de trabalho.
Para um piloto de IA de processamento inteligente de documentos, defina o que o modelo está autorizado a inferir. Algumas tarefas precisam de um valor normalizado; outras exigem uma transcrição direta. Mantenha esses modos distintos para que os revisores possam dizer se um campo veio de uma declaração explícita ou de uma interpretação.
Um prompt pode pedir “usar null quando ausente”, mas o fluxo de trabalho ainda deve verificar a saída. Não dependa de explicações fluentes como evidência de que um campo está correto. Revise o trecho de origem relevante, a definição do campo e qualquer regra aplicada após a extração.
Como projetar um piloto de IDP útil
Escolha uma família de documentos e um resultado
Comece com uma tarefa delimitada, como extrair campos especificados de faturas de fornecedores para revisão. Defina o que o piloto vai produzir e quem vai inspecionar as exceções. Expandir para várias famílias de documentos antes de o primeiro fluxo de trabalho ser entendido pode tornar as falhas mais difíceis de diagnosticar.
Crie um conjunto de avaliação representativo
Inclua exemplos comuns e as variações que você espera receber: campos ausentes, layouts desconhecidos, documentos com várias páginas, digitalizações ruins e duplicidades. Faça com que um revisor estabeleça os resultados esperados antes de testar. Mantenha um conjunto separado “em espera” para que a avaliação final inclua arquivos que não orientaram suas escolhas de configuração.
Meça resultados no nível certo
A correção de campos e a aceitação do documento respondem a perguntas diferentes. Um sistema pode capturar a maioria dos campos corretamente, mas ainda assim faltar com frequência o único campo necessário para concluir a tarefa. Registre quais campos falham, com que frequência os documentos precisam de revisão e o que torna um registro pronto para a próxima etapa.
Use essas definições de forma consistente:
- Corretude do campo: campos avaliados como corretos divididos por todos os campos avaliados, usando uma regra de correspondência documentada.
- Taxa de revisão: documentos que exigem revisão humana divididos pelos documentos processados.
- Taxa de aceitação: documentos que atendem a todas as verificações de aceitação definidas divididos pelos documentos processados.
- Esforço de revisão: tempo gasto resolvendo exceções, medido com um ponto de início e um de fim consistentes.
Estas são medidas de avaliação sugeridas, não alegações de desempenho. Separe campos ausentes de valores incorretos e registre falhas a jusante, além de erros de extração. Essa distinção ajuda você a decidir se deve melhorar o parsing, reescrever a definição de um campo ou ajustar o caminho de revisão.
Teste o tratamento de falhas antes de aumentar a automação
Verifique o que acontece quando um arquivo não pode ser lido, quando o tipo de documento é desconhecido ou quando os campos necessários entram em conflito. O fluxo de trabalho deve tornar a condição não resolvida visível e preservar contexto suficiente para um revisor. Confirme que um registro rejeitado não seja encaminhado silenciosamente para o próximo sistema.
Se você avaliar uma ferramenta “IDP AI”, peça para ver o caminho de exceção com seus próprios documentos representativos. Uma demonstração bem-sucedida deve incluir como uma falha é tratada, não apenas como um arquivo comum é processado.
Onde o iWeaver se encaixa
Algumas tarefas de documentos terminam com compreensão, e não com um registro operacional. Se você estiver lendo relatórios ou preparando um briefing, o iWeaver oferece resumos, conversa com IA e organização de conhecimento. Seu AI Document Summarizer pode ser um ponto de partida para revisar material de origem e decidir o que merece mais atenção.
Por exemplo, peça uma visão geral das alegações, evidências e limitações de um relatório antes de planejar sua análise. O fluxo de trabalho público de documentos do iWeaver oferece resumos personalizados e exploração posterior. Verifique a fonte original sempre que um fato for importante e avalie separadamente quaisquer capacidades necessárias de extração ou integração corporativa.
Perguntas para fazer antes de escolher um sistema de IDP
O processamento inteligente de documentos é o mesmo que OCR?
O OCR se concentra em reconhecer texto. Um fluxo de trabalho de IDP adiciona tarefas como classificação, extração, validação, revisão e encaminhamento. Identifique quais dessas etapas sua tarefa realmente precisa antes de comparar produtos.
O IDP pode rodar sem revisão humana?
Isso depende dos documentos, dos critérios de aceitação e das consequências de um erro. Defina quais resultados podem seguir automaticamente e quais exigem revisão. Use evidências do piloto para estabelecer essas regras, em vez de presumir que automação é apropriada para toda entrada.
Como um fluxo de trabalho de IDP deve lidar com informações ausentes?
Representar o valor ausente explicitamente e aplicar uma regra definida. Um campo obrigatório pode causar rejeição ou revisão; um campo opcional pode permanecer vazio. A suposição de um valor ausente pode tornar o resultado mais difícil de auditar e inseguro para usar na próxima etapa.
O que eu devo testar primeiro?
Teste se os campos necessários para a próxima ação são capturados e validados corretamente. Em seguida, teste exceções, duplicidades e o destino de registros aceitos. Uma pontuação de extração de alto nível não é suficiente se o campo crítico ou o caminho de falha continuar pouco confiável.
Torne a primeira revisão do fluxo de trabalho possível
Escolha uma tarefa de documento estreita, defina a saída aceita e teste tanto arquivos comuns quanto exceções. Trate a extração como uma etapa em um processo cujo resultado final precisa ser verificado. Quando seu objetivo imediato é entender um documento, comece com um resumo baseado na fonte e use-o para orientar sua revisão.