
AI 第二大脑,是一套把个人资料和 AI 能力结合起来的工作系统。它可以帮助你快速找回上下文、梳理想法,并把已有信息转化成真正能用的成果。这个系统里可以包含项目笔记、文档、阅读摘录,以及之后还需要重新查看的重要决策。
它真正有价值的时刻,往往是你隔了一段时间重新回到某个项目时。你应该能快速知道之前做到哪里、为什么当时这样决定,以及下一步该做什么,而不是重新翻聊天记录、找文件,再靠记忆把整个过程拼起来。
最简单的开始方式,是选一个你这周还会继续推进的项目。这样,你的第二大脑从一开始就有明确任务,也能马上验证它到底有没有用。
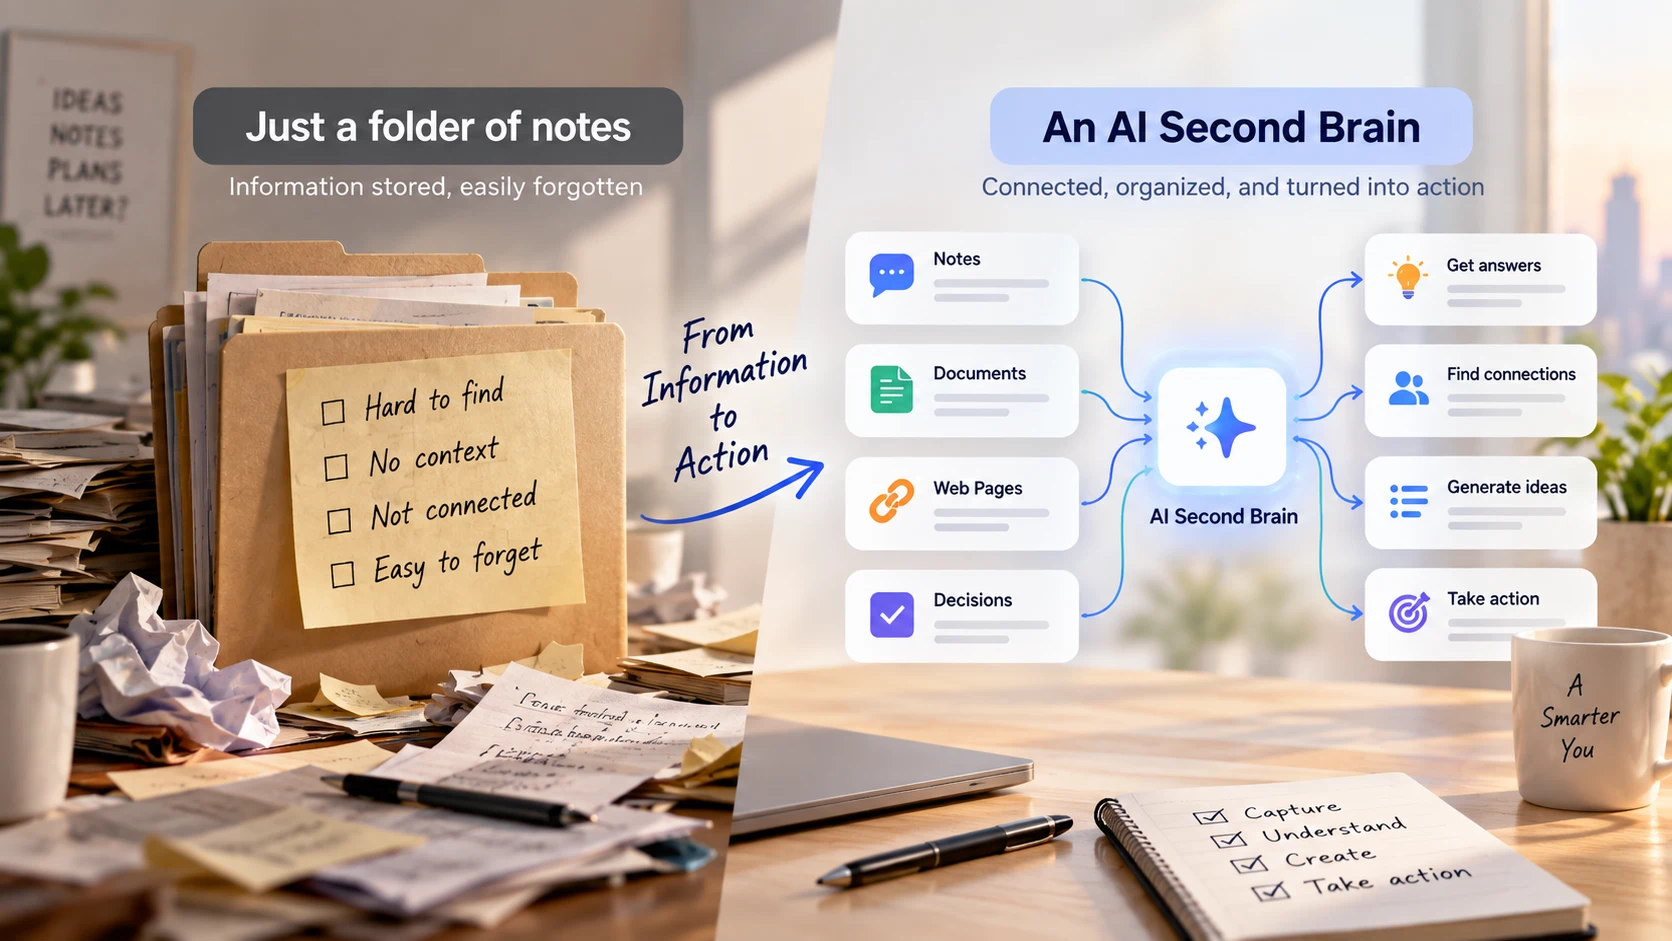
它为什么比普通的笔记文件夹更有用?
普通文件夹解决的是“资料放在哪里”。AI 第二大脑进一步解决的是:如何围绕这些资料提问、对比信息,以及利用已经积累的上下文继续工作。
目前并没有一种所有产品都采用的统一实现方式。有些工具需要手动上传资料,有些支持外部集成,也有些可以保留部分长期上下文。每次使用时,都应该先确认当前工具实际能访问哪些信息。
| 组成部分 | 包含什么 | 为什么重要 |
|---|---|---|
| 原始资料 | 原始文档和相关笔记 | 让回答有明确的信息依据 |
| 项目上下文 | 目标、限制、术语和当前进度 | 让回答更贴近你的实际项目 |
| AI 工作区 | 当前选中的资料和你的问题 | 用于总结、对比和起草内容 |
| 已审核成果 | 已确认的简报、决策和下一步 | 保留已经完成的思考结果 |
“第二大脑”这个概念本身早于现在的 AI 工作流。Tiago Forte 的 Building a Second Brain 方法,把信息处理概括为收集、整理、提炼和表达。AI 可以帮助完成其中一部分,但什么值得保存、什么最重要,最终还是要由你的目标和判断决定。
先写下你希望它帮助完成的具体结果。
比如,“帮我准备每月一次的用户研究简报”就是一个不错的起点。相比之下,“帮我管理所有知识”太宽泛了,其中还有很多问题没有定义清楚。
可以先创建一份简短的项目背景说明:
项目: 每月用户研究简报
**受众: 产品团队和客户成功团队
**目标: 找出值得进一步研究的重复性 onboarding 问题
**范围: 当前复盘周期内的用户反馈
**输出: 一页简报,包括证据和待确认问题
**限制: 区分个别用户反馈和反复出现的共性问题
把它当成一个可以持续更新的文档。项目目标或范围发生变化时,就及时修改。如果你使用的工具不会自动保留这些信息,那么每次开启新会话时,都可以把最新版本重新提供给它。
第二步:先收集最小但够用的资料集
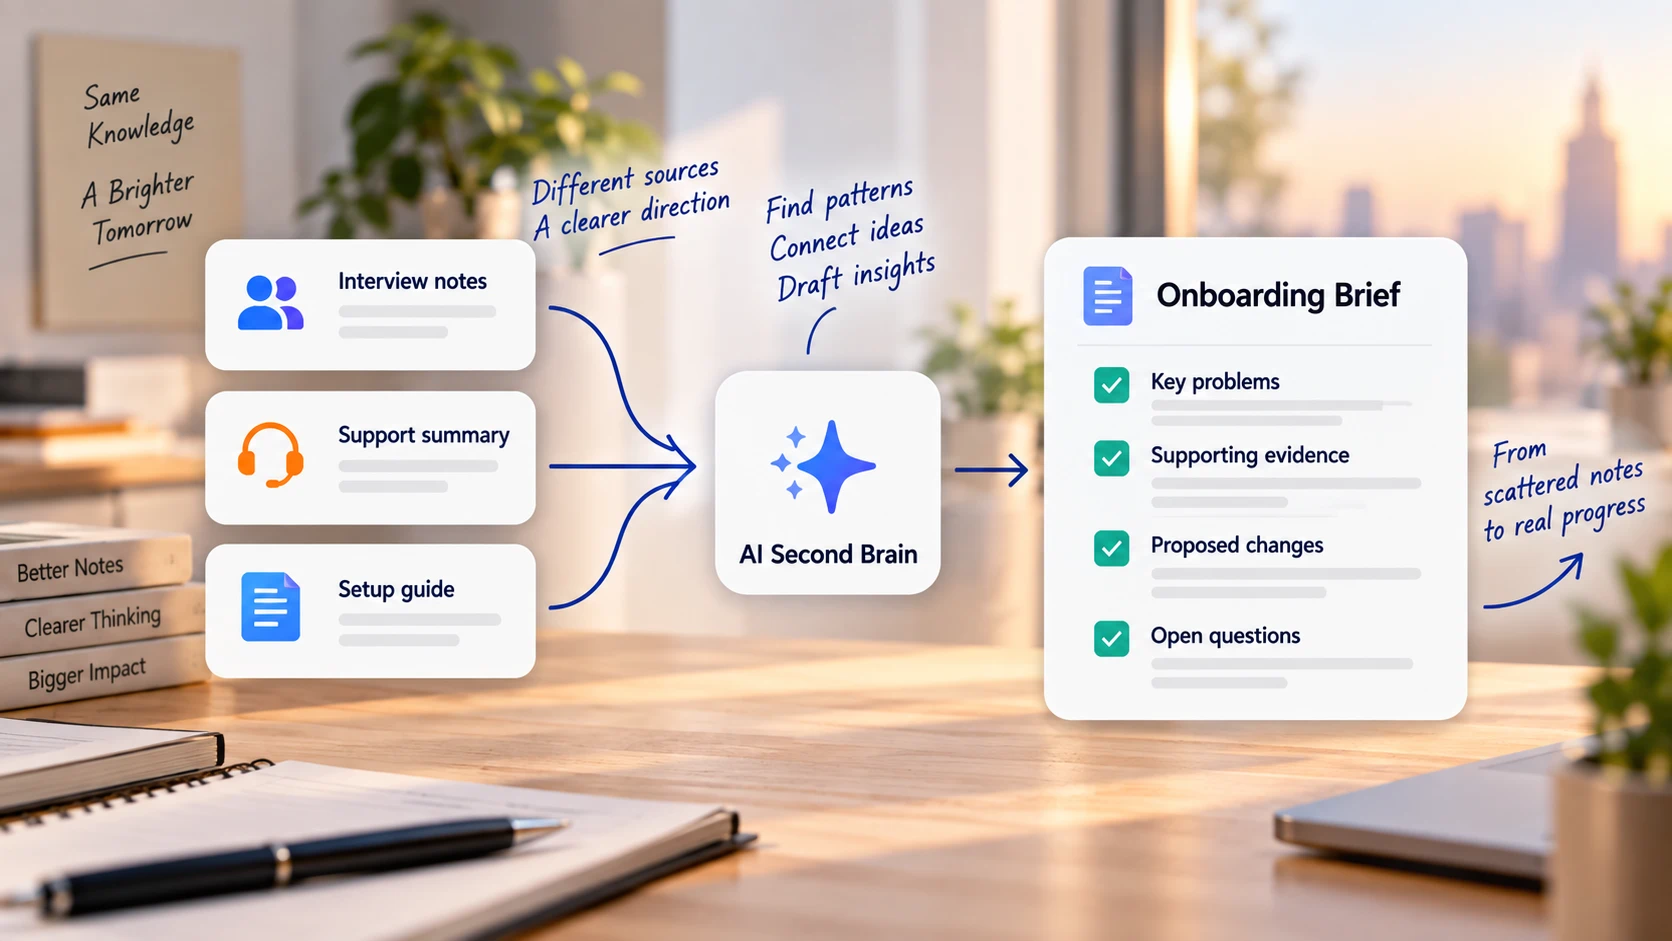
先准备足够回答第一个问题的材料。以用户研究简报为例,可以包括用户访谈笔记、客服问题汇总,以及当前的 onboarding 指南。
保留原始文件,并给它们起清晰的名称。如果时间和版本会影响理解,也要记录日期和版本信息。
对于篇幅较长的文档,可以先使用 iWeaver 的 AI文档总结 提取重点,再进行深入阅读。最好把核对过的摘要和原始文档放在一起,这样既能快速查看概览,也能随时回到具体细节。
不要因为“手上有这些资料”就全部导入。只有当某份资料能帮助回答当前项目问题,或者解释一个重要限制时,再把它加入项目。
第三步:先问一个可以核实的问题
刚开始时,最好先问一个答案能够直接从现有资料里找到的问题。这样可以同时验证两件事:工具是否正确读取了资料,以及它对内容的理解是否准确。
如果是 PDF,可以使用 iWeaver 的 PDF对话 针对文档提问。先从一个明确的问题开始,例如:“这份指南里包含哪些账号设置步骤?”然后把回答和原文对应部分进行核对。
确认基础信息没有问题后,再逐渐进入需要更多判断的问题:
| 问题类型 | 示例 | 需要检查什么 |
|---|---|---|
| 信息回顾 | Interview A 提到了什么问题? | 核对原始表述 |
| 信息对比 | 两组笔记里都出现了哪些问题? | 确认两份资料描述的是同一类问题 |
| 原因分析 | 为什么用户会反复在这里感到困惑? | 区分证据和可能的解释 |
| 下一步建议 | 接下来应该优先调查什么? | 检查可行性和缺失信息 |
处理一组指定资料时,可以使用这样的提示词:
只使用当前项目中提供的资料回答问题。对于每一条重要结论,请标明对应来源,并尽量指出相关章节或原文位置。将已有明确依据的事实、你的分析判断,以及尚未回答的问题分别列出。如果现有资料不足以支持结论,请直接说明缺少什么。不要编造引用或出处。
这类提示词可以帮助你明确希望得到什么样的回答,但并不能保证结果一定正确。重要内容依然要回到原始资料核对。
第四步:把对话结果变成可以长期使用的成果
当一段对话已经产生了有价值的结果,就不要让它只停留在聊天窗口里。把它整理成真正能复用的内容,比如简报、提纲、决策记录或项目更新。
以用户研究为例,可以这样要求:
起草一份一页简报,包含四个部分:已发现的问题、对应证据、建议进一步调查的问题,以及当前局限。把建议和已经确认的事实分开。除非现有资料能够支持,否则不要推断某个问题出现得有多普遍。
审核完成后,把最终版本保存下来。同时记录这份简报基于哪些资料,以及审核日期是什么,这样以后再看到它时,你能清楚理解它的适用范围。
如果需要更直观地查看整体结构,也可以使用 iWeaver 的 文本转 Mind Map 把已经核对过的笔记整理成思维导图。思维导图适合展示主题和待解决问题,但具体证据仍然应该保留在原始笔记中。
第五步:记录决策,也记录为什么这么决定
第二大脑真正变得有用,是从它开始保存“为什么”之后。
每次做完一个重要决定,可以记录:
- 做了什么决定,以及决定时间
- 哪些资料或观察支持这个决定
- 当时考虑过哪些其他方案
- 哪些问题目前仍然不确定
- 什么情况出现时需要重新评估
例如:“我们会进一步调查账号设置说明,因为两次用户访谈都提到了这个步骤存在困惑。目前还无法确认这个问题有多普遍。收集更多反馈后再次评估。”
这条记录保留了证据、适用范围和不确定性。相比之下,如果只留下一个“优化 onboarding”的任务,过一段时间后很容易失去原本的上下文。
做一次“重新回到项目”的测试
在继续扩展系统之前,先离开这个项目,然后在新的会话中重新回来。只使用工具当前真正能够访问到的资料和上下文。
问自己四个问题:
- 这个项目现在要完成什么?
- 我们已经确认了哪些事情?依据是什么?
- 还有哪些问题没有解决?
- 接下来应该做什么?
如果这些问题答不完整,就说明系统里还有缺失的部分。可能是项目说明已经过时、某份关键资料在当前会话中无法访问,或者某个重要决定只存在于旧聊天记录里,没有单独保存。
先补上这些缺口,再继续增加更多资料。一套规模不大、但你隔一段时间回来依然能直接继续工作的系统,比一个资料很多却无法放心使用的知识库更有价值。
AI 第二大脑会自动记住所有内容吗?
不要默认它会。不同产品在信息保存、长期上下文和新会话访问能力上差别很大,也会受到设置和使用方式影响。你需要确认哪些内容会被保存、新会话里还能访问哪些内容,以及是否需要重新选择或提供资料。
不会编程,也可以搭建 AI 第二大脑吗?
可以。最初完全不需要复杂开发。你可以从一份项目说明、一组随时可以访问的原始资料,以及一个能够基于这些资料工作的 AI 工具开始。外部集成可以等基础流程验证有效后再考虑。
经常变化的信息应该怎么处理?
保留一份明确的“当前版本”。当项目目标、规则或背景发生变化时,及时更新项目说明,并把旧内容标记为已过时或已被替代。如果存在多个版本,可以让 AI 主动指出冲突,而不是把不同时间的信息直接混在一起。
添加公司的私密工作资料前,需要检查什么?
先确认这些资料是否允许上传到对应工具,同时查看当前服务的数据处理方式、隐私设置和使用条款。只提供完成任务真正需要的信息,不要为了方便一次性上传无关资料。
最好的起点,不是建立一个庞大的知识库,而是从下一个你一定还会重新打开的项目开始。保存它的背景,整理真正相关的资料,产出一份审核过的成果,然后过一段时间再回来,看看你是否能更快进入状态,而不是重新从头梳理一遍。