
Claude 发布了最新模型Haiku 5.5,目的很明确:让频繁、范围较窄的 AI 任务更具成本效益。Anthropic 将其定位用于诸如总结、分类,以及更大规模的智能体工作流中的小型任务等场景。对于处理研究资料和文档的读者来说,最关键的问题在于:快速模型能在哪些方面负责常规准备,而将更具挑战性的解读留给更深入的审查。
这次发布值得关注,但其“首要标价”需要放在合适的语境中。提示词长度会影响 API 的计费速率,而模型的“每个 token 成本”并不能告诉你一个完整工作流到底要花多少钱。以下是你在为下一个项目选择 Haiku 5.5 之前需要了解的要点。
Claude Haiku 5.5 有哪些新内容?
Haiku 5.5 为 Haiku 系列增加了可调节的“投入力度(effort)”,让用户可以控制模型思考得有多深入。官方模型概览列出了自适应思考、一个百万 token 的上下文窗口、文本与图像输入,以及文本输出。这些是模型能力;特定应用可能会只提供较少的控制选项或输入选项。
这种区别在比较工具时尤为重要。一个模型可以支持较大的上下文窗口,但并不代表每个界面都能让你提交那么多材料。同样,“理解图像”不等于“生成图像”,而 API 中的努力参数也不保证每一款面向消费者的产品都提供同样的努力选择器。
实际的变化体现在“小模型类别”里的灵活性。一个快速的排序任务和一个细致的文档抽取任务,并不需要相同的指令,也不需要同样的推理量。Haiku 5.5 让开发者能够更好地掌控这种权衡;而日常用户则应检查自己所选界面实际上提供了哪些控制项。
Claude Haiku 5.5 定价
Anthropic 公布的标准 API 费率使用两个提示词长度档位。以下数字以“美元/百万 token”为单位,描述的是 Claude Platform 的定价,而不是订阅费或第三方应用的收费。
| 提示词长度 | 输入 tokens | 输出 tokens |
|---|---|---|
| 最多 100,000 tokens | $0.10 | $0.50 |
| 超过 100,000 tokens | $0.50 | $2.50 |
对于不超过 100,000 tokens 的提示词,所列的 token 费率比 Haiku 4.5 低 90%。超过该阈值后,降幅为 50%。Anthropic 还单独估算了大约 75% 的平均运营成本降低幅度,这与其此前的请求结构以及 token 使用变化有关。上述百分比对应的是不同的对比方式,不能混用。
举个简单例子:一个包含 20,000 个输入 tokens、2,000 个可计费输出 tokens 的请求,在较低的标准费率下大约花费 $0.003。一个包含 120,000 个输入 tokens、相同可计费输出数量的请求,在较高费率下大约花费 $0.065。这些计算不包含缓存、折扣、工具调用费用以及任何额外可计费 tokens;它们是示例,而不是对典型文档成本的估算。
最有用的结论是衡量“完整请求”的成本。增加更多背景信息、保留更长的对话,或要求更长的回复,都可能影响最终账单。在把现有工作流迁移到 Haiku 5.5 之前,请对照实际 token 使用量以及结果需要多少修正。
Haiku 5.5 在文档工作中的位置
Anthropic 将分类、抽取、路由(routing)以及子智能体任务列为其预期用途。这意味着一个实用的起点:给 Haiku 一个边界清晰的任务,以及一个你能检查的输出,而不是要求它在一次回复中解决一整个研究项目。
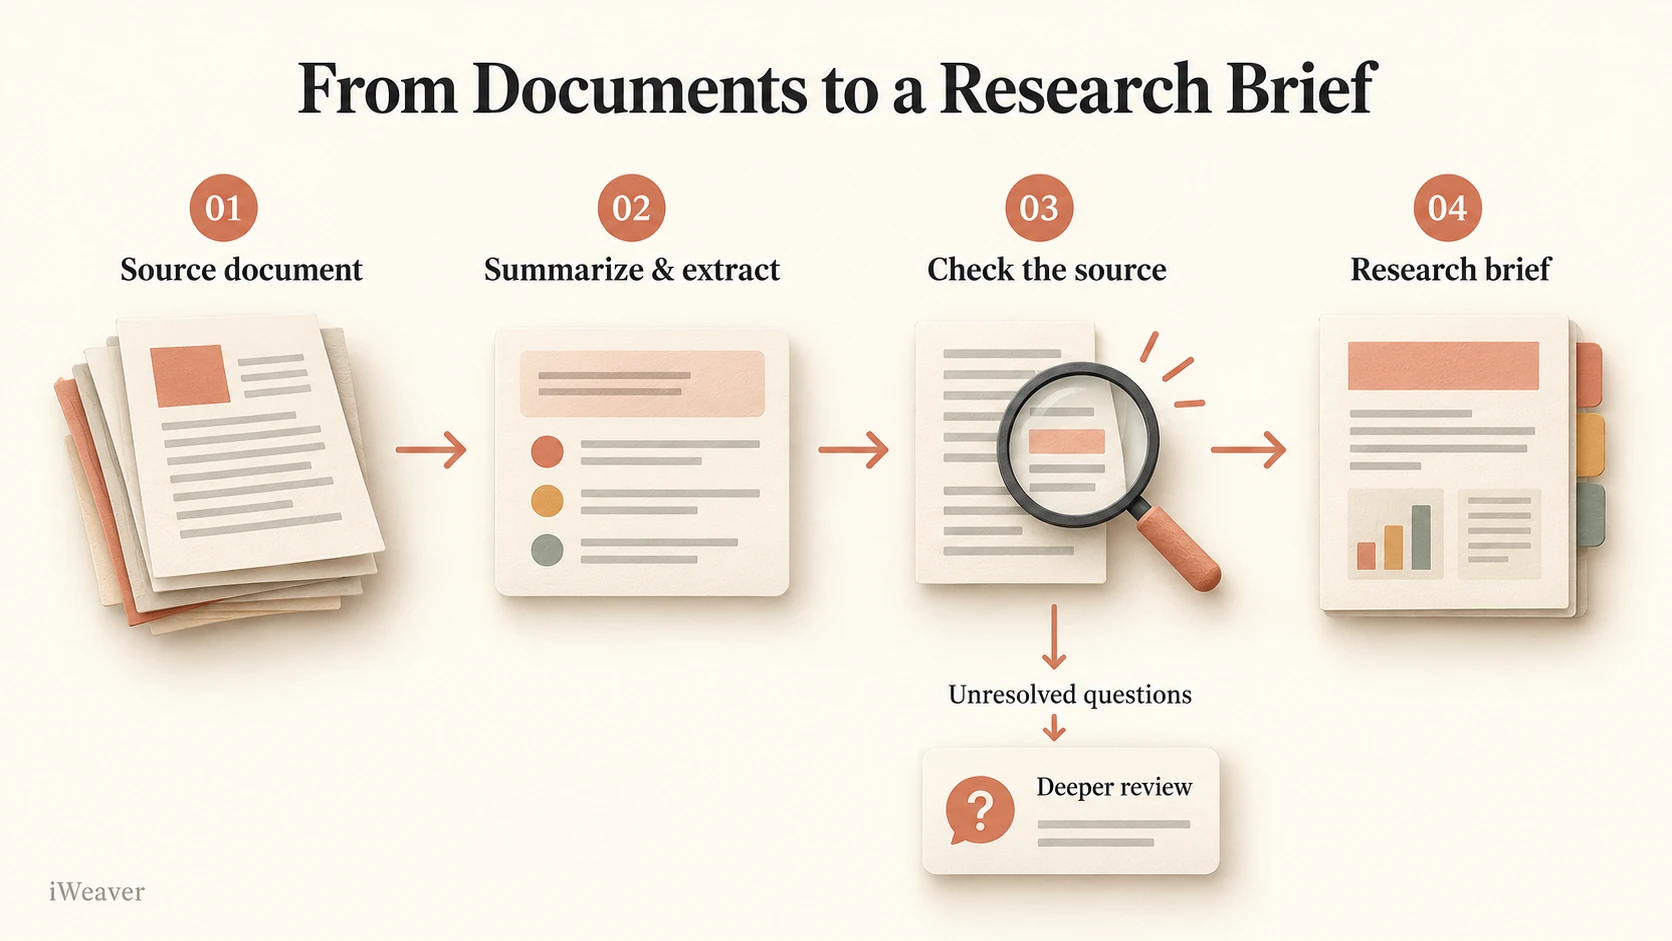
想象一个研究报告文件夹。第一个工作可能是识别每份报告的主题、发布日期和核心问题。下一步可能是将已陈述的发现提取到一个一致的表格中。只有在完成这些准备之后,你才去问:哪些发现彼此一致、哪些方法存在差异、还有哪些问题尚未得到解决。以上是对编辑流程的建议,而不是我们声称已在这些报告上测试过 Haiku 5.5。
| 任务 | 有用的输出 | 需要检查什么 |
|---|---|---|
| 对进入的材料进行排序 | 带简短理由的主题标签 | 含糊不清的文档和不一致的标签 |
| 准备初步摘要 | 主要观点及其支撑细节 | 缺失的限定条件,以及含义变化 |
| 抽取可对比的事实 | 带来源位置的表格 | 单位、日期、缺失值,以及归因信息 |
| 准备交接材料 | 发现、不确定性和未解决问题 | 下一位审阅者能否追溯证据 |
提示词
将此提示词用于一份你可以与答案并行核对的文档。它会提供结构化的阅读辅助,并将未经支持的解读与抽取内容分开。
阅读所提供的文档,并准备一份研究简报。

使用以下部分:
1. 主问题:文档要解决什么问题?
2. 关键发现:识别来源中最多五条已陈述的发现。
3. 支撑证据:如果在所提供材料中可用,为每条发现给出对应的章节或页码
4. 局限性:保留作者的资质与说明中的注意事项。
5. 开放问题:列出文档未能解决的议题。

仅使用所提供材料。如果某个细节或来源位置
不可得,请说明。将你的解读与来源陈述分开。
不要杜撰引文、统计数据或页码。
收到简报后,可以从原始文档中核对几条发现。若某句话把不同章节的细节合并在一起,请让模型将它们拆开,并标识支撑段落。只有当摘要保留了你在工作中所需要的差异时,它才会真正变得有用。
你应该使用多少“投入力度”?
Anthropic 的提示词指导建议从 medium 开始——它是 Claude API 以及 Claude Code 中的默认设置。该指导将 high 描述为适用于知识工作与更长任务;而更高的等级应当通过评估带来的额外收益来证明其成本。指导中也提到,更长时间的思考会影响回复长度与 token 消耗。对于文档工作流,建议在比较界面所支持的不同设置时,保持来源与提示词不变。评估答案是否保留了局限性说明、是否遵循了格式、以及是否识别出缺失信息。选择能在合理复核成本下产生可接受结果的设置;仅仅回复更长并不意味着质量更高。
什么时候 Sonnet 或 Opus 可能是更好的选择
Anthropic 继续建议在复杂的智能体式编码工作中使用 Sonnet 5.5 和 Opus 5.5。Haiku 的预期角色包括更小、更清晰定义的任务,它们可以支撑更大的工作流。因此,这次发布给用户提供了另一种路由选项,而不是宣称某一个模型才是每个任务的最佳选择。
对于研究工作,这个选择应取决于你自己的具体案例。一个能够很好地抽取字段的模型,仍可能在解释相互矛盾的证据时遇到困难。如果任务需要在多个来源之间进行持续解读,请在相同材料上对比更大的模型,并评估其生成结果(包括修正所需的时间)。我们的 Claude Sonnet 5.5 概览 还提供了该系列中另一款模型的背景信息。
把模型输出转化为可复用的工作流
选择模型只是知识工作的一部分。你还需要保持源材料可随时获取、审查解读内容,并把有用的结果整理成下一项任务的输入。iWeaver 的文档工作流包含摘要、解释与结构化洞见;它的 PDF Explainer 可以帮助你逐步处理 PDF 中的难点章节,并让你索取更清晰的解释或示例。
Claude Haiku 5.5 现已在 iWeaver 中提供,并且 iWeaver 也提供该模型的免费试用。你可以从一份文档简报、一个抽取任务,或关于你源材料的聚焦问题开始。在把答案转成笔记或报告之前,请先用原文核对回复内容。
在你第一次评估 Haiku 5.5 时,选择一个小而可重复的任务:一份文档简报、一张抽取表,或一次分类流程。明确一份“可接受答案”必须包含哪些内容,对照源材料检查,并记录需要进行多少次修订。这样你就能获得比仅靠一个标题式价格或单一宽泛基准更有用的采用依据。