
Claude Opus 5.5 和 OpenAI 的 GPT-6 家族如今正为许多相同的高要求 AI 工作负载展开竞争——但它们采取的是不同路线。
Anthropic 将 Claude Opus 5.5 定位在长期运行的智能体式编程与专业知识工作上。OpenAI 则将 GPT-6 拆分为三个模型:Astra 面向最难的端到端任务,Sol 用于复杂编程与智能体工作流,Luna 则面向聚焦的高吞吐工作负载。
因此,真正有用的对比不再仅仅是 Claude vs GPT。
而是:
Claude Opus 5.5 vs GPT-6 Astra、Sol 和 Luna——哪个模型更适合你的实际工作负载?
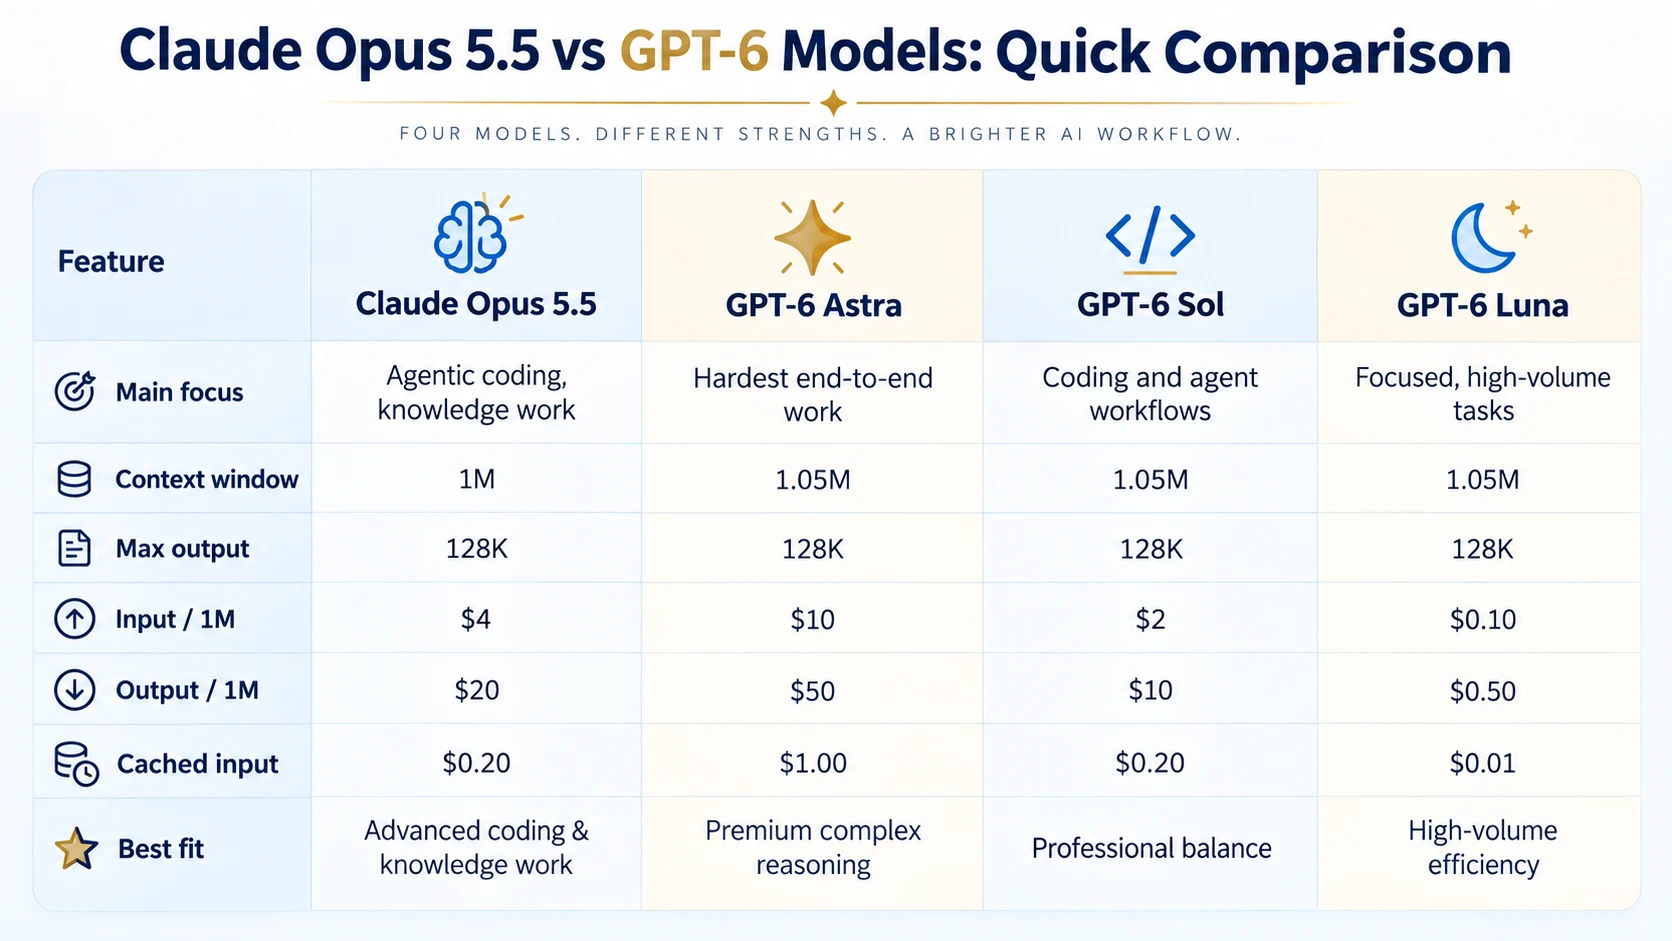
Claude Opus 5.5 vs GPT-6 快速概览
| 功能 | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| 主要侧重点 | 智能体式编程、知识工作 | 最难的端到端工作 | 编程与智能体工作流 | 聚焦、高吞吐任务 |
| 上下文窗口 | 1M | 1.05M | 1.05M | 1.05M |
| 最大输出 | 128K | 128K | 128K | 128K |
| 输入 / 1M | $4 | $10 | $2 | $0.10 |
| 输出 / 1M | $20 | $50 | $10 | $0.50 |
| 缓存输入 | $0.20 | $1.00 | $0.20 | $0.01 |
| 知识截止 | 2026 年 6 月 | 2026 年 4 月 30 日 | 2026 年 4 月 20 日 | 2026 年 5 月 18 日 |
Claude Opus 5.5 支持 1M-token 的上下文窗口与 128K 的标准输出;而三款 GPT-6 模型都提供略更大的 1.05M 上下文窗口,并且最大输出同样为 128K。
Claude Opus 5.5 vs GPT-6 Astra
当任务涉及困难推理、编程、研究或长期运行的智能体时,GPT-6 Astra 是与 Claude Opus 5.5 最直接的替代对比。
OpenAI 将 Astra 描述为其在最难端到端工作上的最强模型,包括复杂推理、编码、计算机使用、研究以及文档创建。Anthropic 则将 Opus 5.5 描述为面向长期运行的智能体式编程与知识工作的模型。
最大的实际差异是价格。
Claude Opus 5.5 的费用为:
- $4 / 1M 输入 tokens
- $20 / 1M 输出 tokens
GPT-6 Astra 的费用为:
- $10 / 1M 输入 tokens
- $50 / 1M 输出 tokens
因此在按标准标价计算时,Opus 5.5 的输入与输出每个 token 的成本都比 Astra 低 60%。
Astra 确实提供稍大的上下文窗口——1.05M 对比 1M——但与定价差距相比,这个差异相对较小。
基准测试到底显示了什么?
Anthropic 发布的 Opus 5.5 结果包含了与 GPT-6 Astra 的直接对比。
在 Anthropic 的测试中,Opus 5.5 在包含 Terminal-Bench 4.0 与 FrontierCode v1.1 等基准测试上得分更高;而 GPT-6 Astra 在 AutomationBench 与 Terminal-Bench-Science 0.1 等测试上表现更好。Anthropic 也指出,基准差异应谨慎解读,因为测试条件与统计不确定性会不同。
这也使得很难将对比简化为单一的总体分数。
对于真实工作流,更好的衡量标准往往是:模型能否可靠地完成你的编程、研究或智能体任务——以及完成该完整任务要花多少钱。
Claude Opus 5.5 vs GPT-6 Sol
对于许多专业用户来说,GPT-6 Sol 可能实际上是比 Opus 5.5 更有趣的替代选择。
两款模型都被明确定位在 编程与智能体式工作流 上。
但它们的价格不同:
| 模型 | 输入 / 1M | 输出 / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
GPT-6 Sol 的标准输入与输出 token 成本分别只有一半。
它的上下文窗口也有 1.05M,对比 Opus 5.5 的 1M。两者都支持最高 128K 的输出 tokens。
因此,Sol 值得考虑用于诸如以下频繁工作负载:
- 日常编程
- 代码审查
- AI 智能体
- 基于工具的工作流
- 研究
- 文档分析
- 业务自动化
当你希望获得 Anthropic 具备 Opus 级别的推理能力,并专注于长期运行的智能体式任务时,Opus 5.5 会更有吸引力;而 Sol 则被定位为面向反复发生的编程与智能体工作负载、更加注重成本的选择。
Claude Opus 5.5 vs GPT-6 Luna
Claude Opus 5.5 与 GPT-6 Luna 面向的工作负载差异非常大。
Luna 是 OpenAI 最高效的 GPT-6 模型,适用于聚焦的高吞吐任务。其 API 定价仅为:
- $0.10 / 1M 输入 tokens
- $0.50 / 1M 输出 tokens
这远低于 Opus 5.5 的 $4 / $20 定价。
Luna 更适合用于诸如:
- 分类
- 信息提取
- 格式化
- 短摘要
- 内容处理
- 重复性的自动化
而 Opus 5.5 面向工作负载谱系的另一端:复杂编程、更深层的知识工作,以及可能需要在许多步骤上持续推理的任务。
因此,这与其说是两个模型之间的直接对决,不如说是在判断:你的任务是否根本需要一种先进的推理模型。
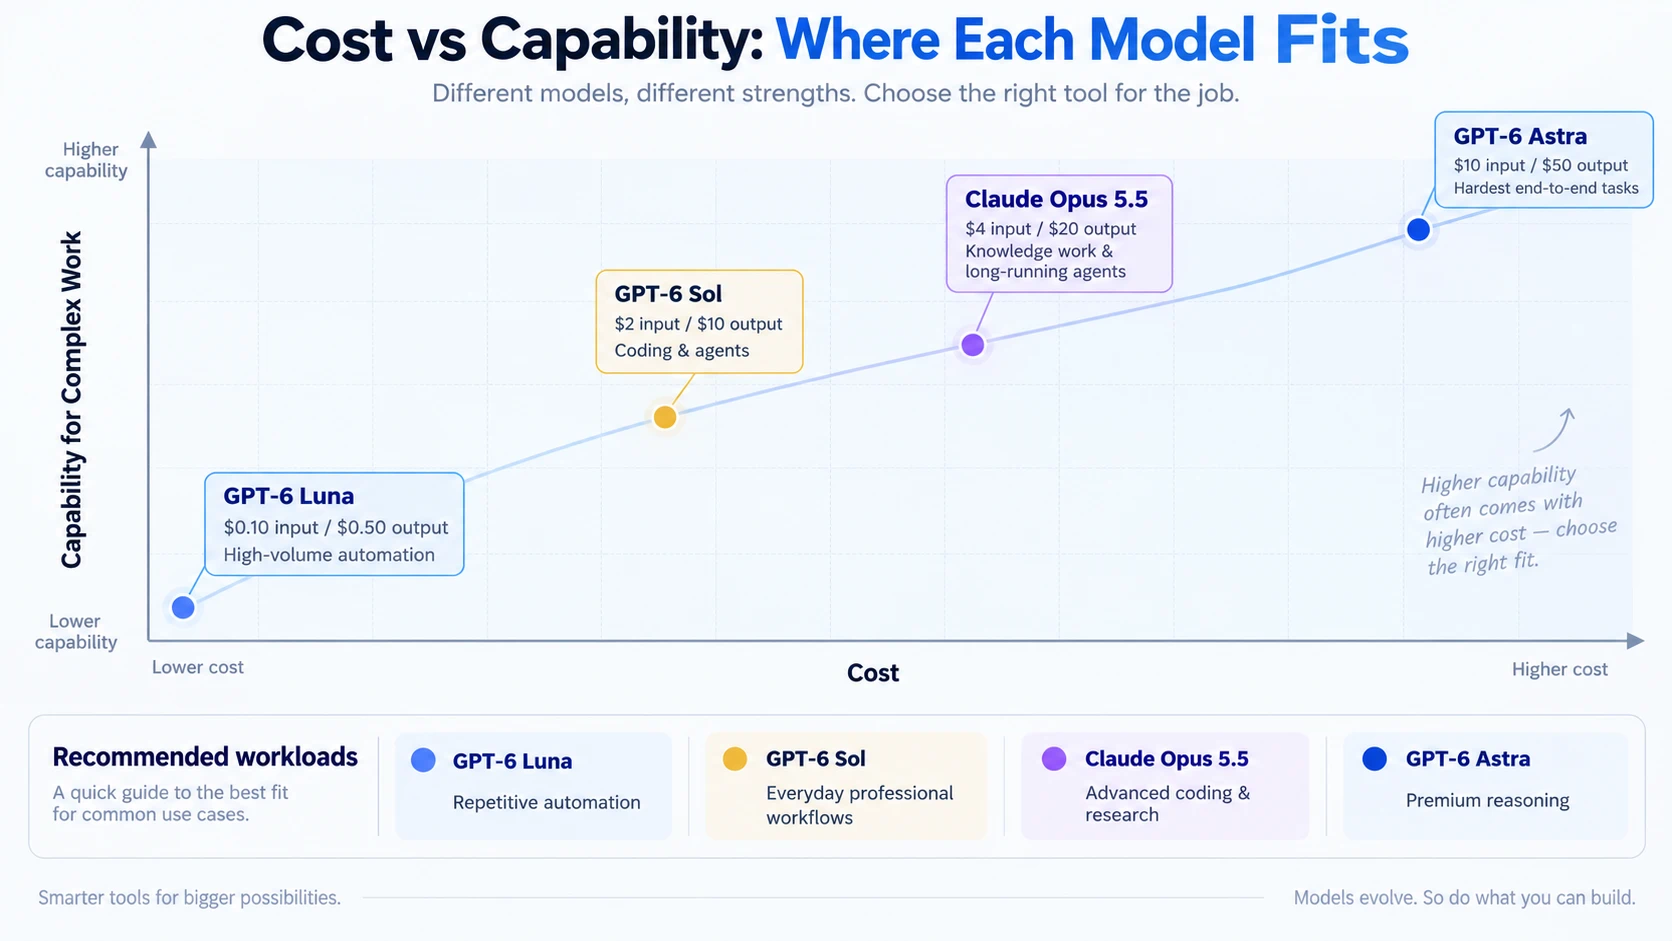
定价:每个模型分别适配什么场景
价格阶梯让定位一目了然。
| 模型 | 输入 | 输出 | 相对定位 |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | 高吞吐效率 |
| GPT-6 Sol | $2 | $10 | 专业均衡 |
| Claude Opus 5.5 | $4 | $20 | 高级编程与知识工作 |
| GPT-6 Astra | $10 | $50 | 高端端到端推理 |
以上均为标准标价 token 价格。OpenAI 会对超过 272K 输入 tokens 的 GPT-6 请求应用更高定价,因此超长上下文的工作负载可能会改变成本计算方式。
Anthropic 还支持在 Opus 5.5 上进行提示缓存:每百万缓存读取 tokens 为 $0.20;对于会反复复用大上下文的智能体,这一点可能很关键。
哪个模型适合哪类任务?
从“工作负载”而不是“品牌”出发,是对四款模型进行对比的实用方式。
| 任务 | 值得测试的模型 |
|---|---|
| 困难的端到端推理 | Claude Opus 5.5 / GPT-6 Astra |
| 大型编程项目 | Claude Opus 5.5 / GPT-6 Astra / Sol |
| 长期运行的智能体 | Claude Opus 5.5 / GPT-6 Sol / Astra |
| 日常专业级编程 | GPT-6 Sol / Claude Opus 5.5 |
| 研究与知识工作 | Claude Opus 5.5 / GPT-6 Astra / Sol |
| 高吞吐提取 | GPT-6 Luna |
| 分类与格式化 | GPT-6 Luna |
| 重复性自动化 | GPT-6 Luna / Sol |
工作流中的每一步都必须使用同一种模型,并没有任何理由。
生产级智能体可以用 Luna 做轻量的提取,用 Sol 做常规推理步骤,并将特别困难的任务路由给 Astra 或 Opus 5.5。
对成本来说,这种做法往往比“一切都选同一个模型”更重要。
在 iWeaver 上试用 Claude Opus 5.5 与 GPT-6 系列
g 规格与基准测试很有用,但它们并不总能预测:哪个模型更适合你的文档、提示词或工作流。
iWeaver 让你可以在不构建独立 API 集成的情况下,试用 Claude Opus 5.5 以及 GPT-6 系列,包括 GPT-6 Astra、Sol 和 Luna。
iWeaver 还提供免费每日额度,因此你可以在不同模型之间测试同一个真实任务——例如:
- 总结 PDF
- 对比多个文档
- 研究与分析
- 写作
- 知识提取
- 编程问答
将同一任务在多个模型上运行,更容易对比回复的深度、速度与实用性,而不只是依赖基准测试数字。
如果你想从 OpenAI 的旗舰模型开始,看看我们的指南:如何免费使用 GPT-6 Astra。
Claude Opus 5.5 在当前的前沿模型市场中处于一个很有意思的位置。
它的成本显著低于 GPT-6 Astra,同时瞄准同样高要求的编程、智能体与知识工作场景。GPT-6 Sol 在价格上压低了 Opus 5.5 的空间,并且重点非常聚焦于编程与智能体;而 GPT-6 Luna 则满足的是完全不同的需求:以低成本在规模化场景下进行处理。
因此,真正有价值的问题并不仅仅是 “Claude Opus 5.5 还是 GPT-6?”
而是你的任务到底需要旗舰级推理、均衡的专业表现,还是高吞吐效率。
出于这个原因,在 Opus 5.5、Astra、Sol 和 Luna 之间测试同一工作流,往往比仅从基准测试表中做选择更具信息量。