
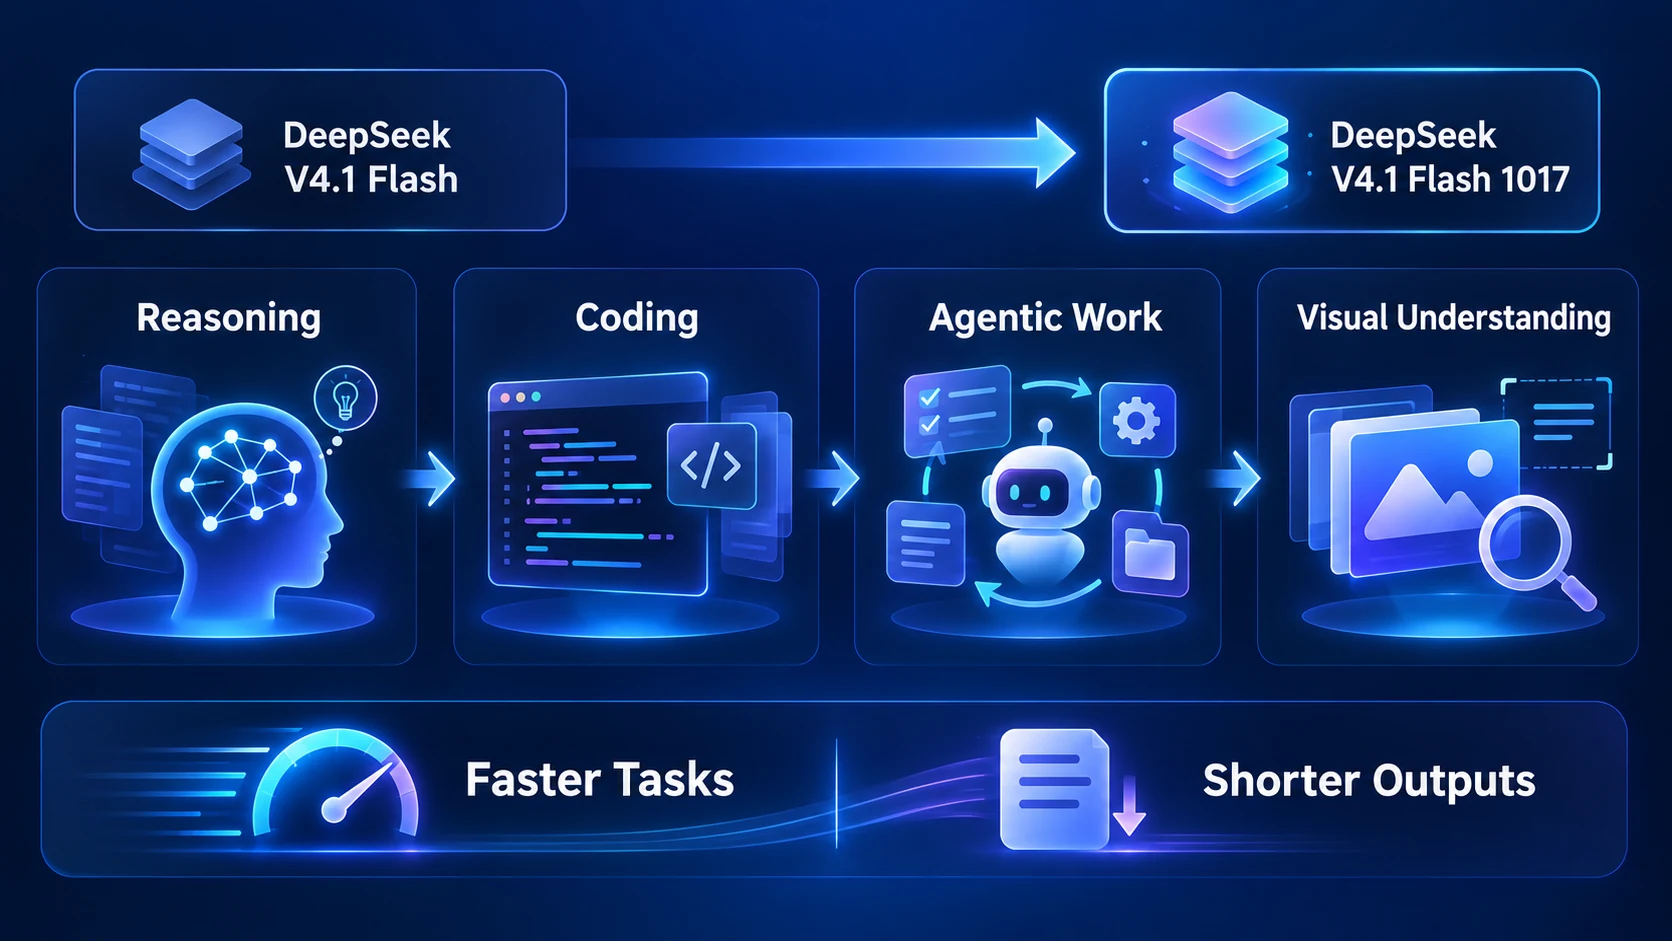
DeepSeek V4.1 Flash 1017 是对 DeepSeek V4.1 Flash 的全新更新。此次更新更着眼于实际工作,而不是新的模型家族:推理更强、编码更强、具备更强的代理(agentic)任务能力,并在视觉基准测试上表现更好。根据 DeepSeek 的发布说明和模型卡,该更新还带来更短的输出与更快的任务完成速度。
这种组合之所以重要,是因为一个有用的模型并不只取决于基准测试的峰值表现。对于研究、文档工作以及项目构建而言,更关键的问题是:它能否在不让工作流变得不必要地缓慢或昂贵的前提下,把大量上下文转化为可用的下一步。本文将解释 1017 更新带来了哪些变化、其证据最强的环节,以及如何在 iWeaver 工作流中使用它。
DeepSeek V4.1 Flash 1017 是什么?
DeepSeek V4.1 Flash 1017 是对 DeepSeek V4.1 Flash 的小幅更新。官方模型卡描述了在推理、编码、代理任务以及视觉基准测试等方面的改进。与此同时,它也报告称,相比上一版本 V4.1 Flash,任务执行时间更短,输出长度更短。
该更新已在 DeepSeek 的网站、应用和 API 上提供。DeepSeek 的 API 文档指出,Web 端与应用端模型也已更新,而 API 调用方式与定价保持不变。开发者继续使用 deepseek-flash 来获取最新模型。这些细节可能随时间变化,因此计划进行 API 集成的读者在实施前应先查看最新文档。
模型卡列出了 MIT 许可并提供部署信息,但本地推理是一个独立的工程决策:发布的模型文件体积很大,硬件、量化(quantization)、服务软件(serving software)以及性能表现将决定自托管是否真正可行。
1017 更新发生了什么变化?
编码与代理任务表现更好
模型卡显示,相较于更早的 V4.1 Flash 发布版本,该模型在多个编码与代理基准上获得了更高分数。例如,文中列出的 Terminal-Bench 4.0 分数从 31.2 提升至 42.3,DeepSWE v1.1 从 74.2 提升至 77.0,Automation-Bench 从 54.8 提升至 60.5。这些是模型发布方报告的基准结果,并不保证对每个代码仓库、工具环境或提示(prompt)都同样适用。
DeepSeek 的发布说明还为这次更新提供了更具体的阐释:采用带自我反馈的强化学习(reinforcement learning with self-feedback),旨在提升端到端项目开发能力,包括构建网页游戏、创建 3D 场景,或基于自然语言请求开发项目等任务。这意味着它更适合多步骤工作:当模型需要规划、编写、检视与修改,而不是回答某个孤立问题时,它的契合度更高。
输出更短,完成更快
1017 更新同样被定位为更高效的版本。DeepSeek 表示,该模型能更快完成任务,并产出更短的输出。实际使用中,当工作流包含许多模型调用时,这一点可能有所帮助,但具体收益取决于任务本身。更短的回复有助于减少重复;但如果任务需要深入的推理、证据支持或需要较长的结构化交付物,那么它并不一定更好。
搜索与抓取现在成为当前 API 的一部分
DeepSeek 在 10 月 17 日的 API 更新中,也宣布其 Search 与 Fetch API 的通用可用性。发布说明指出,这些端点旨在检索当前的网页信息,使用费用与之分别计费。这与研究型工作流相关,但它并不意味着不需要检查来源:即使检索到的页面也仍可能过时、不完整,或与当前提问的内容不一致。
如何在 iWeaver 中使用 DeepSeek V4.1 Flash 1017
1. 从限定的来源集开始
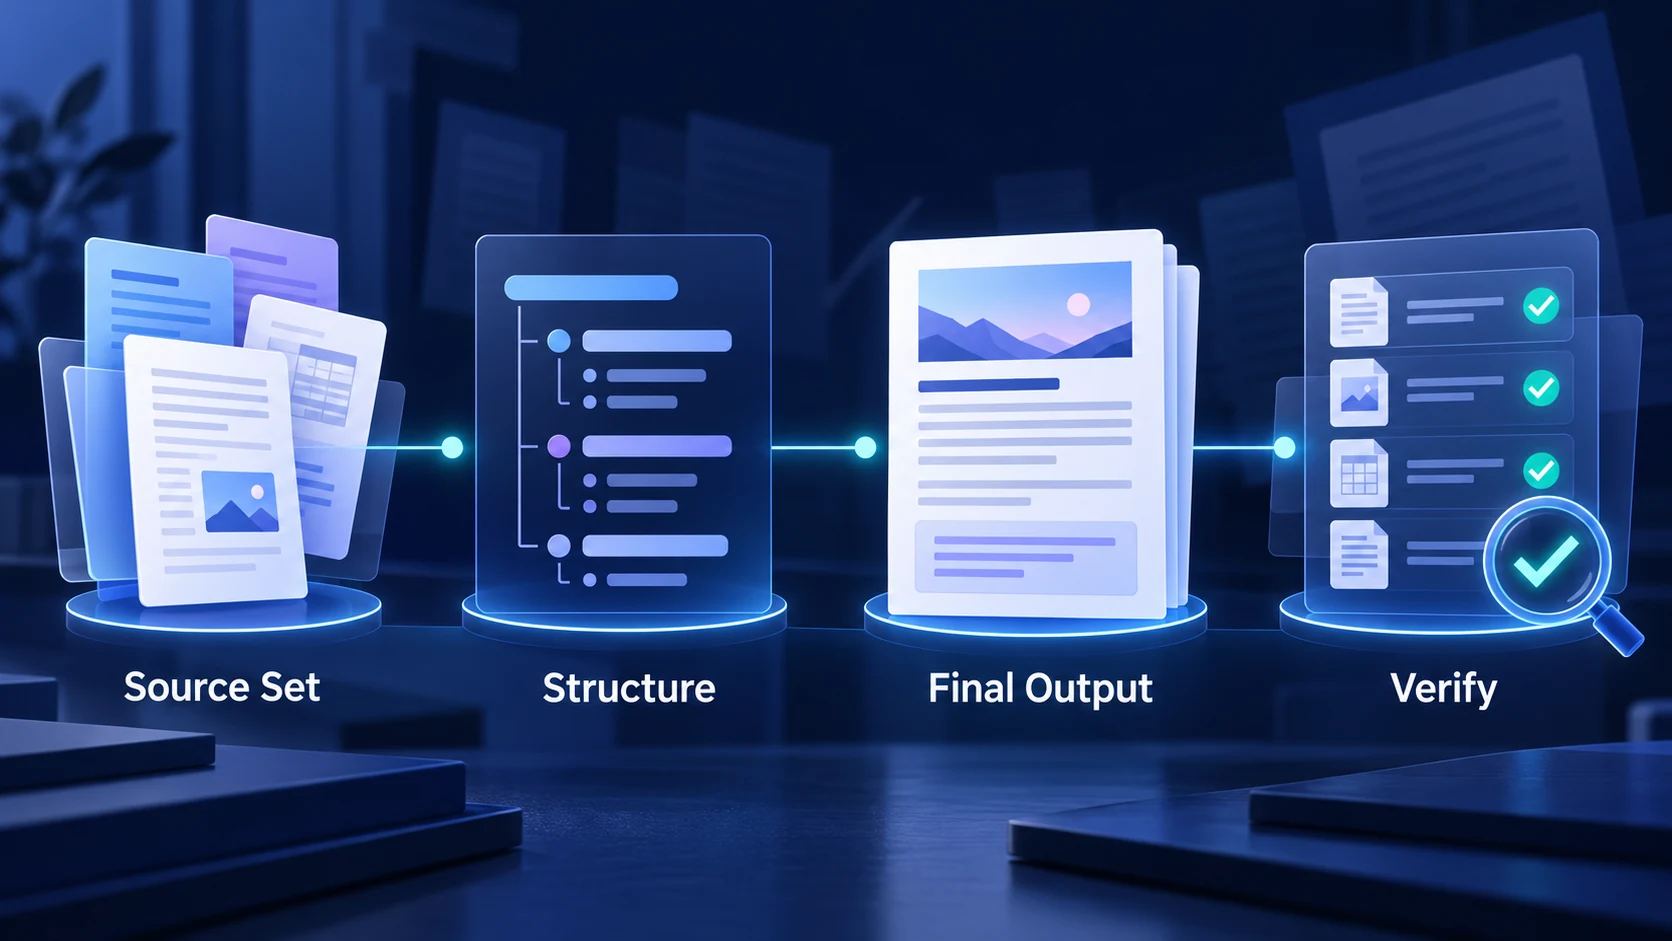
添加与单项任务相关的文档、网页、笔记或其他来源材料。为任务设定清晰边界:例如,“对这三份报告进行对比,并指出它们的建议在哪些地方存在分歧。”限定来源集能更容易地核查最终答案是否确实来自你提供的材料。
2. 要求先生成中间结构
与其一开始就要求生成一篇打磨过的文章,不如先请求一个可执行的工作结构。常见且有用的中间输出包括:
- 论点与来源的对应图(claim-and-source map);
- 变更时间线;
- 假设与证据的对比;
- 未解决问题清单;
- 包含风险与下一步行动的决策简报(decision brief)。
这一步能利用更新后更强的代理与推理定位,同时保持工作过程可供检查。如果结构不对,你可以在“打磨好的答案”把问题掩盖之前先纠正任务。
3. 将结构转换为最终格式
当证据与大纲看起来正确后,再要求输出最终交付物:研究备忘录、学习指南、会议简报、产品对比,或是实现清单(implementation checklist)。务必明确输出要求。写清楚目标受众、长度范围、语气、引用风格,以及必须包含的章节。
对于偏文档密集的工作,你可以继续使用 AI Document Summarizer ,或使用 Knowledge Organizer 把分散来源整理成更可复用的信息结构。这些链接是工作流建议;在 iWeaver 中展示的具体工具与模型可用性可能会随时间变化。
4. 进行一次校验流程
让模型把“有来源支撑的事实(sourced facts)”、解释(interpretations)、假设(assumptions)以及缺失证据(missing evidence)分开。然后把高影响力的结论与原始材料逐一核对。对于当前定价、API 行为、发布日期、法律或政策问题,以及数值对比,这一点尤其重要。
模型最适合在哪些场景中发挥作用?
DeepSeek V4.1 Flash 1017 最适合那些把多个操作结合在一起的任务,例如:
- 分析一组文档并输出一份可用于决策的简报;
- 把产品想法转化为一个小型可运行原型;
- 审阅代码并提出有针对性的修改建议;
- 在明确取舍(trade-offs)的前提下对比技术方案;
- 在撰写更长报告之前整理研究内容;
- 与视觉输入协同工作,让图片提供重要上下文。
仅仅因为基准分数更高就选择某个模型,价值相对较低。一种简单检索、一种高度受限的转换,或是对专有要求非常严格的任务,可能更适合用其他模型或更简单的流程来完成。真正正确的检验标准,是这个模型能否提升完整工作流:输入准备、推理、修订、校验以及最终使用。
DeepSeek V4.1 Flash 1017 vs 早期的 V4.1 Flash
| 领域 | V4.1 Flash | V4.1 Flash 1017 |
|---|---|---|
| 定位 | 首次 V4.1 Flash 发布 | 对 V4.1 Flash 的小幅更新 |
| 推理与编码 | 强基线 | 更高的发布方报告基准分 |
| 代理(Agentic)工作 | 适用于多步骤任务 | 在发布材料中更聚焦端到端项目 |
| 输出表现 | 更早代的生成行为 | 据称输出更短、任务完成更快 |
| 获取方式 | 网站、应用与 API | 网站、应用、API,以及更新后的开源权重模型卡 |
| API 模型名称 | deepseek-flash |
deepseek-flash |
该表总结了发布方文档内容。这并不是独立基准测试,也不应被解读为对所有竞争模型的通用排名。
DeepSeek V4.1 Flash 1017 对关心编码、代理型项目工作、推理、视觉输入以及反复模型调用成本的用户来说,是一次有意义的更新。其最清晰、最实用的优势在于:在“报告的任务表现更强”与“输出更短、完成更快”之间实现了更好的组合。
在 iWeaver 中,最好的使用方式是把它作为可视化研究或文档工作流的一部分来使用:定义来源集、构建中间结构、生成最终输出,并校验关键结论。这样一来,新模型就有空间参与复杂工作,同时让结果保持可理解、可核查。