
Grok 4.7 正式来了。它于 2026 年 9 月 21 日 发布,是 xAI 面向编程、Agent 任务和专业知识工作的最新前沿模型。
这并不是 Grok 4.6 的一次小幅更新。xAI 表示,Grok 4.7 采用了一个全新且规模更大的基础模型,进行了更长时间的强化学习训练,并提高了高难度任务在训练中的比重,其中包括可能需要数小时才能完成的复杂任务。它还加强了自我验证和长上下文管理能力——相比只回答简短问题,这两项能力在真实工作流中更有价值。与此前围绕 Grok 4.7 的早期猜测不同,现在我们已经有了官方规格和基准测试结果可供比较。
Grok 4.7 发布时间
Grok 4.7 已正式发布。通过 xAI API 可使用的模型名称为:grok-4.7
发布时,xAI 也同步在多个编程和 AI 平台提供该模型,包括 Grok Build 和 Cursor。GitHub 也已开始向 GitHub Copilot 用户逐步推送 Grok 4.7。
如果你想了解上一代模型,也可以查看我们的 Grok 4.6 评测。
Grok 4.7 规格一览
下面是主要官方规格。
| 规格 | Grok 4.7 |
|---|---|
| 发布时间 | 2026 年 9 月 21 日 |
| 模型名称 | grok-4.7 |
| 上下文窗口 | 500,000 tokens |
| 知识截止时间 | 2026 年 5 月 |
| 输入模态 | 文本、图片 |
| 输出模态 | 文本 |
| 文本输出上限 | 无固定文本输出上限 |
| 推理级别 | Low、Medium、High、XHigh |
| 默认推理级别 | High |
| Function Calling | 支持 |
| Web Search | 支持 |
| X Search | 支持 |
| Code Execution | 支持 |
| API 支持 | Responses API、Chat Completions |
500K 上下文窗口尤其适合处理长文档、大型代码库、多文件项目、研究任务,以及需要长时间保留大量信息的 Agent 工作流。
Grok 4.7 还支持四种推理级别:
- Low
- Medium
- High
- XHigh
开发者可以根据任务,在响应速度和推理深度之间做取舍。
Grok 4.7 有哪些新变化?
最重要的变化,并不是一些吸引眼球的新界面功能。
真正的升级,集中在模型处理更长、更复杂任务的能力上。
1. 全新、更大的基础模型
与 Grok 4.6 相比,Grok 4.7 基于一个全新且规模更大的基础模型构建。
这很重要,因为它并不是在 Grok 4.6 的基础上简单增加后训练。
底层模型本身已经发生了变化。
之后,xAI 又进行了更长时间的强化学习训练,并使用了更高难度的任务组合,尤其加强了对可能需要数小时才能完成的问题的训练。
目标很明确:
让 Grok 不只是擅长开始复杂任务,也更擅长把任务真正完成。
2. 更强的长任务表现
很多 AI 模型在处理短提示词时表现亮眼,但随着任务不断变长,可靠性可能会下降。
常见问题包括:
- 忘记前面的指令
- 前后决策不一致
- 重复执行相同工作
- 遗漏依赖关系
- 出错后没有检查
- 没有充分利用前文信息
Grok 4.7 专门针对长时间运行的任务进行了优化。
这对于编程 Agent、研究工作流、文档创建,以及包含多个阶段的专业任务尤其重要。
3. 更好的自我验证能力
另一个重要变化是更强的自我检查能力。
Grok 4.7 不只是生成答案后直接结束,而是被设计成更仔细地检查自己的工作结果。
这对以下任务很有帮助:
- 调试代码
- 编辑大型项目
- 检查计算结果
- 审阅文档
- 遵循较长的复杂指令
- 连续调用多个工具
当然,自我验证并不意味着模型不会出错。
在高风险任务中,人工审核仍然很重要。
但更好的内部检查机制,可以减少长工作流中的一些明显失误。
4. 更强的 Agent 与知识工作能力
Grok 4.7 还针对 xAI 的 Grok Bot harness 进行了训练,使其能够更好地理解和使用这一运行框架。
因此,当任务不只是回答一个问题,而是需要 AI 连续完成多个步骤时,Grok 4.7 会更值得关注。
例如:
- 检查文件
- 搜索信息
- 编写代码
- 调用工具
- 检查结果
- 修改自己的工作
- 持续执行,直到完成更大的任务
这也反映了前沿 AI 的一个明显变化。
核心问题已经不再只是:
模型能回答这个问题吗?
而越来越变成:
模型能把整个任务做完吗?
Grok 4.7 基准测试
xAI 公布了 Grok 4.7 与 Grok 4.6 以及其他前沿模型的基准测试结果。
从结果来看,Grok 4.7 在编程、终端任务、工程以及专业知识工作方面的提升尤其明显。
为了让对比更直观,下面主要看 Grok 4.7 vs Grok 4.6。
| Benchmark | Grok 4.7 | Grok 4.6 | 变化 |
|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | +5.9 pts |
| DeepSWE v1.1 | 71.0% | 65.2% | +5.8 pts |
| AA Briefcase v1.1 | 1,657 | 1,546 | +111 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | +17.7 pts |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | +3.8 pts |
| HealthBench Professional | 56.7% | 48.5% | +8.2 pts |
| EEBench | 64.0% | 53.0% | +11.0 pts |
这组数据中,提升幅度最大的是 Terminal-Bench 4.0。Grok 4.7 得分为 38.0%,Grok 4.6 为 20.3%。
对于需要使用终端命令、工具、代码仓库和多步骤执行的 Agent 编程工作流来说,这项提升尤其值得关注。
在电气工程、专业知识工作、软件工程和临床推理等基准测试中,Grok 4.7 同样有比较明显的进步。
Grok 4.7 vs Grok 4.6
从基准测试数据中,可以更直观地看出两代模型之间的变化。
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| 状态 | 上一代 | 最新一代 |
| 基础模型 | 早期模型 | 全新、更大的基础模型 |
| 上下文窗口 | — | 500K tokens |
| 长时间任务 | 强 | 进一步提升 |
| 自我验证 | 强 | 进一步提升 |
| CursorBench 4.0 | 40.4% | 46.3% |
| DeepSWE v1.1 | 65.2% | 71.0% |
| Terminal-Bench 4.0 | 20.3% | 38.0% |
| EEBench | 53.0% | 64.0% |
| API 输入价格 | $2 / 1M tokens | $2 / 1M tokens 起 |
| API 输出价格 | $6 / 1M tokens | $6 / 1M tokens 起 |
因此,从 Grok 4.6 升级到 Grok 4.7 的主要原因,并不是某一个单独的卖点。
而是以下几项能力叠加在一起:
更强的编程能力 + 更好的长任务表现 + 更好的上下文管理 + 更强的自我检查。
如果你的使用场景主要是日常短问题,体感差异可能不会特别大。
但对于需要执行长时间、多步骤工作流的开发者和专业用户来说,这次升级更有意义。
Grok 4.7 价格
Grok 4.7 的起步价格为:
- 每 100 万输入 tokens $2
- 每 100 万缓存输入 tokens $0.50
- 每 100 万输出 tokens $6
以上价格适用于提示词低于 200K tokens 的情况。
当提示词超过 200K tokens 时,官方 API 价格提高至:
- 每 100 万输入 tokens $4
- 每 100 万缓存输入 tokens $1
- 每 100 万输出 tokens $12
由于 Grok 4.7 提供 500K 上下文窗口,这种分段计价方式值得注意。
如果实际使用接近完整上下文窗口,成本会高于较短请求。
什么是 Grok 4.7 Fast?
xAI 还提供 Grok 4.7 Fast。
它使用相同的底层模型,但运行在更快的基础设施上。
根据 xAI 的说法,其输出速度约为标准版本的两倍,同时 token 价格也是标准版本的两倍。
不过,它在可用范围上有一个重要区别:
Grok 4.7 Fast 目前可通过 Cursor 和 Grok Build 使用,但尚未开放至公共 xAI API。
因此,对于直接使用 xAI API 构建应用的开发者来说,标准版 Grok 4.7 仍是主要选择。
Grok 4.7 可以在哪里使用?
Grok 4.7 已经在多个平台上线。
xAI API
开发者可以通过 xAI Responses API 或 Chat Completions API 使用:
grok-4.7
支持的工具包括:
- function calling
- web search
- X search
- code execution
Grok Build
Grok 4.7 是 Grok Build 的默认模型。Grok Build 是 xAI 面向编程和应用开发的 Agent。
Cursor
Cursor 已支持 Grok 4.7。
Fast 版本也可以在 Cursor 中使用。
Model Gateways
xAI 文档列出的可用平台包括:
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
GitHub 于 9 月 21 日开始向 GitHub Copilot 推送 Grok 4.7。
该模型正在逐步覆盖 Copilot Pro、Pro+、Max、Business 和 Enterprise 方案。
支持的环境包括:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot cloud agent
- GitHub Copilot app
- JetBrains
- Xcode
- Eclipse
由于采用分批推送方式,部分用户可能暂时还看不到该模型。
不要只看一个 Benchmark 就判断 Grok 4.7
官方基准测试很有参考价值,但一张 Benchmark 表格不应该成为选择模型的最终依据。
不同基准测试衡量的能力并不相同。
一个在编程测试中表现优秀的模型,不一定同样适合:
- 研究
- 文档分析
- 写作
- 客户支持
- 数据提取
- 内容总结
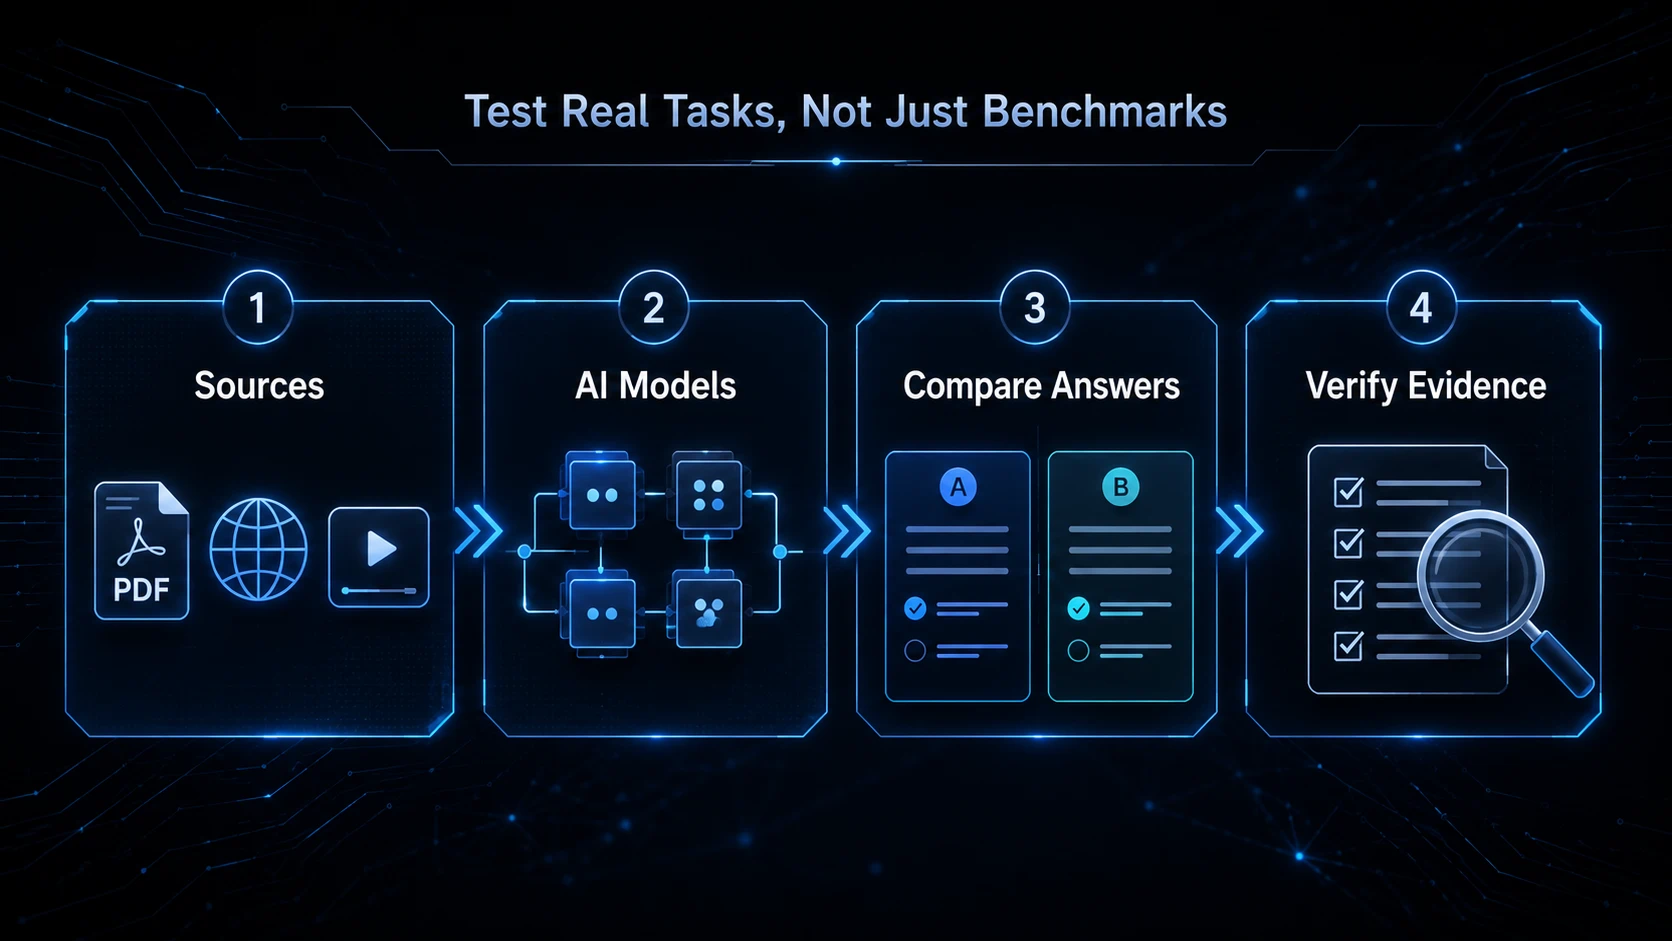
更合理的方法,是让不同模型完成同一个真实任务。
例如:
- 给每个模型同一个问题。
- 提供相同的源文件。
- 使用相同的指令。
- 对比最终答案。
- 检查遗漏信息和事实错误。
- 对照原始资料验证重要结论。
如果你的工作涉及 PDF、网站、视频、演示文稿或研究资料,像 iWeaver 这样的工具可以先把这些材料整理到一个地方,再用于比较不同模型的输出。
这样更容易判断一个 AI 模型是否真的适合你的工作流,而不是只看它在排行榜上的表现。
Grok 4.7 值得用吗?
对于编程和 Agent 工作流来说,Grok 4.7 相比 Grok 4.6 是一次比较明显的升级。官方基准测试数据显示,它在软件工程、终端任务、专业工作、电气工程、法律任务和临床推理方面都有提升。500K 上下文窗口、更好的长任务表现、更强的自我验证能力、工具支持,以及保持不变的 API 起步价格,也让 Grok 4.7 更适合更复杂、更大型的工作流。
这并不意味着 Grok 4.7 会是所有任务中的最佳模型。不同模型依然各有优势,Benchmark 成绩也不一定会直接转化为更好的真实输出。
但与 Grok 4.6 相比,Grok 4.7 为开发者和专业用户提供了一个能力更强的选择,尤其适合步骤多、上下文规模大,或者需要长时间调用工具的任务。
Grok 4.7 并不是一次普通的小版本更新。它采用了一个全新、更大的基础模型,并明显加强了长时间编程、Agent 工作、自我验证和专业知识任务。与 Grok 4.6 相比,官方数据表明它在多项高难度 Benchmark 上都有明显提升,而 API 起步价格保持不变。
现在更值得关注的问题,已经不是 Grok 4.7 在纸面数据上是否优于 Grok 4.6。而是这些提升有多少能够真正体现在真实项目中。对于开发者、研究人员,以及正在构建长流程 AI 工作流的用户来说,这才是 Grok 4.7 最终需要接受的检验。