
智能文档处理(IDP)使用 AI 及相关技术,将文档内容转化为工作流可使用的信息。典型系统会对传入文档进行分类、提取相关数据、验证结果,并将经过审核的信息交给下一步骤。真正的检验标准在于结果是否足够可靠、能够支持后续的操作——而不在于系统是否能读懂某一页。
AWS 对 IDP 的说明介绍了这些阶段,其中包括对业务规则或现有数据的核查。这个验证环节至关重要:看起来合理的发票金额仍可能是错误的;而正确提取出来的数值,也可能本应属于你系统早已收到过的另一张发票。
从提取后的下一步开始
在评估某个工具之前,先把这句话补完:“一旦文档完成处理,我们需要……”答案可能是创建一条记录、指派审核人、将信息与采购订单进行比对,或准备一份简报。每种结果都需要不同的校验,以及不同程度的自动化。
如果任务最终以“由人员阅读摘要”告终,那么理解文档内容可能就足够了。如果输出会在另一个系统中更改记录,你还需要明确的模式(schema)、校验规则,以及对异常情况的处理路由。试点(pilot)之前就应当确立这些要求,因为仅展示一次提取(extraction demo)无法证明整个工作流已经就绪。
IDP 工作流的各个阶段
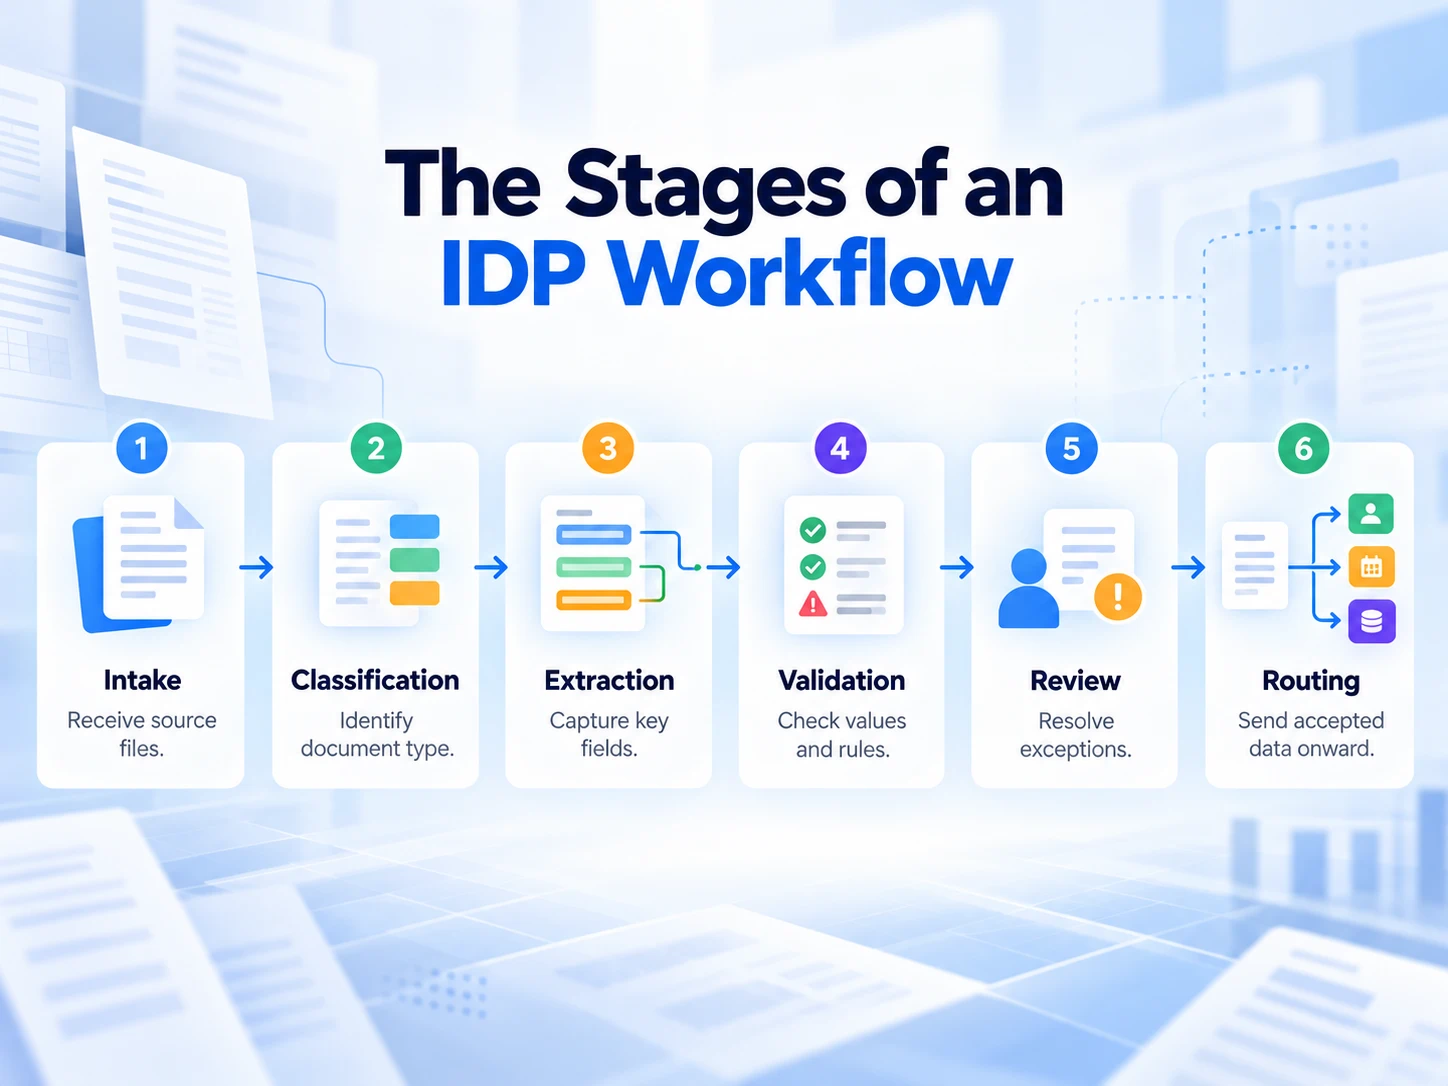
| 阶段 | 目的 | 示例:未被发现的失败 |
|---|---|---|
| 接入(Intake) | 接收并识别源文件 | 同一个文件重复到达两次 |
| 分类(Classification) | 确定文档类型或相关类别 | 信用单(credit note)被当作发票处理 |
| 提取(Extraction) | 捕获完成任务所需的字段 | 小计被提取为合计 |
| 验证(Validation) | 检查数值、关系以及所需信息 | 合计未能通过约定的计算规则 |
| 审核(Review) | 解决含糊或被拒绝的结果 | 不清晰的日期收到了一次缺乏依据的猜测 |
| 路由(Routing) | 将已接受的信息传递到下一步 | 一条有效记录被发送到错误目的地 |
这是一个规划模型,而不是保证每个 IDP 产品都会提供全部六个阶段。检查某项服务提供了哪些组件,以及哪些需要你自行构建或配置。
分类决定下一次解释
文档看起来可能很相似,但服务于不同目的。发票、采购订单和信用单可能包含姓名、日期和金额,但它们不应触发相同的操作。分类用于确定适用哪些提取规则以及审核要求。
微软的 Document Intelligence 概览 会将自定义分类器与提取模型并列说明。它的这种区分正好体现:识别文档类型与提取文档内容是两项独立工作。工作流也应当定义:当类型不确定,或落在预期范围之外时会发生什么。
提取需要对每个字段作出清晰定义
当文件中同时包含问题日期(issue date)、服务日期(service date)和付款截止日期(payment deadline)时,“提取日期”就很模糊。你需要明确要提取哪个字段,以及它应当以怎样的形式出现在输出中。还要包含缺失值的规则,并保留用于核查提取结果所需的信息。
例如,发票模式(invoice schema)可能会要求供应商名称、发票号码、发票日期、币种、小计/合计、税费等。字段定义应明确:当文档呈现多个候选值时,应选择哪一个。新增字段很容易;要判断什么才算正确结果,则需要更多谨慎。
验证不仅是检查可读性
有些校验用于确认某个值具有预期格式。另一些则检查文档内部的关系,或将提取数据与可信记录进行对比。日期可能被正确格式化,却对应了错误的事件;合计可能看起来无误,却与明细行项目不一致。
定义业务规则,以及当校验失败时应采取的动作。例如,缺失发票号码可能需要人工审核;而“供应商与发票号码组合”重复出现可能会触发重复检查。通过格式校验不应自动授权后续操作。
一个实际发票示例
想象一张供应商发票,包含这些信息:签发日期是 3 月 5 日,到期日期是 4 月 4 日,小计是 1,000,总计/合计是 1,080。币种没有被清晰印出,无法准确判断。这是用于说明的示例,不是来自产品测试的实测结果。
提取系统可能会返回一条外观看起来很整洁的记录:将 4 月 4 日当作发票日期、将 1,000 当作合计,并猜测了币种。每个数值单独看都说得通。合在一起却说明了:为什么 IDP 工作流需要明确的字段含义与审核规则。
| 请求字段 | 审核后的值 | 接受性检查 |
|---|---|---|
| 发票日期 | 3 月 5 日 | 使用签发日期,而不是到期日期 |
| 到期日期 | 4 月 4 日 | 与发票日期保持区分 |
| 合计 | 1,080 | 确认最终合计并检查其组成部分 |
| 币种 | 未解决 | 保持未解决状态并请求审核 |
正确的下一步,是在使用该记录之前先解决币种问题(因为在币种相关的地方它很关键)。通过“猜测”生成的看似完整记录,通常不如一条不完整但能清楚指出审核人必须核查什么的记录更有价值。
OCR、Document AI、IDP 与 RPA
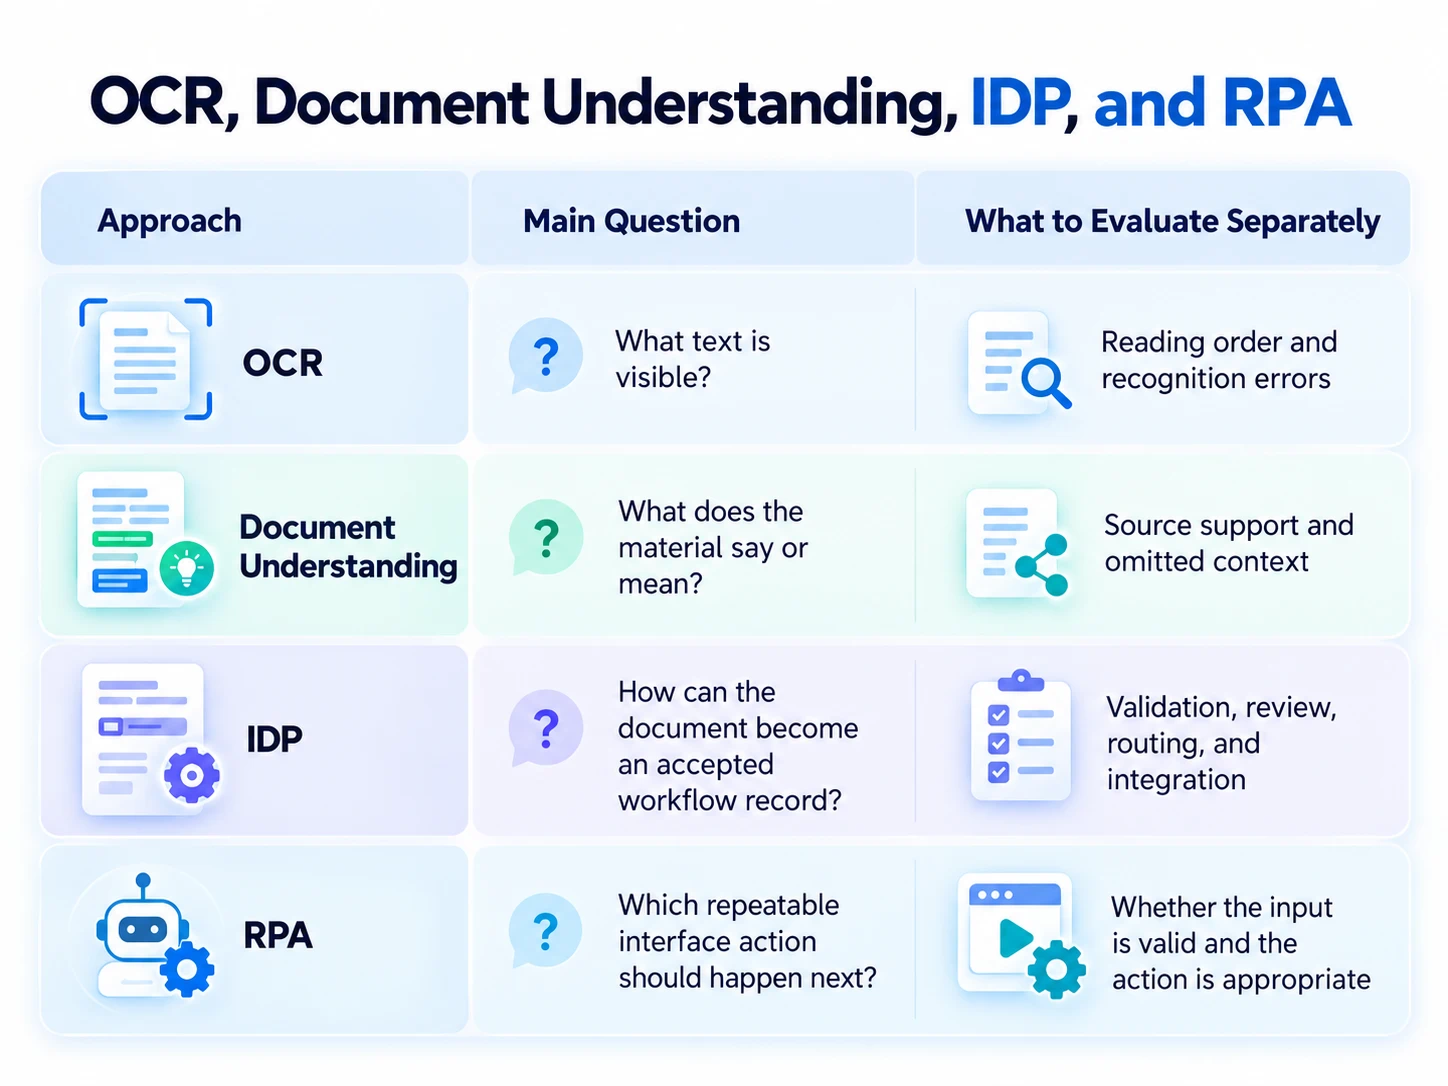
Google 的 Document AI 提供用于 OCR、提取和分类的处理器。这些组件展示了工作流如何在不同阶段使用不同能力。仅仅存在一个提取器,并不能告诉你你的验证规则或异常处理是否已经实现。
| 方案 | 回答的核心问题 | 需要单独评估的内容 |
|---|---|---|
| OCR | 能看见哪些文本? | 阅读顺序与识别错误 |
| 文档理解 | 这份材料在说什么或意味着什么? | 源文档支持以及被省略的上下文 |
| IDP | 文档如何成为一条被接受的工作流记录? | 验证、审核、路由与集成 |
| RPA | 下一步应该发生哪种可重复的接口操作? | 输入是否有效,以及该操作是否合适 |
边界是“实用性的”,而非“绝对的”:产品可能会结合多种方案。使用这种区分来提出更好的评估问题,而不是假设某个营销标签就定义了完整的系统。
生成式 AI 能提供什么——以及规则仍然重要在哪里
生成式模型可以理解指令与多样化语言,使其在灵活提取与文档理解方面更有相关性。Google 在其 Document AI 产品中描述了基于生成式 AI 的自定义提取器。这支持该产品的能力宣称,但并不意味着它对每个文件或每个工作流都能提供通用的准确性水平。
对于一项智能文档处理 AI 试点(pilot),需要明确:模型允许推断到什么程度。有些任务需要标准化后的值;另一些则要求进行原样转写。保持这些模式彼此区分,才能让审核人判断某个字段是来自明确陈述,还是来自某种解释。
提示词(prompt)可以要求“缺失时使用 null”,但工作流仍必须检查输出。不要把流畅的解释当作字段正确的证据。请查看相关的源文本段落、字段定义,以及在提取之后应用的任何规则。
如何设计一个有用的 IDP 试点
选择一个文档族与一个结果
从一个边界清晰的任务开始,例如:为审核从供应商发票中提取指定字段。明确试点将产出什么,以及谁会检查异常情况。在第一个工作流真正理解之前就扩展到多个文档族,可能会让故障更难诊断。
构建具有代表性的评估集
加入你预期会收到的常见示例与变化:缺失字段、不熟悉的版式、多页文档、扫描质量较差以及重复项。让审核人在测试前先建立预期结果。再准备一个单独的“留出(held-out)”集合,确保最终评估包含那些没有指导你配置选择的文件。
在合适的层级衡量结果
字段正确性与文档被接受(acceptance)回答的是不同问题。系统可能能正确提取大多数字段,但却经常缺失完成任务所必需的那个关键字段。记录哪些字段会失败、文档需要审核的频率,以及什么条件让一条记录可以进入下一步。
请始终使用这些一致的定义:
- **字段正确性(Field correctness):**在使用文档化的匹配规则的前提下,正确评估的字段数除以所有被评估字段数。
- **审核率(Review rate):**需要人工审核的文档数除以已处理的文档数。
- **接受率(Acceptance rate):**通过所有已定义的接受性检查的文档数除以已处理的文档数。
- **审核工作量(Review effort):**用于解决异常的时间;用一致的起点与终点进行衡量。
这些是建议的评估指标,而不是性能宣称。要把缺失字段与错误值区分开来,同时也要记录下游失败以及提取错误。这样的区分有助于你判断是要改进解析(parsing)、重写字段定义,还是调整审核路由。
在提高自动化之前先测试失败处理
检查当文件无法被读取、文档类型未知或所需字段之间发生冲突时会发生什么。工作流应当让未解决状态清晰可见,并为审核人保留足够的上下文。确认被拒绝的记录不会悄悄地流入下一个系统。
如果你评估一款“IDP AI”工具,要求展示在使用你自己的代表性文档时的异常路径。成功的演示不仅要包含普通文件如何被处理,还应包含失败如何被处理。
iWeaver 在哪里适合
有些文档任务以“理解”作为终点,而不是以可操作记录(operational record)为终点。如果你正在阅读报告或准备简报,iWeaver 提供摘要、AI 对话以及知识组织。它的 AI 文档摘要器(AI Document Summarizer) 可以作为审阅源材料并决定哪些内容需要进一步关注的起点。
例如,在规划你的分析之前,可以先索取对报告论点、证据与局限性的概览。iWeaver 的公开文档工作流支持定制摘要与后续探索。只要某个事实很关键,就回到原文进行核对;并对任何必要的企业级提取或集成功能,分别进行评估。
在选择 IDP 系统前要问的问题
智能文档处理(IDP)和 OCR 是一回事吗?
OCR 关注的是识别文本。IDP 工作流会增加分类、提取、验证、审核与路由等任务。在对比不同产品之前,先明确你的任务究竟需要上述哪些阶段。
IDP 能不经过人工审核运行吗?
这取决于文档、验收标准(acceptance criteria)以及错误所带来的后果。明确哪些结果可以自动推进,哪些必须经过审核。用试点证据来制定这些规则,而不是假设对所有输入都进行自动化是合适的。
IDP 工作流应该如何处理缺失信息?
要显式表示缺失值,并应用一个已定义的规则。必填字段可能导致拒绝或审核;选填字段则可能保持为空。对缺失值进行猜测会让结果更难审计,也可能使其在下一步中变得不安全。
我应该先测试什么?
先测试:为下一步操作所需的字段是否被正确提取并完成验证。然后再测试异常情况、重复项,以及被接受记录的目的地。若关键字段或失败路由仍然不可靠,即使整体提取分数很高也不足够。
让第一套工作流可被审核
选择一个较窄的文档任务,定义可接受的输出,并同时测试普通文件与异常情况。把提取视为一个流程中的单个阶段——其最终结果必须被检查。当你的直接目标是理解文档时,先 从基于来源的摘要开始,再用它来指导你的审核。