
Kimi K3.1 Pro 的标价基础 API 输入与输出费率低于 Claude Opus 5.5。至于它是否是更好的选择,取决于具体任务:尝试次数、修正内容和人工审核,有时可能比“每个 token 的费率”更重要。
这两款模型都被定位为用于复杂编程与知识工作。本对比参考官方文档与已发布的供应商结果,而不是独立的实操测试。目标是帮助你选择一个有用的评估方式,然后根据它产出的工作成果做出决策。
API 定价:对比同类用法
关于本次对比背后的发布场景,请参见 Kimi K3.1 Pro 的新能力。
以下美元费率于 2026 年 10 月 24 日进行了核查:
| 每百万 tokens | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| 基础输入 | $2 | $4 |
| 基础输出 | $10 | $20 |
| 缓存命中/读取 | $0.20 | $0.20 |
以上为 API 费率。消费者订阅、第三方服务以及加速模式的条款各不相同。
考虑一个假设请求:100,000 个未缓存的输入 tokens 和 10,000 个输出 tokens。按这些基础费率计算,使用 K3.1 Pro 的输入与输出成本为 $0.30,使用 Opus 5.5 的成本为 $0.60。此计算不包含缓存写入、工具调用、重试以及其他费用。它用来说明费率差异,并非衡量的任务实际成本。
对于重复任务,请记录完整账单以及达到可接受结果所需的时间。看似更便宜的请求,若需要大量修正,可能会变成更昂贵的工作流。更昂贵的请求则必须通过它交付的结果来证明其价值。
编程:别只盯着接近的评测分数
Kimi 的发布报告显示,K3.1 Pro 在 Terminal-Bench 4.0 上与 Opus 5.5 非常接近。这些结果反映的是某种特定评估设置,并不保证你仓库的表现。
要做有意义的编程对比,请选择一个已知会失败、且有明确验收测试的任务。让每个模型处于相同的项目状态、相同的问题描述、相同的工具访问权限与相同的时间预算。分别保留独立副本,避免某一次运行从另一方的改动中获益。
每次运行后检查三件事:问题是否已解决、是否发生了与任务无关的行为变化、解释是否与实际修改一致。记录任何人工介入。如果某个模型在中途需要提示,那么这次介入也应当计入结果。
一个小的界面修复测试与一个多文件重构测试会体现出不同的能力。只有在两者都代表你的工作负载时才纳入。单个成功演示不足以作为推动整个工程工作流的依据。
文档分析:检验结论在核查后是否仍然成立
用于研究时,对比应包含一个无法通过“总结单份文档”来回答的问题。使用包含过期图表、带限定条件的主张或明显分歧的资料集。
尝试对两种模型使用相同的提示:
比较所提供的报告。标出彼此一致的主张、相互冲突的主张,以及在现有证据下无法调和的主张。为每一项引用其来源与具体位置。将报告事实与推断/解读分开。
先不要查看模型标签,再审阅答案。统计不受支持的主张以及遗漏的限定条件。检查任一模型是否通过“编造解释”来解决分歧。
如果你使用 iWeaver 来整理资料集,那么 AI 文档摘要器可以帮助你建立整体概览。保持实际对比输入的一致性;给一个模型整理好的摘要、另一个模型直接给原始文件,会制造出不同的实验。
你应该何时先评估 K3.1 Pro?
使用 如何使用 Kimi K3.1 Pro 来设置第一个任务,并核查结果。
当较低的标价 API 费率能真正解决你的成本约束,且你有一个可重复的任务用来测试时,就从 K3.1 Pro 开始。若新发布版本的编程与研究侧重点与你需要完成的工作匹配,那么它也同样是合理的候选。
Kimi K3.1 Pro 可在 iWeaver 中使用,并且 iWeaver 提供该模型的免费试用。一个“文档范围受限”的任务是很实用的首轮评估:选择你了解的来源、明确输出要求,并核查关键结论性主张。
试用条款并不能决定使用 Kimi API 的实际成本。请根据各自条款对每条访问路径进行评估。
你应该何时在对比中保留 Opus 5.5?
在为“加速输出”付费之前,先阅读 Kimi K3.1 Pro vs. Highspeed,以便将“速度”和“任务质量”区分开来。
如果你已经拥有一个与 Opus 配合良好的工作流,那么在评估中保留 Opus。成熟流程很有价值:提示词、工具使用习惯、评审习惯以及已接受的输出都需要时间去重建。
在切换之前,先让 K3.1 Pro 对一组有代表性的样本进行测试。纳入一个常规任务、一个难任务,以及一个你当前工作流处理得不太好的案例。新模型最有用的情况,是它能解决一个具体问题,或降低获得可接受结果的成本。
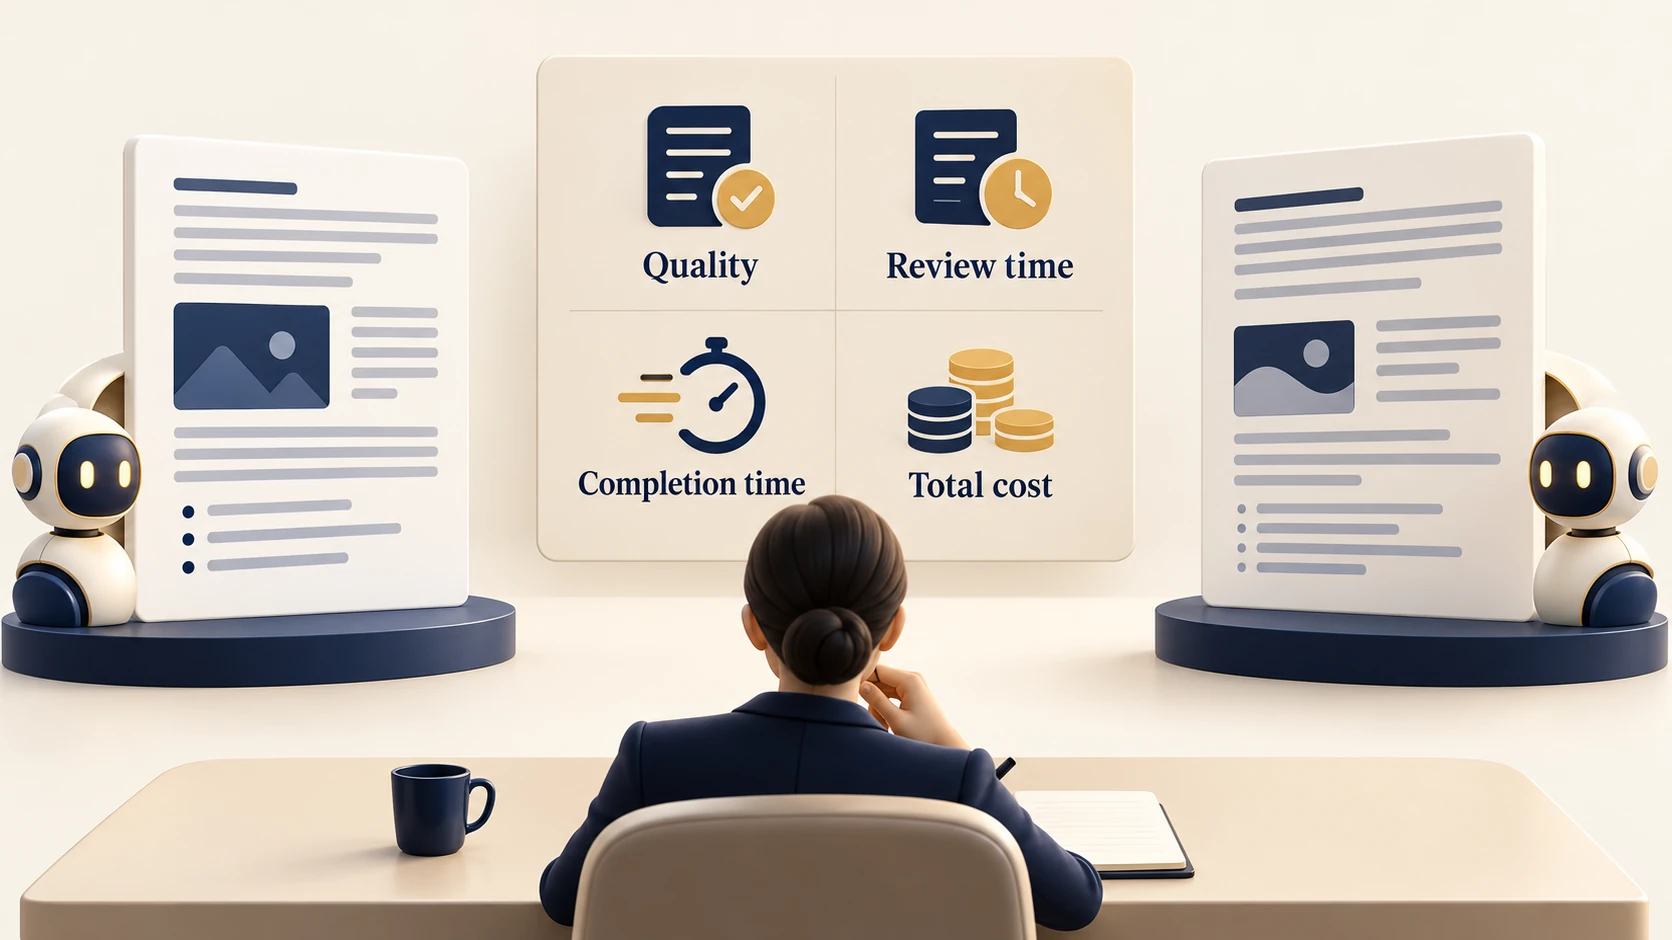
做最终选择时,使用一个简单的评分表:已接受输出、修正耗时、完成时间与总成本。根据岗位权重调整这些因素。研究团队可能会把证据质量放在第一位;批处理系统则可能在达到最低质量门槛后更关注成本。
并不需要在所有任务里都宣布某个模型“胜出”。当 K3.1 Pro 能在你的约束条件下交付更好的结果时就选它;当你的评估表明 Opus 仍值得保留时,就保留 Opus。