
Claude Haiku 5.5 ist am 7. Oktober 2026 erschienen – mit einem klaren Ziel: häufige, eng abgegrenzte KI-Aufgaben wirtschaftlicher zu machen. Anthropic positioniert es für Arbeiten wie Zusammenfassungen, Klassifizierungen und kleinere Aufgaben innerhalb größerer Agent-Workflows. Für Leser, die mit Forschung und Dokumenten arbeiten, ist die entscheidende Frage: Wo kann ein schnelles Modell die Routinevorbereitung übernehmen – und die schwierige Interpretation für eine tiefere Prüfung übriglassen?
Die Veröffentlichung verdient Aufmerksamkeit, aber der genannte Einstiegspreis braucht Kontext. Die Prompt-Länge verändert die API-Rate, und die Kosten eines Modells pro Token sagen dir nicht, wie viel ein kompletter Workflow tatsächlich kostet. Hier ist, was du wissen solltest, bevor du Haiku 5.5 für dein nächstes Projekt auswählst.
Was ist neu in Claude Haiku 5.5?
Haiku 5.5 ergänzt die Haiku-Familie um einstellbaren Aufwand und gibt Nutzern so die Möglichkeit, zu steuern, wie tief das Modell nachdenkt. In der offiziellen Modellübersicht werden adaptives Denken, ein Kontextfenster von einer Million Tokens, Text- und Bildinputs sowie Textausgabe genannt. Das sind Model-Fähigkeiten; eine bestimmte App kann dafür aber nur eine kleinere Auswahl an Steuerungen oder Eingabeoptionen bereitstellen.
Diese Unterscheidung ist wichtig, wenn du Tools vergleichst. Ein Modell kann zwar ein großes Kontextfenster unterstützen, aber nicht jede Oberfläche lässt dich entsprechend viel Material auch tatsächlich einreichen. Ebenso bedeutet Bildverständnis nicht Bildgenerierung, und ein Aufwand-Parameter in der API garantiert keinen Aufwand-Selector in jedem Consumer-Produkt.
Die praktische Änderung ist Flexibilität in der Kategorie der Small Models. Eine schnelle Sortieraufgabe und eine sorgfältige Dokumentextraktion benötigen nicht identische Anweisungen oder die gleiche Menge an Denkaufwand. Haiku 5.5 gibt Entwicklern mehr Kontrolle über diesen Trade-off – während Alltagsnutzer prüfen sollten, welche Steuerungen ihre gewählte Oberfläche tatsächlich bietet.
Claude Haiku 5.5 Preis: Prompt-Länge-Tier prüfen
Anthropics veröffentlichte Standard-API-Raten verwenden zwei Prompt-Länge-Tiers. Die folgenden Werte sind in US-Dollar pro Million Tokens angegeben und beschreiben die Claude-Platform-Preise – statt einer Abo-Gebühr oder der Abrechnung einer Drittanbieter-App.
| Prompt length | Input tokens | Output tokens |
|---|---|---|
| Bis zu 100.000 Tokens | $0.10 | $0.50 |
| Über 100.000 Tokens | $0.50 | $2.50 |
Für Prompts bis zu 100.000 Tokens liegen die aufgeführten Token-Raten 90% unter Haiku 4.5. Oberhalb dieser Schwelle beträgt die Reduktion 50%. Anthropic schätzt zudem separat eine durchschnittliche Reduktion der Betriebskosten von rund 75% – unter Berücksichtigung der bisherigen Request-Mischung und Änderungen in der Token-Nutzung. Diese Prozentsätze beschreiben verschiedene Vergleiche und sollten nicht als austauschbar verwendet werden.
Als einfache Veranschaulichung kostet eine Anfrage mit 20.000 Input-Tokens und 2.000 abrechenbaren Output-Tokens bei den niedrigeren Standardraten etwa $0.003. Eine Anfrage mit 120.000 Input-Tokens und derselben abrechenbaren Output-Menge kostet bei den höheren Raten etwa $0.065. Diese Berechnungen schließen Caching, Rabatte, Tool-Gebühren und alle zusätzlichen abrechenbaren Tokens aus; es sind Beispiele, keine Schätzungen typischer Dokumentkosten.
Die wichtigste Erkenntnis: Miss den kompletten Request. Mehr Hintergrund, ein längeres Gespräch beizubehalten oder nach einer längeren Antwort zu fragen, kann die Rechnung verändern. Bevor du einen bestehenden Workflow umstellst, vergleiche die tatsächliche Token-Nutzung und wie viel Korrektur das Ergebnis benötigt.
Wo Haiku 5.5 in der Dokumentenarbeit passt
Anthropic nennt Klassifizierung, Extraktion, Routing und Subagent-Aufgaben als beabsichtigte Einsatzbereiche. Das legt als praktischen Ausgangspunkt nahe: Gib Haiku eine klar begrenzte Aufgabe mit einem Output, den du prüfen kannst – statt es zu bitten, in einer einzigen Antwort ein komplettes Forschungsprojekt aufzulösen.
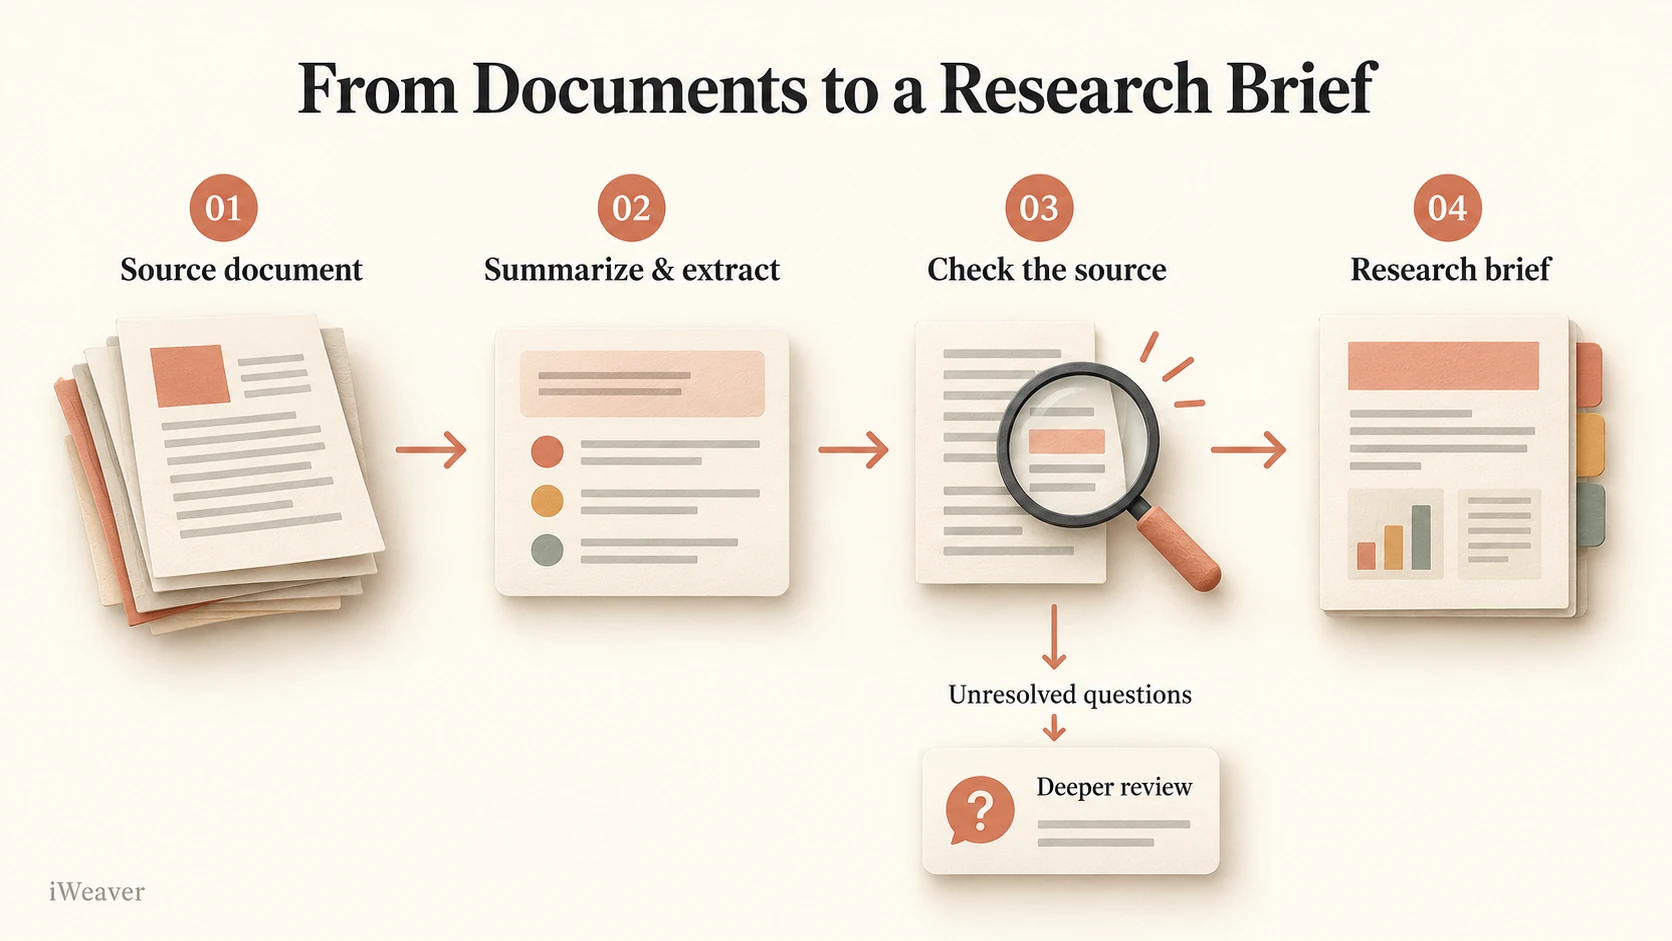
Stell dir einen Ordner mit Forschungsberichten vor. Der erste Job könnte sein, das Thema jedes Berichts, das Veröffentlichungsdatum und die zentrale Frage zu identifizieren. Der nächste könnte sein, die formulierten Findings in eine konsistente Tabelle zu extrahieren. Erst danach fragst du, welche Findings übereinstimmen, wo sich die Methoden unterscheiden und was weiterhin ungeklärt bleibt. Das ist ein Vorschlag für einen redaktionellen Workflow – keine Behauptung, dass wir Haiku 5.5 auf genau diese Berichte getestet haben.
| Task | A useful output | What to check |
|---|---|---|
| Sort incoming material | Themenbezeichnungen mit kurzen Begründungen | Unklare Dokumente und inkonsistente Labels |
| Bereite eine erste Zusammenfassung vor | Hauptaussagen und unterstützende Details | Fehlende Qualifikationen und veränderte Bedeutung |
| Extrahiere vergleichbare Fakten | Eine Tabelle mit Quellpositionen | Einheiten, Daten, fehlende Werte und Zuordnung |
| Bereite eine Übergabe vor | Findings, Unsicherheiten und offene Fragen | Ob der nächste Reviewer die Evidenz nachverfolgen kann |
Ein Prompt für einen evidence-fokussierten ersten Durchlauf
Nutze diesen Prompt mit einem Dokument, das du neben der Antwort prüfen kannst. Er fordert eine strukturierte Lesehilfe an und hält unbelegte Interpretationen getrennt von der Extraktion.
Lies das bereitgestellte Dokument und erstelle ein Research-Briefing.

Verwende diese Abschnitte:
1. Hauptfrage: Welches Problem adressiert das Dokument?
2. Zentrale Findings: Identifiziere bis zu fünf Findings, die in der Quelle genannt werden.
3. Unterstützende Evidenz: Gib den Abschnitt oder die Seite für jedes Finding an
   wenn diese Information im bereitgestellten Material verfügbar ist.
4. Grenzen: Bewahre die Qualifikationen des Autors und die Einschränkungen auf.
5. Offene Fragen: Liste Punkte auf, die das Dokument nicht auflöst.

Nutze ausschließlich das bereitgestellte Material. Wenn ein Detail oder eine Quellenposition
nicht verfügbar ist, sag das. Trenne deine Interpretation von den Aussagen aus der Quelle.
Erfinde keine Zitate, Statistiken oder Seitenzahlen.
Nachdem du das Briefing erhalten hast, prüfe ein paar Findings gegen das Original. Wenn eine Aussage Details aus verschiedenen Abschnitten kombiniert, bitte das Modell, sie zu trennen und die unterstützenden Passagen zu identifizieren. Eine gut ausgearbeitete Zusammenfassung wird erst dann nützlich, wenn sie die Unterschiede bewahrt, die du für deine Arbeit brauchst.
Wie viel Aufwand solltest du verwenden?
Anthropics Hinweise zur Prompt-Erstellung empfehlen, mit medium zu starten – dem Default in der Claude API und in Claude Code. high wird als geeignet für Wissensarbeit und längere Aufgaben beschrieben, während höhere Stufen ihre Mehrkosten über die Bewertung rechtfertigen sollten. Die Anleitung weist außerdem darauf hin, dass längeres Nachdenken die Antwortlänge und den Token-Verbrauch beeinflussen kann. Für einen Dokument-Workflow: Halte Quelle und Prompt konstant, während du die Einstellungen vergleichst, die deine Oberfläche unterstützt. Bewerte, ob die Antwort Einschränkungen (Caveats) beibehält, dem Format folgt und fehlende Informationen identifiziert. Wähle die Einstellung, die ein akzeptables Ergebnis mit einer angemessenen Menge an Review liefert; eine längere Antwort allein belegt nicht automatisch eine bessere Qualität.
Wann Sonnet oder Opus die bessere Wahl sein können
Anthropic empfiehlt weiterhin Sonnet 5.5 und Opus 5.5 für komplexe agentische Coding-Arbeiten. Die beabsichtigte Rolle von Haiku umfasst kleinere, klar definierte Aufgaben, die einen größeren Workflow unterstützen können. Die Veröffentlichung bietet den Nutzern daher eine zusätzliche Routing-Option, statt ein einzelnes Modell als die richtige Wahl für jede Aufgabe festzulegen.
Für Forschungsarbeiten sollte die Entscheidung von deinen eigenen Beispielen abhängen. Ein Modell, das Felder gut extrahiert, kann bei widersprüchlicher Evidenz dennoch Schwierigkeiten haben. Wenn die Aufgabe eine anhaltende Interpretation über mehrere Quellen hinweg erfordert, vergleiche ein größeres Modell mit demselben Material und bewerte die resultierende Arbeit – einschließlich der Zeit, die nötig ist, um sie zu korrigieren. Unser Claude Sonnet 5.5 Überblick liefert Hintergrund zu einem weiteren Modell aus der Familie.
Wandle die Modell-Ausgabe in einen wiederverwendbaren Workflow um
Ein Modell auszuwählen ist nur ein Teil der Wissensarbeit. Du musst außerdem das Quellmaterial zugänglich halten, die Interpretation überprüfen und hilfreiche Ergebnisse für die nächste Aufgabe organisieren. Die Dokument-Workflows von iWeaver umfassen Zusammenfassungen, Erklärungen und strukturierte Insights; sein PDF Explainer kann dir helfen, schwierige Abschnitte in einem PDF zu bearbeiten und nach klareren Erklärungen oder Beispielen zu fragen.
Claude Haiku 5.5 ist jetzt in iWeaver verfügbar, und iWeaver bietet eine kostenlose Testphase für das Modell. Starte mit einem Dokument-Briefing, einer Extraktionsaufgabe oder einer fokussierten Frage zu deinem Quellmaterial. Prüfe die Antwort gegen das Original, bevor du sie in Notizen oder einen Report umwandelst.
Für deine erste Haiku-5.5-Evaluierung wähle eine kleine, wiederholbare Aufgabe: ein Dokument-Briefing, eine Extraktionstabelle oder ein einzelner Klassifizierungslauf. Definiere, was eine akzeptable Antwort enthalten muss, prüfe es gegen die Quelle und halte fest, wie viel Überarbeitung nötig ist. Das gibt dir eine deutlich nützlichere Grundlage, um das Modell zu übernehmen – als nur ein Schlagzeilenpreis oder ein breiter Benchmark allein.