
Claude Opus 5.5 und OpenAI’s GPT-6-Familie konkurrieren jetzt um viele der gleichen anspruchsvollen KI-Workloads—aber sie gehen dabei unterschiedlich vor.
Anthropic positioniert Claude Opus 5.5 für langfristiges agentisches Coden und professionelles Arbeiten mit Wissen. OpenAI teilt GPT-6 auf drei Modelle auf: Astra für die schwierigsten End-to-End-Aufgaben, Sol für komplexes Coden und Agents und Luna für fokussierte, hochvolumige Workloads.
Damit ist der hilfreiche Vergleich nicht mehr einfach „Claude vs GPT“.
Sondern:
Claude Opus 5.5 vs GPT-6 Astra, Sol und Luna—welches Modell passt zu deinem tatsächlichen Workload?
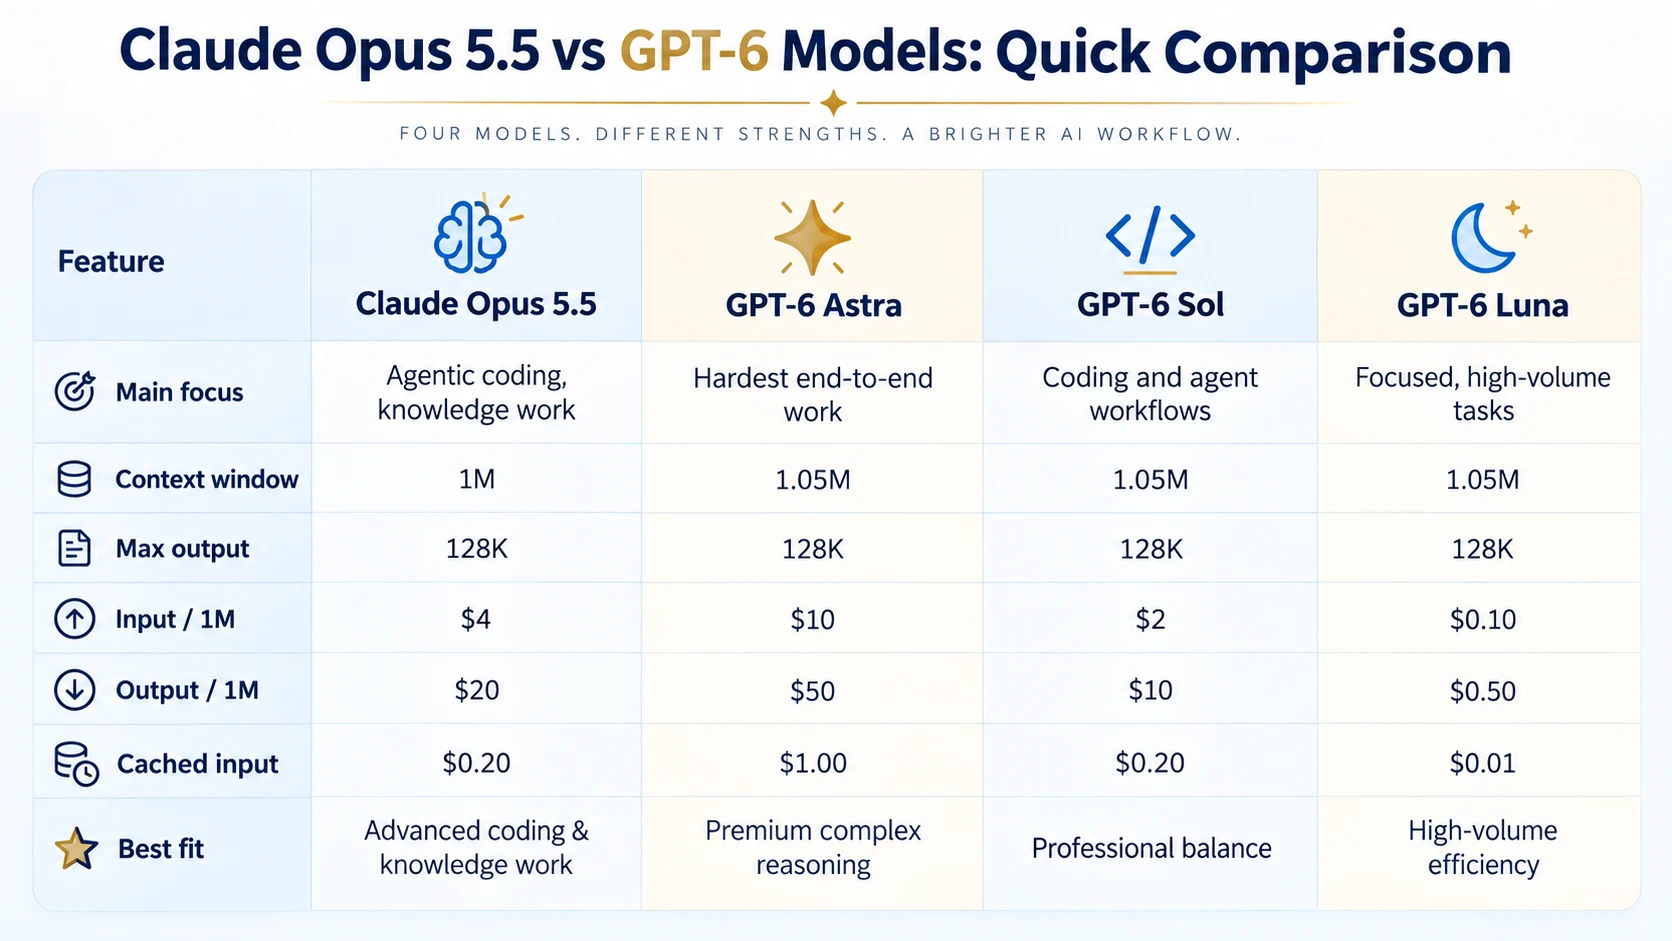
Claude Opus 5.5 vs GPT-6 im Überblick
| Feature | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| Hauptfokus | Agentisches Coden, Wissensarbeit | Schwierigste End-to-End-Arbeit | Coding- und Agent-Workflows | Fokussierte, hochvolumige Aufgaben |
| Kontextfenster | 1M | 1,05M | 1,05M | 1,05M |
| Max. Output | 128K | 128K | 128K | 128K |
| Input / 1M | $4 | $10 | $2 | $0.10 |
| Output / 1M | $20 | $50 | $10 | $0.50 |
| Cachen Input | $0.20 | $1.00 | $0.20 | $0.01 |
| Wissensstand | Juni 2026 | 30. Apr. 2026 | 20. Apr. 2026 | 18. Mai 2026 |
Claude Opus 5.5 unterstützt ein 1M-Token-Kontextfenster und 128K Standard-Output, während alle drei GPT-6-Modelle ein etwas größeres 1,05M-Kontextfenster bieten—bei demselben maximalen Output von 128K.
Claude Opus 5.5 vs GPT-6 Astra
GPT-6 Astra ist der nächstliegende direkte Vergleich zu Claude Opus 5.5, wenn die Aufgabe schwieriges Reasoning, Coden, Research oder langfristige Agents beinhaltet.
OpenAI beschreibt Astra als sein leistungsfähigstes Modell für die härteste End-to-End-Arbeit—inklusive komplexem Reasoning, Coden, Computer-Nutzung, Research und dem Erstellen von Dokumenten. Anthropic beschreibt Opus 5.5 als ein Modell für langfristiges agentisches Coden und Wissensarbeit.
Der größte praktische Unterschied ist der Preis.
Claude Opus 5.5 kostet:
- $4 / 1M Input-Token
- $20 / 1M Output-Token
GPT-6 Astra kostet:
- $10 / 1M Input-Token
- $50 / 1M Output-Token
Bei den standardmäßig angegebenen Raten kostet Opus 5.5 damit 60% weniger pro Input- und Output-Token als Astra.
Astra bietet zwar ein etwas größeres Kontextfenster—1,05M statt 1M—aber dieser Unterschied ist im Vergleich zur Preisdifferenz relativ klein.
Was zeigen die Benchmarks?
Die veröffentlichten Opus-5.5-Ergebnisse von Anthropic enthalten direkte Vergleiche mit GPT-6 Astra.
In Anthropics Tests schnitt Opus 5.5 bei Benchmarks wie Terminal-Bench 4.0 und FrontierCode v1.1 höher ab, während GPT-6 Astra bei Tests wie AutomationBench und Terminal-Bench-Science 0.1 vorne lag. Anthropic weist außerdem darauf hin, dass Benchmark-Unterschiede mit Vorsicht zu interpretieren sind, weil sich Testbedingungen und statistische Unsicherheit unterscheiden.
Das macht es schwierig, den Vergleich auf eine einzige Gesamtpunktzahl zu reduzieren.
Für echte Workflows ist oft der bessere Test, ob das Modell deine Coding-, Research- oder Agent-Aufgabe zuverlässig abschließen kann—und wie viel dich diese komplette Aufgabe kostet.
Claude Opus 5.5 vs GPT-6 Sol
GPT-6 Sol ist für viele professionelle Nutzer möglicherweise sogar die spannendere Alternative zu Opus 5.5.
Beide Modelle sind ausdrücklich um Coding- und agentische Workflows herum positioniert.
Aber ihre Preise unterscheiden sich:
| Modell | Input / 1M | Output / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
GPT-6 Sol kostet damit die Hälfte pro Standard-Input- und Output-Token.
Außerdem bietet es ein 1,05M-Kontextfenster im Vergleich zu den 1M von Opus 5.5. Beide unterstützen bis zu 128K Output-Token.
Das macht Sol für häufige Workloads interessant, wie etwa:
- Tägliches Coden
- Code Review
- KI-Agents
- Tool-basierte Workflows
- Research
- Dokumentanalyse
- Business-Automation
Opus 5.5 wird besonders interessant, wenn du Anthropics Opus-klassisches Reasoning und den Fokus auf langfristige agentische Aufgaben willst—während Sol als kostenbewusste Option für wiederkehrendes Coding und Agent-Workloads positioniert ist.
Claude Opus 5.5 vs GPT-6 Luna
Claude Opus 5.5 und GPT-6 Luna zielen auf sehr unterschiedliche Workloads.
Luna ist OpenAIs effizientestes GPT-6-Modell für fokussierte, hochvolumige Aufgaben. Sein API-Preis ist nur:
- $0.10 / 1M Input-Token
- $0.50 / 1M Output-Token
Das liegt weit unter den $4 / $20 von Opus 5.5.
Luna macht mehr Sinn für Aufgaben wie:
- Klassifikation
- Informationsextraktion
- Formatierung
- Kurze Zusammenfassungen
- Content Processing
- Wiederholte Automation
Opus 5.5 ist dagegen auf das andere Ende des Workload-Spektrums ausgerichtet: komplexes Coden, tiefere Wissensarbeit und Aufgaben, die über viele Schritte hinweg dauerhaftes Reasoning erfordern können.
Daher ist das weniger ein direktes „Modell gegen Modell“ als vielmehr die Frage, ob eine Aufgabe überhaupt ein fortgeschrittenes Reasoning-Modell braucht.
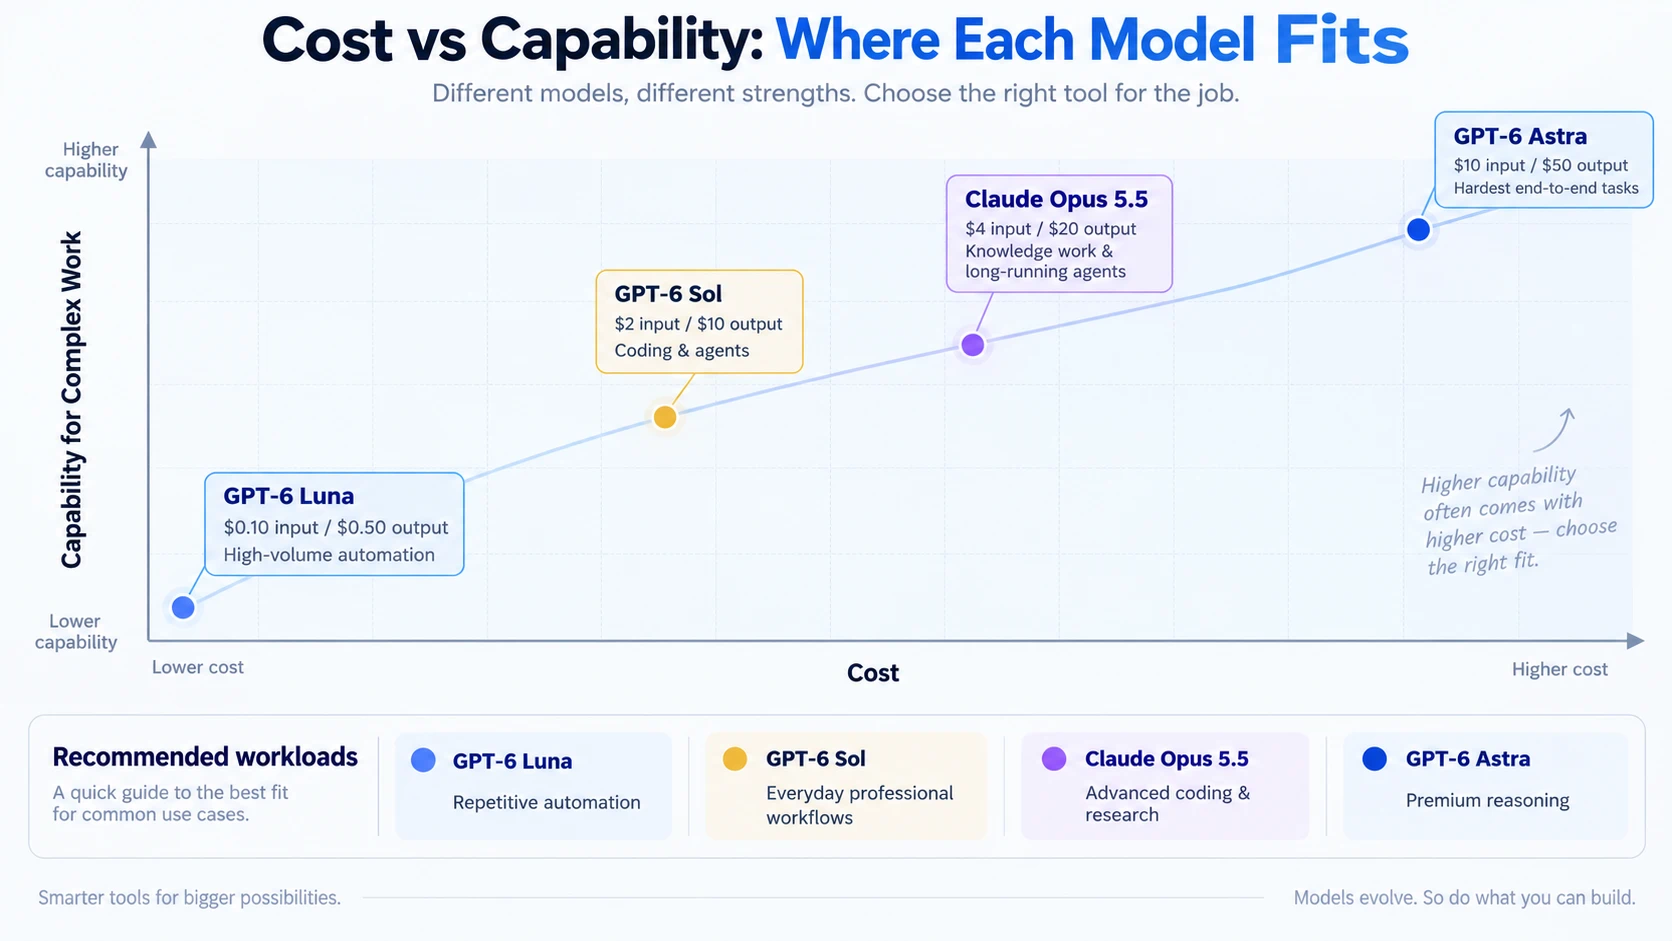
Preisgestaltung: Wo jedes Modell passt
Die Preisleiter macht die Positionierung besonders klar.
| Modell | Input | Output | Relative Position |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | Effizienz für hohe Volumina |
| GPT-6 Sol | $2 | $10 | Professionelles Gleichgewicht |
| Claude Opus 5.5 | $4 | $20 | Fortgeschrittenes Coding & Wissensarbeit |
| GPT-6 Astra | $10 | $50 | Premium-End-to-End-Reasoning |
Das sind die standardmäßig gelisteten Token-Preise. OpenAI wendet höhere Preise auf GPT-6-Anfragen an, die mehr als 272K Input-Token enthalten—daher können Workloads mit sehr langem Kontext die Kostenermittlung verändern.
Anthropic unterstützt außerdem Prompt-Caching bei Opus 5.5 mit $0.20 pro Million Cache-Read-Token, was vor allem für Agents wichtig sein kann, die große Kontexte wiederholt verwenden.
Welches Modell passt zu welcher Aufgabe?
Eine praktische Art, die vier Modelle zu vergleichen, ist nach Workload statt nach Marke.
| Aufgabe | Modelle, die sich zum Testen lohnen |
|---|---|
| Schwieriges End-to-End-Reasoning | Claude Opus 5.5 / GPT-6 Astra |
| Große Coding-Projekte | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Lang laufende Agents | Claude Opus 5.5 / GPT-6 Sol / Astra |
| Alltägliches professionelles Coden | GPT-6 Sol / Claude Opus 5.5 |
| Research und Wissensarbeit | Claude Opus 5.5 / GPT-6 Astra / Sol |
| High-Volume-Extraktion | GPT-6 Luna |
| Klassifikation und Formatierung | GPT-6 Luna |
| Wiederholte Automation | GPT-6 Luna / Sol |
Es gibt keinen Grund, dass jeder Schritt in einem Workflow zwangsläufig dasselbe Modell verwenden muss.
Ein Production-Agent könnte Luna für eine leichte Extraktion nutzen, Sol für regelmäßige Reasoning-Schritte und besonders schwierige Aufgaben an Astra oder Opus 5.5 weiterleiten.
Das kann für die Kosten sogar wichtiger sein als die Entscheidung, ein einziges Modell für alles zu wählen.
Teste Claude Opus 5.5 und die GPT-6-Serie auf iWeaver
Spezifikationen und Benchmarks sind hilfreich, aber sie sagen nicht immer zuverlässig voraus, welches Modell mit deinen eigenen Dokumenten, Prompts oder deinem Workflow besser funktioniert.
iWeaver ermöglicht es dir, Claude Opus 5.5 parallel zur GPT-6-Serie zu testen—inklusive GPT-6 Astra, Sol und Luna, ohne separate API-Integrationen aufzubauen.
iWeaver bietet außerdem kostenlose tägliche Credits, sodass du dieselbe echte Aufgabe über verschiedene Modelle hinweg testen kannst—zum Beispiel:
- PDFs zusammenfassen
- Mehrere Dokumente vergleichen
- Research und Analyse
- Schreiben
- Wissensextraktion
- Coding-Fragen
Wenn du dieselbe Aufgabe durch mehrere Modelle laufen lässt, kannst du viel leichter Tiefe der Antworten, Geschwindigkeit und Nutzen vergleichen—statt dich nur auf Benchmark-Zahlen zu verlassen.
Wenn du ganz gezielt mit OpenAIs Flaggschiff-Modell starten willst, sieh dir unseren Guide an: wie du GPT-6 Astra kostenlos nutzt.
Claude Opus 5.5 nimmt eine interessante Position im aktuellen Markt der Frontier-Modelle ein.
Es kostet deutlich weniger als GPT-6 Astra und zielt gleichzeitig auf ähnlich anspruchsvolle Use Cases für Coding, Agents und Wissensarbeit. GPT-6 Sol unterbietet Opus 5.5 beim Preis und fokussiert stark auf Coding und Agents, während GPT-6 Luna einen ganz anderen Bedarf abdeckt: günstige Verarbeitung im großen Maßstab.
Die entscheidende Frage ist daher nicht nur „Claude Opus 5.5 oder GPT-6?“
Sondern: Ob deine Aufgabe Flaggschiff-Reasoning, ausgewogene professionelle Performance oder Effizienz bei hohen Volumina benötigt.
Aus diesem Grund ist es oft aufschlussreicher, denselben Workflow über Opus 5.5, Astra, Sol und Luna zu testen, als sich ausschließlich aus Benchmark-Tabellen entscheiden zu lassen.