
Claude Sonnet 5.5 und Claude Opus 5.5 unterscheiden sich weniger durch eine simple „gut vs. besser“-Hierarchie, sondern vielmehr durch die Form der jeweiligen Aufgabe. Anthropic positioniert Sonnet als die schnellere, kostengünstigere Wahl für klar umrissene Alltagsarbeiten, während Opus für komplexe, offen formulierte Probleme gedacht ist, die über viele Schritte hinweg sorgfältiges Urteilsvermögen erfordern. Sonnet kostet halb so viel pro Standard-Input- und Output-Token, kommt aber in mehreren veröffentlichten Auswertungen überraschend nah an Opus heran.
Ein Benchmark kann zeigen, ob ein Modell in einer kontrollierten Umgebung erfolgreich war, aber er bildet möglicherweise nicht ab, wie zuverlässig das Modell mit Mehrdeutigkeit umgeht oder konkurrierende Anforderungen während eines langen Projekts im Blick behält. Die Entscheidung zwischen beiden ist eine Routing-Entscheidung: Nutze das günstigste Modell, das die Qualitäts- und Risikoanforderungen der Aufgabe erfüllt.
Sonnet 5.5 vs Opus 5.5 im Überblick
| Detail | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Veröffentlichungsdatum | 28. September 2026 | 22. September 2026 |
| Standard-Input-Preis | 2 $ pro 1M Tokens | 4 $ pro 1M Tokens |
| Standard-Output-Preis | 10 $ pro 1M Tokens | 20 $ pro 1M Tokens |
| Cache-Lese-Preis | 0,20 $ pro 1M Tokens | 0,20 $ pro 1M Tokens |
| Cache-Schreib-Preis | 2,50 $ pro 1M Tokens | 5 $ pro 1M Tokens |
| Angegebenes Einsatzprofil | Schnell, gut umrissene Alltagsarbeit | Komplexe Arbeit mit dauerhaftem Urteilsvermögen |
| API-Modellname | claude-sonnet-5-5 |
claude-opus-5-5 |
Die Zahlen oben stammen aus den offiziellen Ankündigungen von Anthropic für Sonnet 5.5 und Opus 5.5. Das sind Standard-API-Raten; Fast Mode, regionale Inferenz, Cloud-Plattformen und ein Abo-Zugang können anderen Preis- oder Nutzungsregeln folgen.
Was die Benchmarks wirklich zeigen
Sonnet 5.5 liegt in mehreren von Anthropic berichteten Auswertungen nahe an Opus 5.5 heran, aber der Vorsprung wechselt je nach Aufgabe. Genau deshalb sollten beide Modelle nicht auf eine einzige Punktzahl reduziert werden.
| Benchmark | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70,6% | 66,4% |
| FrontierCode 1.1 Main | 46,2% bei Max | 54,4% |
| CursorBench 4.0 | 55,5% | 57,8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
Sonnet führt im veröffentlichten Terminal-Bench-Ergebnis, während Opus bei FrontierCode, CursorBench, GDPval-AA und AA-Briefcase vorn liegt. Die kleine Lücke bei GDPval-AA ist bemerkenswert, aber Anthropic sagt ausdrücklich, dass Opus in den Erfahrungen eigener sowie externer Tester bei komplexer, offen formulierter Arbeit, die dauerhaftes Urteilsvermögen erfordert, klar stärker bleibt. Auch Benchmark-Konfigurationen und Aufwandseinstellungen unterscheiden sich, daher sollte eine Zweipunkt-Lücke bei Zahlen nicht mit einem vollständigen Urteil zur Leistungsfähigkeit verwechselt werden.
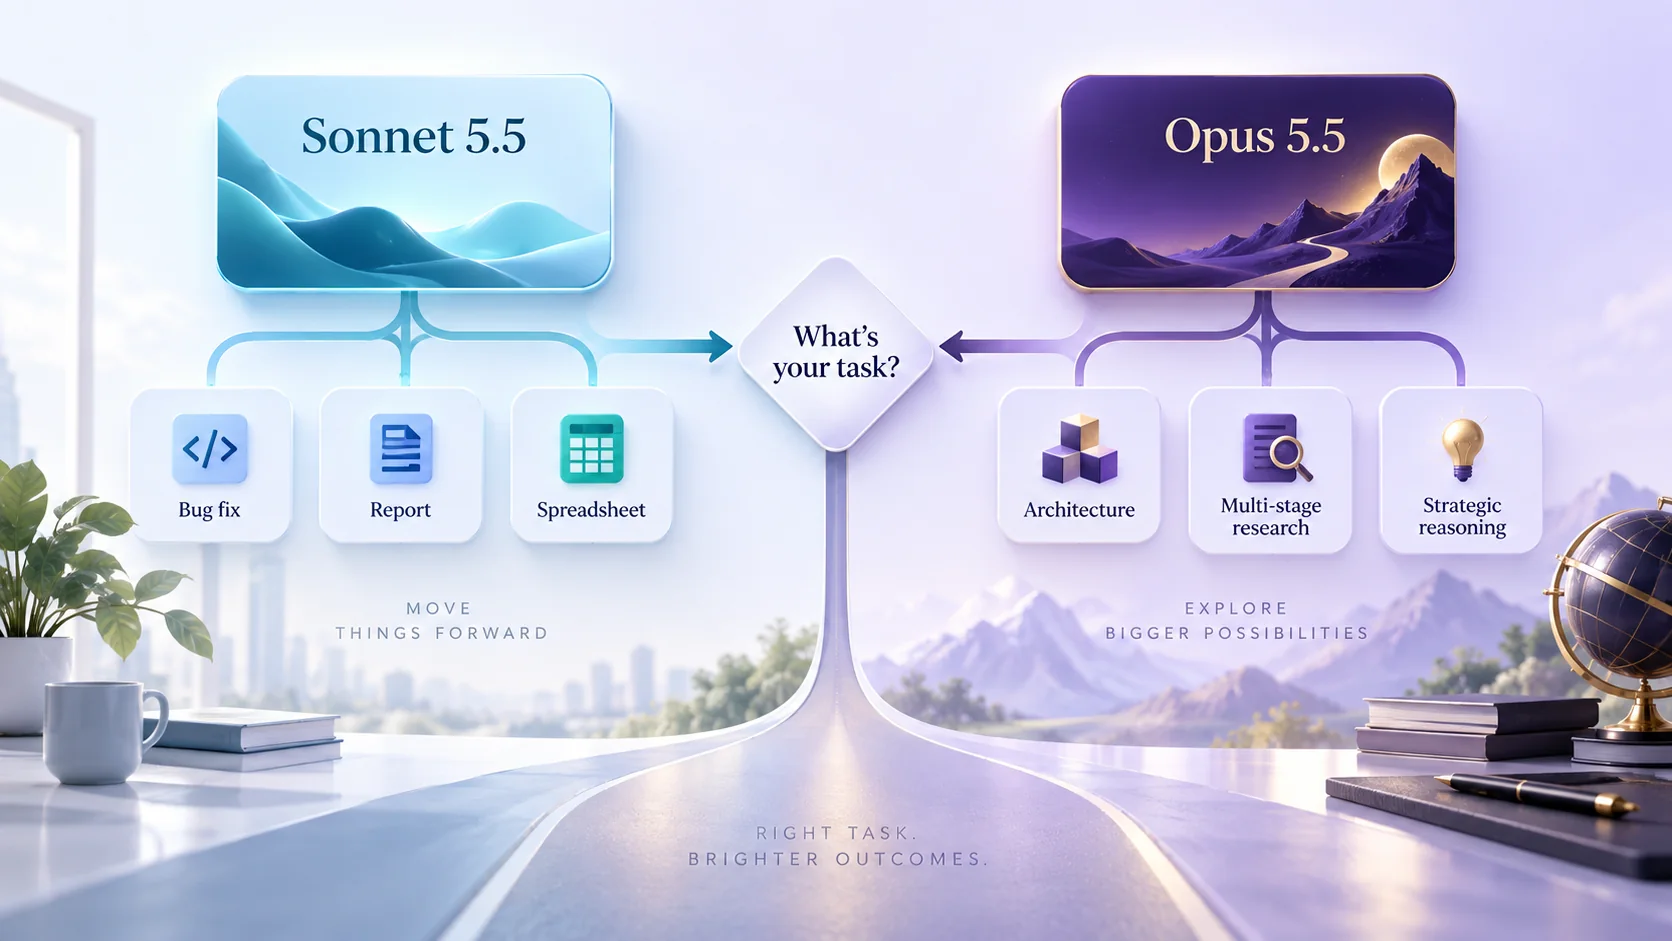
Sonnet ist sinnvoll, wenn Erfolg klar beschrieben und ohne umfangreiche Interpretation überprüft werden kann. Beispiele sind das Beheben eines reproduzierbaren Bugs, die Transformation eines bekannten Datensatzes, das Zusammenfassen einer definierten Dokumentensammlung, das Entwerfen einer Präsentation aus freigegebenen Erkenntnissen oder das Anwenden einer konsistenten Umformulierung über viele Dateien hinweg. Diese Aufgaben können zwar anspruchsvoll sein, haben aber Grenzen und eine erkennbare Ziellinie.
Der Preisunterschied wird bei großem Volumen besonders wichtig. Standard-Input- und Output-Token kosten halb so viel wie bei Opus, während Cache-Lesezugriffe gleich teuer sind. Außerdem sagt Anthropic, dass Sonnet 5.5 die Ausgabe mehr als 30% schneller generiert als Sonnet 5 – auch wenn diese Aussage nicht als direkter Geschwindigkeitsvergleich mit Opus 5.5 präsentiert wird. Teams sollten die Latenz unter eigener Last messen, statt davon auszugehen, dass der Modell-Tier-Name in jeder Umgebung die Antwortzeit zuverlässig vorhersagt.
Für wiederkehrende Workflows kann das einstellbare Effort von Sonnet helfen, die Kosten zu steuern. Geringerer Aufwand kann für Klassifizierung, Formatierung oder routinemäßige Entwürfe geeignet sein; höherer Aufwand kann gerechtfertigt sein für Code-Änderungen oder Analysen, die mehr Prüfung brauchen. Die wichtige Praxis: Akzeptanztests festlegen und schwierige Fälle eskalieren, statt für alles den maximalen Aufwand zu verwenden.
Wann Opus 5.5 seinen höheren Preis rechtfertigt
Opus ist der stärkere Kandidat, wenn das Modell das Problem beim Arbeiten definieren muss. Eine komplexe Code-Migration, eine funktionsübergreifende Strategie, eine mehrstufige Untersuchung oder eine mehrdeutige Analyse kann erfordern, dass das Modell Annahmen erneut aufgreift, Einschränkungen ausbalanciert und über eine lange Kette von Aktionen hinweg Kohärenz erhält. Genau das meint Anthropic mit „dauerhaftes Urteilsvermögen“.
Auch die Kosten-Nutzen-Rechnung verändert sich mit dem Risiko. Wenn ein Senior-Reviewer stundenlang damit verbringen muss, eine plausibel wirkende, aber subtil falsche Antwort zu reparieren, war das Sparen bei Tokens eine falsche Ökonomie. Opus kann die höhere Rate wert sein, wenn ein erfolgreicher Lauf größere Nacharbeit vermeidet – sollte aber dennoch gegen klare Kriterien bewertet werden; ein Premium-Label nimmt nicht die Notwendigkeit von Quellenchecks, Tests und menschlicher Freigabe.
Coding: Routen nach Umfang, nicht nach Prestige
Für das Programmieren startest du beim Aufgabenrahmen. Sonnet ist ein starker Default für einen lokalisierten Bug, einen gut spezifizierten Endpunkt, die Generierung von Tests oder einen begrenzten Refactor. Opus ist robuster für Architekturarbeit, die Koordination über mehrere Repositories hinweg, eine Migration mit unvollständigen Anforderungen oder eine Untersuchung, bei der die Ursache unbekannt ist.
Führe beide Modelle an einer repräsentativen Stichprobe aus, bevor du das Routing finalisierst. Bewerte Korrektheit, Regressionsrisiko, unnötige Änderungen, Testqualität, verstrichene Zeit, Token-Nutzung und den Aufwand des Reviewers. Der Hinweis von Anthropic zu FrontierCode ist hier relevant: Mehr Reasoning kann dazu führen, dass ein Agent Änderungen außerhalb des angefragten Rahmens vornimmt – daher gehört zur Qualität auch zu wissen, wann man aufhören sollte.
Research- und Dokumentationsarbeit
Die nahezu Opus-nahen Scores von Sonnet in Anthropics Knowledge-Work-Evaluierungen machen es zu einer überzeugenden Wahl für strukturierte Dokument-Workflows. Wenn die Aufgabe darin besteht, fünf Berichte zu vergleichen, vorgegebene Felder zu extrahieren oder genehmigte Notizen in eine Deck-Outline zu verwandeln, kann Sonnet die erforderliche Qualität zu geringeren Kosten liefern. Opus wird attraktiver, wenn sich Quellen widersprechen, sich die Forschungsfrage weiterentwickelt oder das Modell schwierige interpretative Entscheidungen treffen und vertreten muss.
Welches Modell du auch auswählst: Die Quellvorbereitung bestimmt oft die Ausgabequalität. Doppelte Dateien, unklare Versionen und fehlender Kontext können selbst ein starkes Modell ausbremsen. iWeavers AI Summarizer kann helfen, gemischte Dateien und Links in Zusammenfassungen, Kernpunkte, Executive Briefs oder strukturierte Notizen zu ordnen, bevor die höherstufige Analyse beginnt. Das ist ein ergänzender Informations-Workflow; er bedeutet nicht, dass eines der Claude-Modelle aktuell direkt in iWeaver auswählbar ist.
Eine praktische Routing-Regel
Nimm zuerst Sonnet, wenn die Aufgabe klare Inputs hat, ein klar definiertes Deliverable und eine unkomplizierte Validierungsmethode. Wechsel zu Opus, wenn das Problem nach der Klärung weiterhin mehrdeutig bleibt, sich über viele voneinander abhängige Stufen erstreckt, ein hohes Risiko für Fehlerkosten birgt oder deine Sonnet-Akzeptanztests wiederholt nicht bestehen. Diese Vorgehensweise liefert in der Regel ein nützlicheres Kosten-Qualitäts-Verhältnis, als ein einzelnes Modell für jede Anfrage zu wählen.
Die finale Entscheidung sollte auf der Ökonomie der abgeschlossenen Aufgabe basieren. Verfolge die gesamten Tokens, Cache-Nutzung, Retries, Latenz, die Zeit des Reviewers und die Schwere von Fehlschlägen anhand echter Beispiele. Die Benchmark-Gewinne von Sonnet 5.5 machen es zu einem glaubwürdigen Default für den Alltag; Opus 5.5 bleibt die bewusste Wahl, wenn Komplexität und Urteilsvermögen rechtfertigen, mehr zu bezahlen. Um das günstigere Modell im Detail zu untersuchen, siehe Claude Sonnet 5.5: Benchmarks, Pricing, Features & Was neu ist, oder fahre fort mit So verwendest du Claude Sonnet 5.5.