
Grok 4.7 ist offiziell da. Veröffentlicht am 21. September 2026, ist Grok 4.7 das neueste Frontier-Modell von xAI für Codierung, agentenbasierte Aufgaben und professionelles Wissensarbeiten.
Das ist mehr als nur ein kleines Update von Grok 4.6. xAI sagt, Grok 4.7 nutzt ein neues, größeres Basismodell, einen längeren Lauf für Reinforcement Learning und ein Training, das mehr Gewicht auf schwierige Aufgaben legt, die Stunden in Anspruch nehmen können. Außerdem verbessert es die Selbstverifikation und das Management von langen Kontexten – zwei Bereiche, die in echten Workflows viel wichtiger sind als das bloße Beantworten kurzer Prompts. Und im Gegensatz zu den frühen Spekulationen rund um Grok 4.7 haben wir jetzt offizielle Spezifikationen und Benchmark-Ergebnisse zum Vergleichen.
Veröffentlichungsdatum von Grok 4.7
Grok 4.7 ist offiziell gestartet. Es ist über die xAI API verfügbar als: grok-4.7
Zum Launch hat xAI das Modell außerdem über mehrere Coding- und KI-Plattformen zugänglich gemacht, darunter Grok Build und Cursor. Auch bei GitHub wird Grok 4.7 derzeit schrittweise an Nutzer von GitHub Copilot ausgerollt.
Für mehr Hintergrund zur vorherigen Generation kannst du dir auch unsere [Grok 4.6-Rezension](../grok-4-6/ ansehen).
Grok 4.7: Spezifikationen auf einen Blick
Hier sind die wichtigsten offiziellen Spezifikationen.
| Spezifikation | Grok 4.7 |
|---|---|
| Veröffentlichungsdatum | 21. September 2026 |
| Modellname | grok-4.7 |
| Kontextfenster | 500.000 Tokens |
| Wissensstand (Cutoff) | Mai 2026 |
| Eingabemodalitäten | Text und Bild |
| Ausgabemodalität | Text |
| Textausgabe-Limit | Kein festes Textausgabe-Limit |
| Reasoning-Level | Low, Medium, High, XHigh |
| Standard-Reasoning | High |
| Function Calling | Unterstützt |
| Websuche | Unterstützt |
| X-Suche | Unterstützt |
| Code-Ausführung | Unterstützt |
| API-Unterstützung | Responses API, Chat Completions |
Das 500K-Kontextfenster ist besonders nützlich für lange Dokumente, große Codebasen, Multi-File-Projekte, Rechercheaufgaben und Agent-Workflows, bei denen über die Zeit hinweg viele Informationen beibehalten werden müssen.
Grok 4.7 unterstützt zudem vier Reasoning-Level:
- Low
- Medium
- High
- XHigh
Das ermöglicht Entwicklern, je nach Aufgabe zwischen Geschwindigkeit und Tiefe des Reasonings abzuwägen.
Was ist neu in Grok 4.7?
Die wichtigsten Änderungen sind keine besonders auffälligen neuen Interface-Funktionen.
Stattdessen geht es um Verbesserungen darin, wie das Modell längere und anspruchsvollere Arbeiten bewältigt.
1. Ein neues, größeres Basismodell
Grok 4.7 basiert auf einem neuen und größeren Basismodell im Vergleich zu Grok 4.6.
Das ist relevant, weil es nicht einfach Grok 4.6 mit zusätzlichem Post-Training ist.
Das zugrunde liegende Modell selbst wurde geändert.
xAI hat es anschließend mit einem längeren Reinforcement-Learning-Run auf einer schwierigeren Mischung von Aufgaben trainiert – mit stärkerer Betonung von Problemen, die viele Stunden dauern können.
Das Ziel ist klar:
Grok besser machen beim Abschluss schwieriger Aufgaben – nicht nur beim guten Start.
2. Bessere Performance bei Langläufern
Viele KI-Modelle wirken bei kurzen Prompts beeindruckend, werden aber weniger zuverlässig, sobald eine Aufgabe länger dauert.
Das kann sich zeigen als:
- vergessene Anweisungen
- inkonsistente Entscheidungen
- wiederholte Arbeit
- übersehene Abhängigkeiten
- Fehler, die nie geprüft werden
- eine schlechte Nutzung früheren Kontexts
Grok 4.7 ist speziell darauf trainiert, bei länger laufenden Aufgaben besser abzuschneiden.
Das ist besonders relevant für Coding-Agenten, Recherche-Workflows, die Erstellung von Dokumenten und professionelles Arbeiten, das mehrere Phasen umfasst.
3. Bessere Selbstverifikation
Eine weitere wichtige Änderung ist ein stärkeres Selbst-Checking.
Statt einfach eine Antwort zu erzeugen und weiterzumachen, ist Grok 4.7 so konzipiert, dass es seine eigene Arbeit sorgfältiger verifiziert.
Das ist besonders wichtig bei Aufgaben wie:
- Debugging von Code
- Bearbeitung großer Projekte
- Überprüfen von Berechnungen
- Review von Dokumenten
- Befolgen langer Anweisungen
- Nutzung mehrerer Tools in Folge
Natürlich bedeutet Selbstverifikation nicht, dass das Modell keine Fehler machen kann.
Die menschliche Prüfung bleibt bei High-Stakes-Arbeit weiterhin wichtig.
Aber besseres internes Checking kann offensichtliche Fehlschläge in langen Workflows reduzieren.
4. Stärkere Agent- und Wissensarbeit
Grok 4.7 wurde außerdem darauf trainiert, xAIs Grok Bot-Routine besser zu verstehen.
Das macht das Modell besonders relevant für agentenartige Aufgaben, bei denen die KI mehr tun muss als nur eine einzelne Frage beantworten.
Zum Beispiel:
- Dateien inspizieren
- nach Informationen suchen
- Code schreiben
- Tools ausführen
- Ergebnisse überprüfen
- an der eigenen Arbeit nachbessern
- weitermachen, bis eine größere Aufgabe abgeschlossen ist
Das spiegelt einen breiteren Wandel in der Frontier-KI wider.
Die Kernfrage lautet nicht mehr nur:
Kann das Modell diese Frage beantworten?
Stattdessen heißt es immer häufiger:
Kann das Modell die gesamte Aufgabe abschließen?
Grok 4.7 Benchmarks
xAI hat Benchmark-Ergebnisse veröffentlicht, die Grok 4.7 mit Grok 4.6 und anderen Frontier-Modellen vergleichen.
Die Resultate zeigen besonders deutliche Zugewinne in Coding, terminalbasierten Aufgaben, Engineering sowie professionellem Wissensarbeiten.
Für den saubersten Vergleich fokussiert die folgende Tabelle Grok 4.7 vs Grok 4.6.
| Benchmark | Grok 4.7 | Grok 4.6 | Veränderung |
|---|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% | +5,9 Pkt |
| DeepSWE v1.1 | 71,0% | 65,2% | +5,8 Pkt |
| AA Briefcase v1.1 | 1.657 | 1.546 | +111 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | +17,7 Pkt |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | +3,8 Pkt |
| HealthBench Professional | 56,7% | 48,5% | +8,2 Pkt |
| EEBench | 64,0% | 53,0% | +11,0 Pkt |
Der größte Sprung in dieser Auswahl zeigt sich bei Terminal-Bench 4.0: Dort erzielt Grok 4.7 38,0% gegenüber 20,3% für Grok 4.6.
Das ist besonders relevant für agentenbasierte Coding-Workflows mit Terminal-Kommandos, Tools, Repositories und Multi-Step-Ausführung.
Grok 4.7 zeigt außerdem deutliche Gewinne in den Benchmarks für Electrical Engineering, professionelles Wissensarbeiten, Software Engineering und klinisches Reasoning.
Grok 4.7 vs Grok 4.6
Die Benchmark-Zahlen machen den Generationswechsel leichter sichtbar.
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Status | Vorherige Generation | Neueste Generation |
| Basismodell | Frühere Version | Neues, größeres Basismodell |
| Kontextfenster | — | 500K Tokens |
| Langläufer | Stark | Verbesser |
| Selbstverifikation | Stark | Verbessert |
| CursorBench 4.0 | 40,4% | 46,3% |
| DeepSWE v1.1 | 65,2% | 71,0% |
| Terminal-Bench 4.0 | 20,3% | 38,0% |
| EEBench | 53,0% | 64,0% |
| API-Eingabepreis | 2 $ / 1M Tokens | Startet bei 2 $ / 1M Tokens |
| API-Ausgabepreis | 6 $ / 1M Tokens | Startet bei 6 $ / 1M Tokens |
Der größte Grund, von Grok 4.6 auf Grok 4.7 umzusteigen, ist daher nicht eine einzelne Schlagzeilen-Funktion.
Es ist die Kombination aus:
besserem Coding + stärkerer Performance bei Langaufgaben + besserem Kontextmanagement + stärkerem Self-Checking.
Wenn dein Arbeitsalltag hauptsächlich aus kurzen täglichen Fragen besteht, kann der Unterschied kleiner wirken.
Für Entwickler und Nutzer, die lange, Multi-Step-Workflows ausführen, ist die Verbesserung jedoch deutlich aussagekräftiger.
Grok 4.7 Preise
Grok 4.7 startet bei:
- 2 $ pro 1 Million Input-Tokens
- 0,50 $ pro 1 Million gecachte Input-Tokens
- 6 $ pro 1 Million Output-Tokens
Diese Sätze gelten, wenn der Prompt unter 200K Tokens liegt.
Für Prompts über 200K Tokens erhöht sich der offizielle API-Preis auf:
- 4 $ pro 1 Million Input-Tokens
- 1 $ pro 1 Million gecachte Input-Tokens
- 12 $ pro 1 Million Output-Tokens
Diese gestaffelte Preisstruktur ist erwähnenswert, weil Grok 4.7 ein 500K-Kontextfenster hat.
Die Nutzung des gesamten Kontextfensters kann daher mehr kosten als kürzere Requests.
Was ist Grok 4.7 Fast?
xAI bietet außerdem Grok 4.7 Fast an.
Dabei handelt es sich um dasselbe zugrunde liegende Modell, das auf schnellerer Infrastruktur bereitgestellt wird.
Laut xAI liefert es etwa die doppelte Ausgabe-Geschwindigkeit bei doppelten Standard-Token-Raten.
Allerdings gibt es einen wichtigen Unterschied in der Verfügbarkeit:
Grok 4.7 Fast ist derzeit über Cursor und Grok Build verfügbar, aber nicht über die öffentliche xAI API.
Damit ist das Standardmodell Grok 4.7 die wichtigste Option für Entwickler, die direkt mit der xAI API bauen.
Wo kannst du Grok 4.7 nutzen?
Grok 4.7 ist bereits auf mehreren Plattformen verfügbar.
xAI API
Entwickler können verwenden:
grok-4.7
über die xAI Responses API oder Chat Completions API.
Es unterstützt Tools wie:
- Function Calling
- Websuche
- X-Suche
- Code-Ausführung
Grok Build
Grok 4.7 ist das Standardmodell für Grok Build, xAIs Coding- und App-Builder-Agent.
Cursor
Grok 4.7 ist in Cursor verfügbar.
Die Fast-Variante ist dort ebenfalls verfügbar.
Model Gateways
In der xAI-Dokumentation wird die Verfügbarkeit über Plattformen wie:
- OpenRouter
- Vercel
- Cloudflare
aufgeführt.
GitHub Copilot
GitHub hat am 21. September begonnen, Grok 4.7 für GitHub Copilot auszurollen.
Es wird für Copilot Pro, Pro+, Max, Business und Enterprise Pläne bereitgestellt.
Unterstützte Umgebungen sind unter anderem:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- GitHub Copilot Cloud-Agent
- GitHub Copilot App
- JetBrains
- Xcode
- Eclipse
Das Rollout erfolgt schrittweise, daher sehen manche Nutzer es möglicherweise nicht sofort.
Beurteile Grok 4.7 nicht anhand nur eines Benchmarks
Die offiziellen Ergebnisse sind hilfreich, aber eine Benchmark-Tabelle sollte nicht der letzte Grund sein, ein Modell auszuwählen.
Unterschiedliche Benchmarks testen unterschiedliche Dinge.
Ein Modell, das bei einem Coding-Benchmark gut abschneidet, ist nicht zwangsläufig die beste Wahl für:
- Forschung
- Dokumentenanalyse
- Schreiben
- Customer Support
- Data Extraction
- Zusammenfassungen
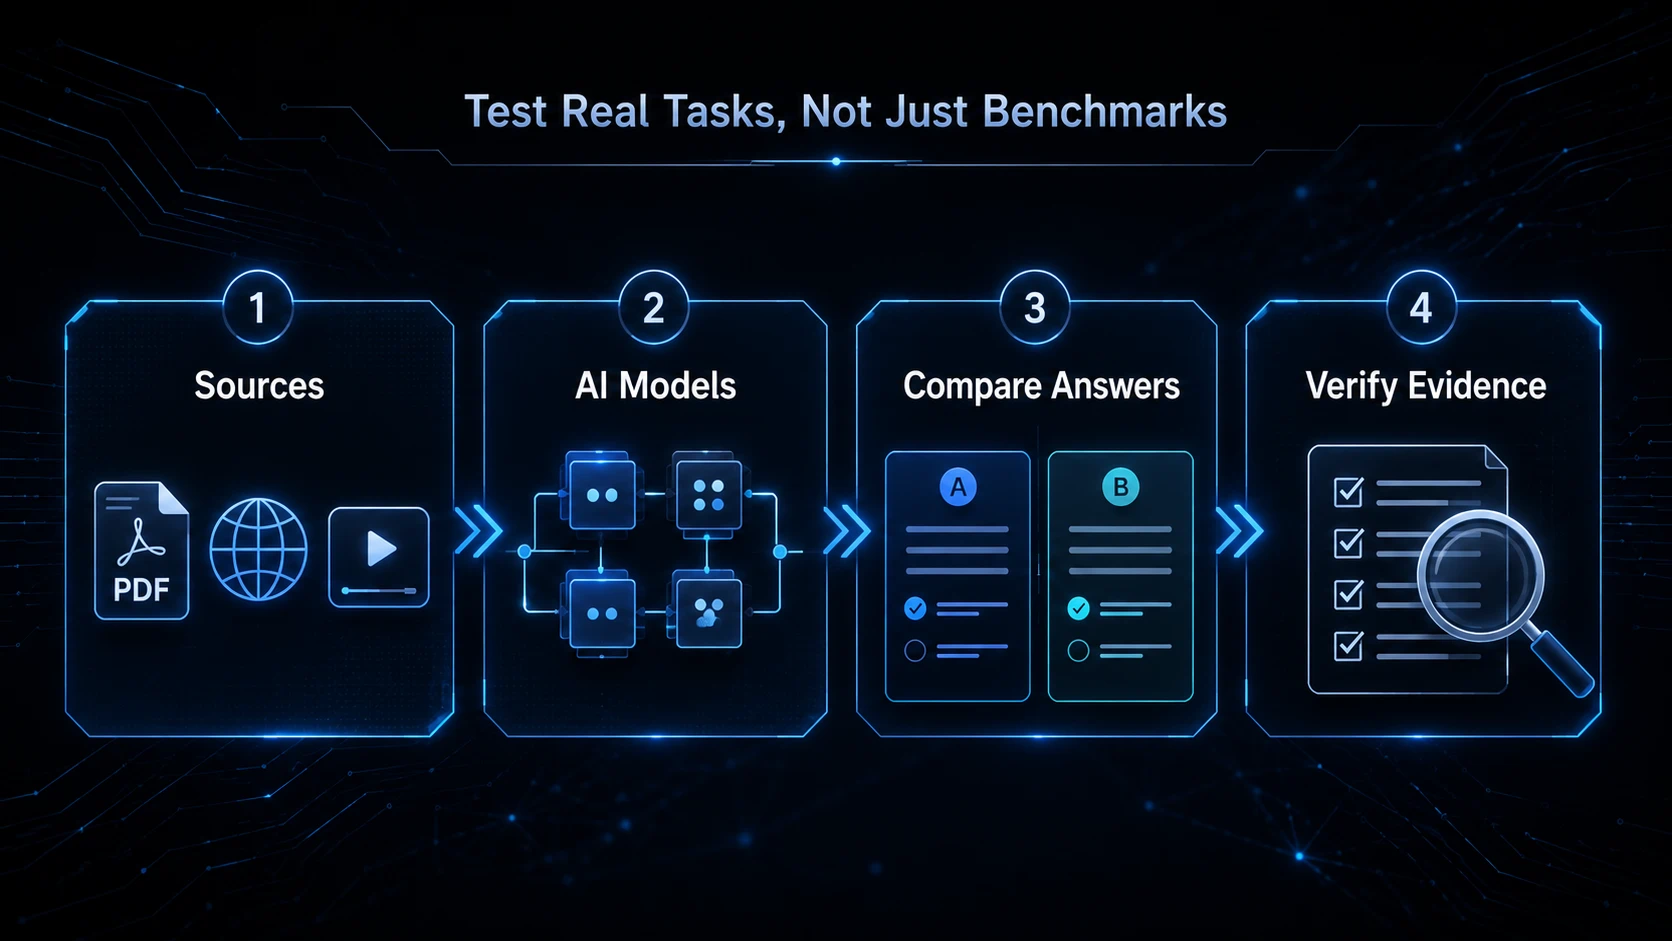
Ein besserer Test ist, Modelle anhand derselben echten Aufgabe zu vergleichen.
Zum Beispiel:
- Gib jedem Modell dieselbe Frage.
- Gib dieselben Quell-Dateien vor.
- Nutze dieselben Anweisungen.
- Vergleiche die finalen Antworten.
- Prüfe fehlende Informationen und sachliche Fehler.
- Überprüfe wichtige Schlussfolgerungen anhand der Originalquellen.
Wenn deine Arbeit PDFs, Websites, Videos, Präsentationen oder Recherche-Dokumente umfasst, können Tools wie iWeaver helfen, diese Materialien an einem Ort zu organisieren, bevor du die Modellausgaben vergleichst.
So lässt sich besser beurteilen, ob ein KI-Modell für deinen Workflow wirklich nützlich ist – statt nur auf einem Leaderboard besser abzuschneiden.
Lohnt sich die Nutzung von Grok 4.7?
Für Coding- und agentenbasierte Workflows ist Grok 4.7 ein bedeutendes Update gegenüber Grok 4.6.
Die offiziellen Benchmark-Daten zeigen Verbesserungen in Software Engineering, Terminal-Arbeiten, professionellen Aufgaben, Electrical Engineering, juristischen Aufgaben und klinischem Reasoning.
Die Kombination aus 500K-Kontextfenster, stärkerer Performance bei Langaufgaben, verbesserter Selbstverifikation, Tool-Unterstützung und unveränderten Start-API-Preisen macht das Modell außerdem praktischer für größere Workflows.
Das bedeutet nicht, dass Grok 4.7 für jede Aufgabe das beste Modell sein wird.
Unterschiedliche Modelle haben weiterhin unterschiedliche Stärken, und Benchmark-Ergebnisse lassen sich nicht immer 1:1 in bessere Ausgaben in der Praxis übertragen.
Aber Grok 4.7 gibt Entwicklern und professionellen Nutzern eine stärkere Option als Grok 4.6 – besonders wenn eine Aufgabe viele Schritte, große Mengen Kontext oder eine erweiterte Tool-Nutzung beinhaltet.
Grok 4.7 ist nicht einfach ein weiteres kleines Grok-Update.
Es verwendet ein neues, größeres Basismodell und legt deutlich mehr Gewicht auf langlaufendes Coding, agentenbasierte Arbeit, Selbstverifikation und professionelle Wissensaufgaben.
Im Vergleich zu Grok 4.6 zeigen die offiziellen Zahlen klare Verbesserungen über mehrere anspruchsvolle Benchmarks hinweg, während der Start-API-Preis unverändert bleibt.
Die spannendere Frage ist jetzt nicht mehr, ob Grok 4.7 auf dem Papier besser ist als Grok 4.6.
Es geht darum, wie viel von dieser Verbesserung in echten Projekten ankommt.
Für Entwickler, Forschende und Nutzer, die längere KI-Workflows aufsetzen, wird genau dort Grok 4.7 am Ende getestet.