
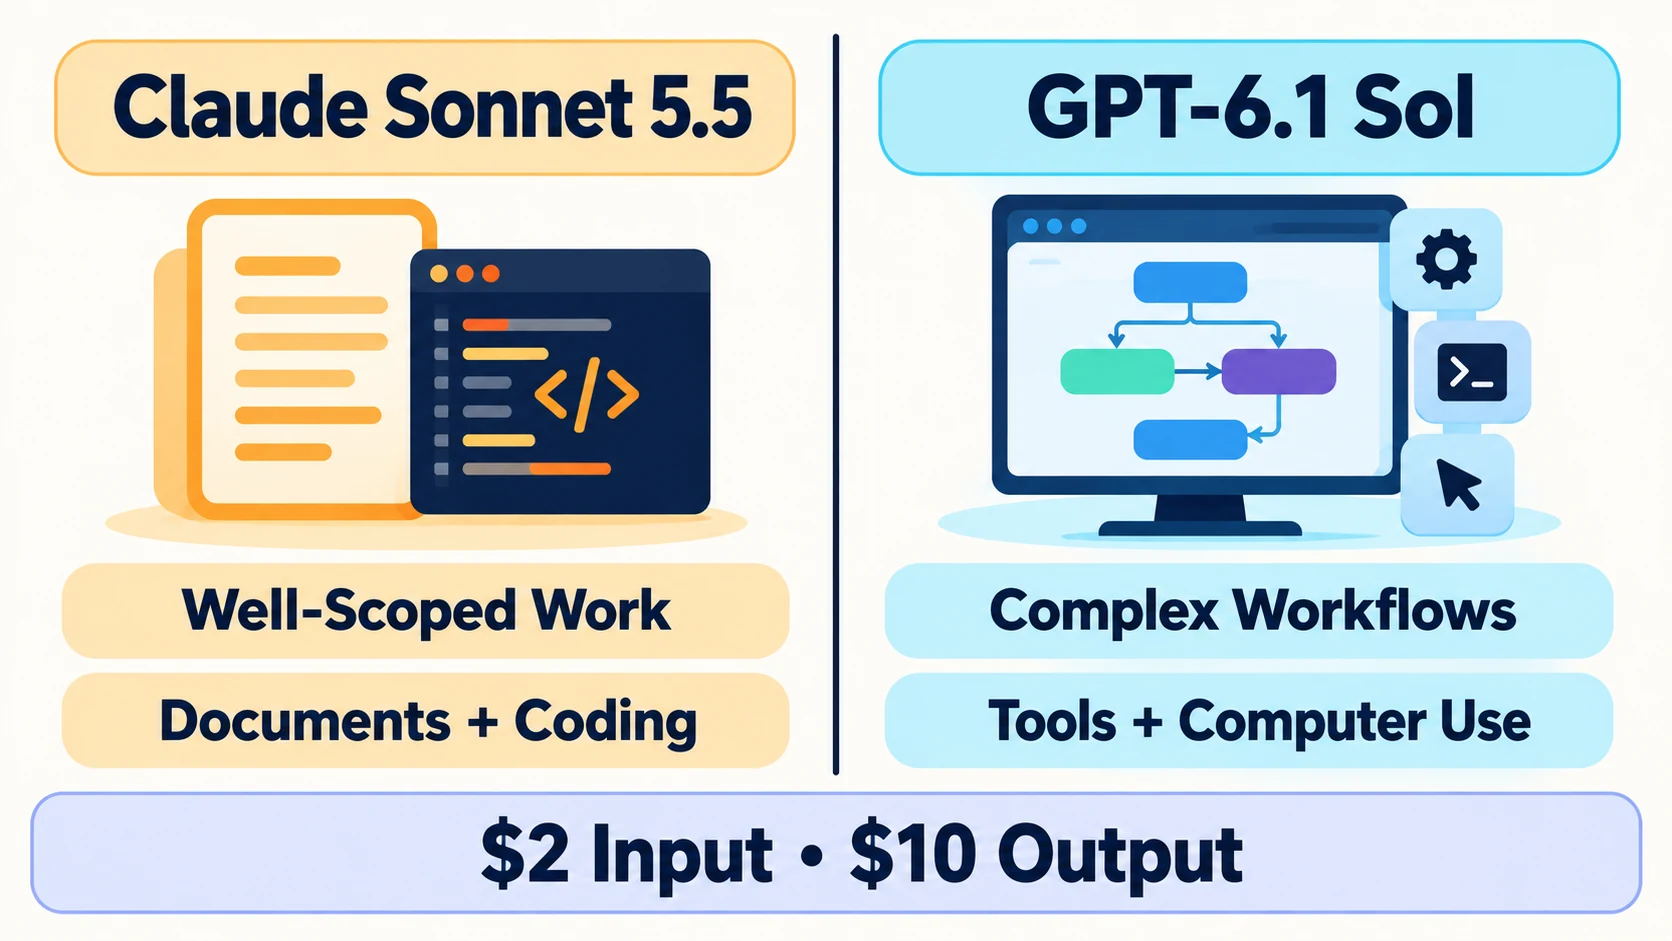
Claude Sonnet 5.5 e GPT-6.1 Sol têm os mesmos preços padrão de tokens de API, mas foram pensados para diferentes pontos fortes. Sonnet 5.5 está mais bem posicionada para codificação rápida e bem delimitada, além de tarefas profissionais. GPT-6.1 Sol mira em codificação complexa, uso de computador, trabalho orientado por ferramentas e fluxos de trabalho profissionais — oferecendo desempenho quase-Astra a um custo menor.
A escolha prática depende da tarefa. Sonnet 5.5 merece um teste para codificação limitada, documentos bem acabados, apresentações e planilhas. GPT-6.1 Sol é uma forte candidata quando você precisa de uma janela de contexto muito grande, das ferramentas da Responses API da OpenAI, ou de um fluxo de trabalho de múltiplas etapas. iWeaver oferece um teste gratuito do GPT-6.1 Sol, possibilitando testar o modelo nos seus próprios documentos e tarefas de pesquisa antes de escolher.
Claude Sonnet 5.5 vs GPT-6.1 Sol: visão geral
| Detalhe | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| Preço de entrada padrão | US$ 2 por 1M tokens | US$ 2 por 1M tokens |
| Preço de saída padrão | US$ 10 por 1M tokens | US$ 10 por 1M tokens |
| Preço de leitura de cache | US$ 0,20 por 1M tokens | US$ 0,10 por 1M tokens |
| Janela de contexto | Ver a plataforma Claude selecionada | 1.050.000 tokens |
| Saída máxima | Ver a plataforma Claude selecionada | 128.000 tokens |
| Foco declarado | Codificação bem delimitada e tarefas profissionais | Codificação complexa, uso de computador e trabalho profissional |
| Controle de raciocínio | Esforço ajustável | Baixo, médio, alto, xhigh e max |
| Nome do modelo da API | claude-sonnet-5-5 |
gpt-6.1-sol |
Os valores do GPT-6.1 Sol vêm da documentação de modelos da OpenAI. A precificação e o posicionamento do Sonnet 5.5 vêm do anúncio de lançamento da Anthropic. Preços de longo contexto, processamento em lote, modos rápidos, gravações em cache, chamadas de ferramenta e termos do provedor de nuvem podem alterar o custo final.
Codificação: o controle de escopo importa tanto quanto a capacidade “bruta”
A Anthropic posiciona o Sonnet 5.5 como um modelo rápido para tarefas profissionais do dia a dia, correções de bugs e tarefas com escopo claramente definido. Os materiais de lançamento destacam resultados fortes em codificação, incluindo 70,6% no Terminal-Bench 4.0 e 46,2% com esforço máximo no FrontierCode 1.1 Main.
GPT-6.1 Sol é posicionado para codificação complexa e trabalho agentico. A OpenAI também oferece acesso à execução de código, shell hospedado, aplicar patch, uso de computador e outras ferramentas via Responses API.
Esses fatos não estabelecem um vencedor universal. Uma avaliação de codificação deve usar a mesma issue do repositório, instruções, ambiente e orçamento de tempo. Verifique se o modelo encontrou a causa correta, alterou apenas os arquivos necessários, executou verificações apropriadas e parou quando a tarefa foi concluída.
Escolha Sonnet 5.5 para um teste quando a tarefa for limitada e a iteração rápida importar. Escolha GPT-6.1 Sol para um teste quando o trabalho exigir um contexto mais amplo do repositório, coordenação de ferramentas ou várias etapas de implementação e validação.
Documentos e trabalho com conhecimento
O Sonnet 5.5 é posicionado explicitamente para criar documentos, slides e planilhas bem acabados. A evidência de lançamento da Anthropic também enfatiza trabalho profissional com conhecimento e melhoria de eficiência em comparação com o Sonnet 5.
GPT-6.1 Sol oferece uma janela de contexto documentada de 1.050.000 tokens e até 128.000 tokens de saída. Isso torna uma opção interessante para grandes conjuntos de documentos, síntese de pesquisas, revisão de políticas e entregáveis estruturados e detalhados.
A capacidade de contexto, por si só, não prova a qualidade dos documentos. Teste ambos os modelos com o mesmo pacote de fontes e peça que extraíam figuras, reconciliem trechos conflitantes, distingam evidências de inferências e mostrem de onde veio cada conclusão. O modelo que gera um resultado mais auditável pode ser mais valioso do que aquele que escreve o rascunho inicial mais “suave”.
Ferramentas e adequação ao fluxo
A vantagem mais clara do GPT-6.1 Sol é a superfície de ferramentas documentada via Responses API. Ele suporta busca na web, busca em arquivos, geração de imagens, execução de código, shell hospedado, uso de computador, MCP e busca de ferramentas. Isso pode reduzir o atrito de integração para equipes que já estão construindo sobre a stack de agentes da OpenAI.
O Sonnet 5.5 está disponível por meio dos produtos da Claude, a Claude Platform, AWS, Google Cloud e Microsoft Azure. Ele pode se encaixar com mais naturalidade quando uma organização já usa esses ambientes ou tem prompts e avaliações ajustados para a Claude.
A plataforma em torno do modelo importa. Log, permissões, gestão de fontes, etapas de revisão, requisitos de dados e o fluxo de trabalho do time podem superar uma pequena diferença em um benchmark.
Leitores que quiserem a base anterior podem revisar o Claude Sonnet 5.5 vs GPT-6 comparison publicado pela iWeaver antes de avaliar o que a atualização 6.1 muda.
Custo: mesmo preço por token, custo de tarefa diferente
Ambos os modelos listam preços padrão de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de tokens de saída. Isso não significa que eles custem o mesmo para concluir uma tarefa.
O custo total da tarefa inclui tamanho do prompt, comportamento de cache, esforço de raciocínio, chamadas de ferramenta, tentativas, tamanho da saída e revisão humana. A Anthropic afirma que o Sonnet 5.5 pode usar menos tokens e rodar mais rápido do que o Sonnet 5, mas isso é uma comparação com seu antecessor — não uma prova de que seja mais barato do que o GPT-6.1 Sol.
Meça o custo total para chegar a um resultado aceitável. Um modelo que precise de menos correções pode ser mais barato mesmo se uma resposta individual for mais longa.
Qual modelo você deve escolher?
Experimente o Claude Sonnet 5.5 quando sua prioridade for codificação bem delimitada, iteração rápida ou documentos bem acabados e saídas no estilo de escritório. As evidências públicas mais fortes e o posicionamento do produto se alinham a essas tarefas.
Experimente o GPT-6.1 Sol quando você precisa de uma janela de contexto ampla, do ecossistema de ferramentas da OpenAI, de um trabalho complexo de múltiplas etapas ou de uma alternativa de menor custo para Astra. Ele também é a opção mais natural quando sua aplicação já depende da Responses API.
Para uma decisão justa, execute três tarefas representativas em vez de apenas um prompt genérico: uma tarefa rotineira, uma tarefa difícil e uma tarefa com muita fonte. Avalie correção, completude, latência, tokens totais, mudanças desnecessárias e tempo de revisão.
Você pode iniciar um teste gratuito do GPT-6.1 Sol na iWeaver e avaliá-lo com seus próprios documentos ou com seu fluxo de pesquisa. O melhor modelo é o que atende ao seu padrão de qualidade com o menor esforço total — não o que tem o título mais chamativo.