
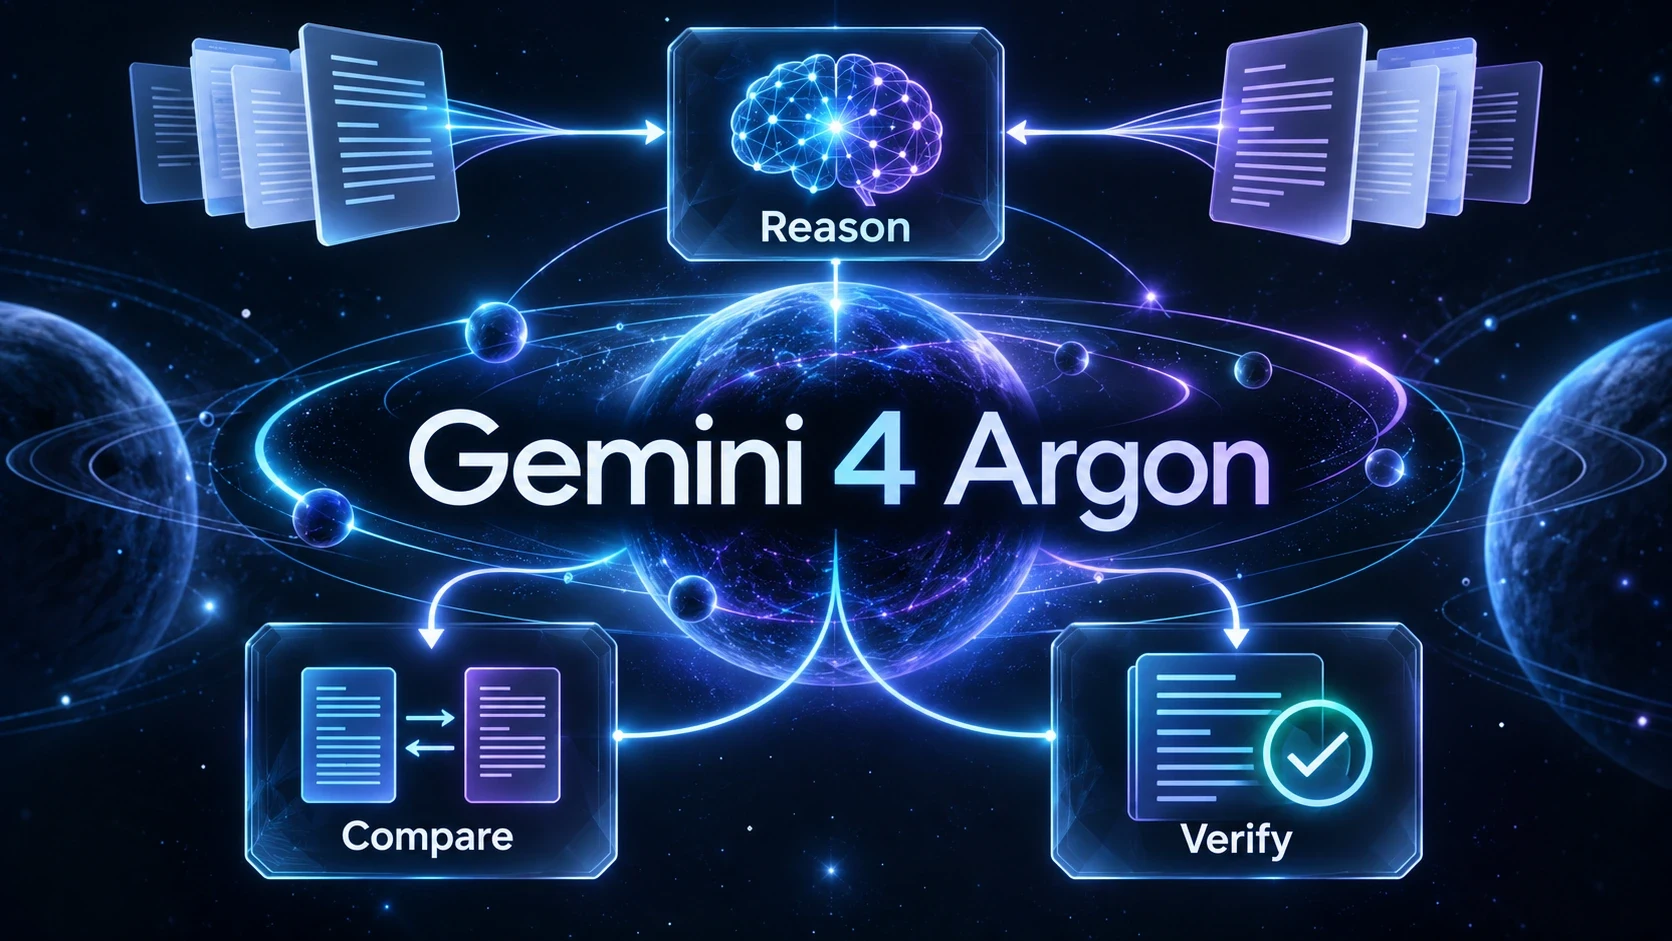
Gemini 4 Argon é o novo modelo de raciocínio flagship da Google, voltado para problemas difíceis que exigem trabalho contínuo em múltiplas etapas. Seu lançamento importa para quem precisa reconciliar documentos conflitantes, investigar um problema técnico ou desenvolver um argumento com base em evidências. A pergunta útil é se ele consegue concluir essas tarefas com menos correções da pessoa que revisa a resposta.
A Google inicialmente apresentou o Argon por meio de um lançamento restrito para parceiros confiáveis de cibersegurança. A Google anunciou o acesso no app Gemini para assinantes do Google AI Pro e Ultra. Artigos que descrevem o modelo como disponível apenas para testadores iniciais agora precisam dessa qualificação.
Por que o raciocínio sustentado importa
A Google posiciona o Argon para engenharia de software complexa, solução de problemas científicos e tarefas profissionais prolongadas. Esse posicionamento sugere um alvo de avaliação útil: trabalhos em que um erro inicial pode se propagar por várias decisões posteriores. Isso não estabelece que cada tarefa de resumo ou de escrita melhorará, nem que o modelo consegue trabalhar sem revisão.
Considere um briefing de pesquisa reunido a partir de três relatórios. Um relatório usa uma definição mais antiga, outro descreve uma população diferente e o terceiro resume ambos sem explicar a diferença. Uma resposta útil deve manter esses limites visíveis antes de fazer uma recomendação. Um parágrafo fluente que mistura os resultados falharia na tarefa mesmo que pareça convincente.
Essa é a oportunidade prática dos modelos de raciocínio: preservar a estrutura de um problema enquanto se trabalha em direção a uma resposta. Para avaliá-lo, peça para que os conflitos, evidências de suporte e informações ausentes sejam gerados como saídas separadas. Assim, uma falha fica mais fácil de identificar do que uma síntese única e bem polida.
O que as especificações publicadas realmente significam
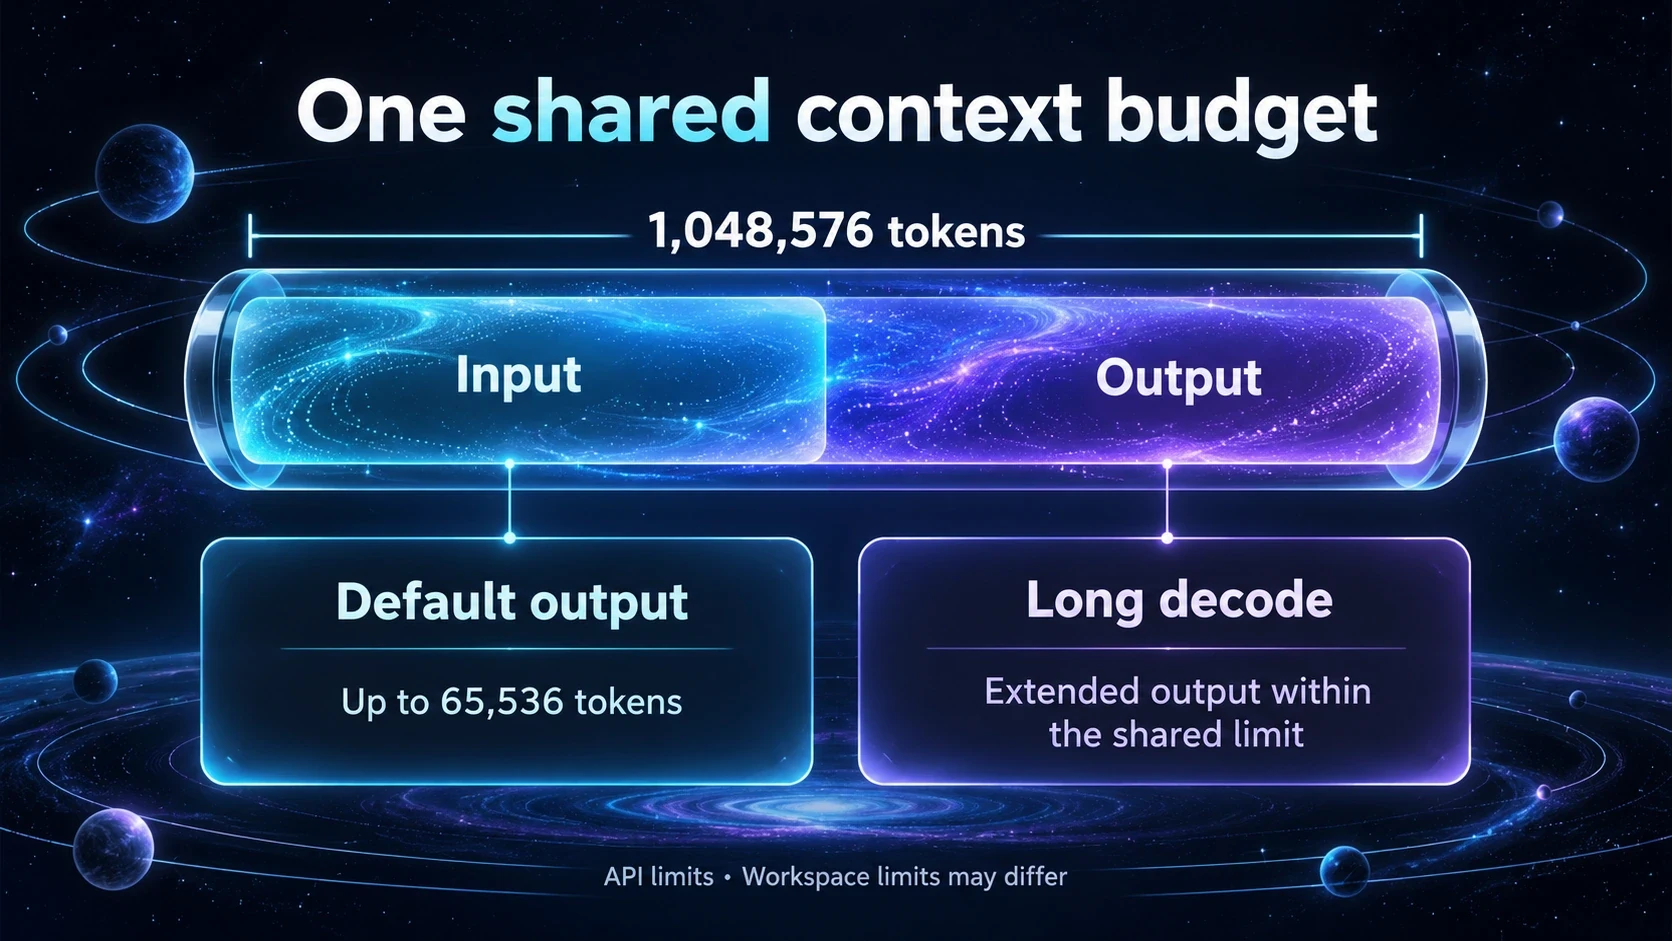
A documentação do modelo da Gemini API lista entradas de texto, imagem, vídeo, áudio e PDF, com saída de texto. Ela descreve uma janela unificada de contexto de entrada e saída de 1.048.576 tokens. A saída síncrona padrão é limitada a 65.536 tokens; a saída estendida, até o limite unificado, requer uma decodificação longa.
Essas são especificações da API. Um app ou uma interface de terceiros pode expor um conjunto diferente de capacidades, então o máximo publicado do modelo não deve ser tratado como uma promessa sobre qualquer ambiente específico. Além disso, suporte a entrada também não implica geração de imagem ou áudio: essas capacidades de saída não são listadas como suportadas para o Argon.
Para trabalhos com documentos, a distinção entre capacidade e utilidade importa mais do que o número de destaque. Uma janela maior te dá espaço para fornecer material, mas não decide qual versão é a autoridade. Identifique as fontes, informe datas e explique como a resposta deve lidar com contradições. Um pacote de fontes menor e bem organizado pode tornar o resultado mais fácil de auditar.
Três tarefas que valem como primeiro teste
Reconciliar fontes que discordam
Dê ao modelo um pequeno conjunto de relatórios com seções identificáveis. Peça quais afirmações concordam, quais entram em conflito e quais não podem ser comparadas porque suas definições são diferentes. Exija uma referência de fonte para cada descoberta e verifique algumas referências por conta própria. O teste é se a resposta preserva as distinções que você já sabe que existem.
Explicar um argumento difícil
Escolha um trecho que você entenda bem o suficiente para avaliar. Peça para listar as premissas do argumento, a conclusão e as suposições não declaradas e, em seguida, solicite uma explicação para um leitor menos técnico. Para um fluxo de trabalho focado em documentos, o PDF Explainer da iWeaver foi projetado para ajudar a destrinchar passagens difíceis, e não apenas para encurtá-las.
Montar um briefing de decisão
Forneça duas opções, critérios explícitos e evidências para cada uma. Peça ao modelo para recomendar uma opção, dizer qual evidência mudaria essa recomendação e sinalizar questões não respondidas. Isso testa se ele consegue raciocinar dentro das suas restrições em vez de inventar fatos para completar uma tabela atraente.
Se você está decidindo se deve trocar de um fluxo de trabalho Gemini existente, o nosso comparativo Gemini 4 Argon vs Gemini 3.8 Flash explica como comparar a dificuldade das tarefas, as necessidades de saída e o esforço de revisão.
Como ler benchmarks de lançamento
O anúncio da Google apresenta resultados de benchmark como evidência de progresso. Eles são sinais úteis, mas a fonte é o fornecedor do modelo, e as condições de avaliação importam. Este artigo não relata um benchmark independente e prático, nem afirma que o Argon é o melhor modelo para toda tarefa.
Antes de transformar um benchmark em uma decisão de compra ou de fluxo de trabalho, identifique a tarefa, a configuração da ferramenta e os critérios de sucesso. Depois, compare com o seu próprio trabalho. Um benchmark de código não consegue estabelecer a precisão de uma revisão da literatura; uma resposta longa não consegue estabelecer que as referências estão corretas.
Leve o modelo para um fluxo de trabalho repetível
O Gemini 4 Argon agora está disponível na iWeaver, e a iWeaver oferece um teste gratuito do modelo. Selecione-o no workspace e use uma tarefa real com um padrão de aceitação claro. Siga nosso guia para usar o Gemini 4 Argon para um fluxo de trabalho baseado em fontes e um prompt que você pode adaptar.
O uso inicial mais forte é uma tarefa baseada em fontes que você consegue verificar. Prepare as evidências, defina a saída desejada, inspecione o resultado e mantenha as correções para a próxima execução. O lançamento do Argon te dá um novo candidato para trabalhos difíceis. A decisão de continuar usando isso deve depender do que ele acerta nesse fluxo de trabalho.