
Kimi K3.1 Pro apresenta taxas base de entrada e saída de API listadas mais baixas do que as do Claude Opus 5.5. Se ele é a melhor escolha depende da tarefa: o número de tentativas, correções e revisões humanas pode importar mais do que a taxa por token.
Ambos os modelos estão sendo posicionados para codificação complexa e trabalhos de conhecimento. Esta comparação usa documentação oficial e resultados publicados pelos fornecedores, e não um teste independente mão na massa. O objetivo é ajudar você a escolher uma avaliação útil e, então, tomar uma decisão com base no que ela produz.
Preços de API: compare o mesmo tipo de uso
Para o contexto de lançamento por trás desta comparação, veja as novas capacidades do Kimi K3.1 Pro.
As taxas em dólares americanos a seguir foram verificadas em 24 de outubro de 2026:
| Por milhão de tokens | Kimi K3.1 Pro | Claude Opus 5.5 |
|---|---|---|
| Entrada base | US$ 2 | US$ 4 |
| Saída base | US$ 10 | US$ 20 |
| Cache hit/leitura | US$ 0,20 | US$ 0,20 |
Estas são taxas de API. Assinaturas para consumidores, serviços de terceiros e modos acelerados têm condições separadas.
Considere uma solicitação hipotética com 100.000 tokens de entrada sem cache e 10.000 tokens de saída. Nessas taxas base, a entrada e a saída custariam US$ 0,30 com o K3.1 Pro e US$ 0,60 com o Opus 5.5. Esse cálculo exclui gravações de cache, ferramentas, novas tentativas e outras cobranças. Ele ilustra a diferença de taxa; não é um custo de tarefa medido.
Para tarefas repetidas, registre a conta completa e o tempo necessário para chegar a um resultado aceito. Uma solicitação mais barata pode se tornar um fluxo de trabalho mais caro se exigir correções extensas. Uma solicitação mais cara precisa justificar o preço pelo resultado que entrega.
Codificação: vá além de uma pontuação de benchmark próxima
O relatório de lançamento da Kimi coloca o K3.1 Pro bem próximo do Opus 5.5 no Terminal-Bench 4.0. Esses resultados são evidência sobre uma configuração específica de avaliação, e não uma garantia sobre o seu repositório.
Para uma comparação de codificação útil, escolha uma tarefa com falha conhecida e um teste de aceitação claro. Dê a cada modelo o mesmo estado do projeto, descrição do problema, acesso a ferramentas e orçamento de tempo. Mantenha cópias separadas para que uma execução não possa se beneficiar das mudanças da outra.
Inspecione três coisas após cada execução: se o problema foi resolvido, se houve mudança em um comportamento não relacionado e se a explicação corresponde à modificação real. Registre qualquer intervenção manual. Se um modelo precisar de uma dica no meio do caminho, essa intervenção deve fazer parte do resultado.
Um pequeno reparo de interface e um teste de refatoração em vários arquivos avaliam capacidades diferentes. Inclua ambos apenas se os dois representarem sua carga de trabalho. Um único demo bem-sucedido é uma base estreita para mover um fluxo de engenharia inteiro.
Análise de documentos: teste se as conclusões resistem à verificação
Para trabalho de pesquisa, a comparação deve incluir uma pergunta que não possa ser respondida resumindo um único documento. Use uma coleção de fontes com um dado desatualizado, uma afirmação qualificada ou uma aparente discordância.
Tente o mesmo prompt com ambos os modelos:
Compare os relatórios fornecidos. Identifique afirmações que concordam, afirmações que entram em conflito e afirmações que não podem ser reconciliadas com as evidências disponíveis. Cite a fonte e a localização de cada uma. Separe os fatos reportados da sua interpretação.
Revise as respostas sem olhar primeiro as etiquetas do modelo. Conte as afirmações sem suporte e as qualificações perdidas. Verifique se algum dos modelos resolve uma discordância inventando uma explicação.
Se você usar o iWeaver para preparar a coleção de fontes, o AI Document Summarizer pode ajudar a estabelecer uma visão geral. Mantenha consistentes as entradas reais da comparação; dar a um modelo um resumo curado e ao outro arquivos brutos cria um experimento diferente.
Quando você deve avaliar o K3.1 Pro primeiro?
Use Como usar o Kimi K3.1 Pro para configurar uma primeira tarefa e verificar o resultado.
Comece com o K3.1 Pro quando as taxas de API listadas mais baixas atendem a uma restrição real de custo e você tem uma tarefa repetível para testar. Ele também é um candidato razoável quando o foco em codificação e pesquisa do novo lançamento corresponde ao trabalho que você precisa fazer.
O Kimi K3.1 Pro está disponível no iWeaver, e o iWeaver oferece um teste grátis do modelo. Uma tarefa limitada em documentos é uma avaliação inicial prática: escolha fontes que você entende, especifique a saída e verifique as afirmações consequentes.
As condições do teste não estabelecem o custo de usar a API do Kimi. Avalie cada rota de acesso em seus próprios termos.
Quando você deve manter o Opus 5.5 na comparação?
Antes de pagar por saída acelerada, revise Kimi K3.1 Pro vs. Highspeed para separar velocidade da qualidade da tarefa.
Mantenha o Opus na avaliação quando você já tiver um fluxo de trabalho que funciona bem com ele. Um processo estabelecido tem valor: prompts, ferramentas, hábitos de revisão e saídas aceitas levam tempo para serem reconstruídos.
Execute o K3.1 Pro em uma amostra representativa antes de mudar. Inclua uma tarefa comum, uma tarefa difícil e um caso em que seu fluxo de trabalho atual lida mal. Um modelo novo é mais útil quando resolve um problema concreto ou reduz o custo de um resultado aceito.
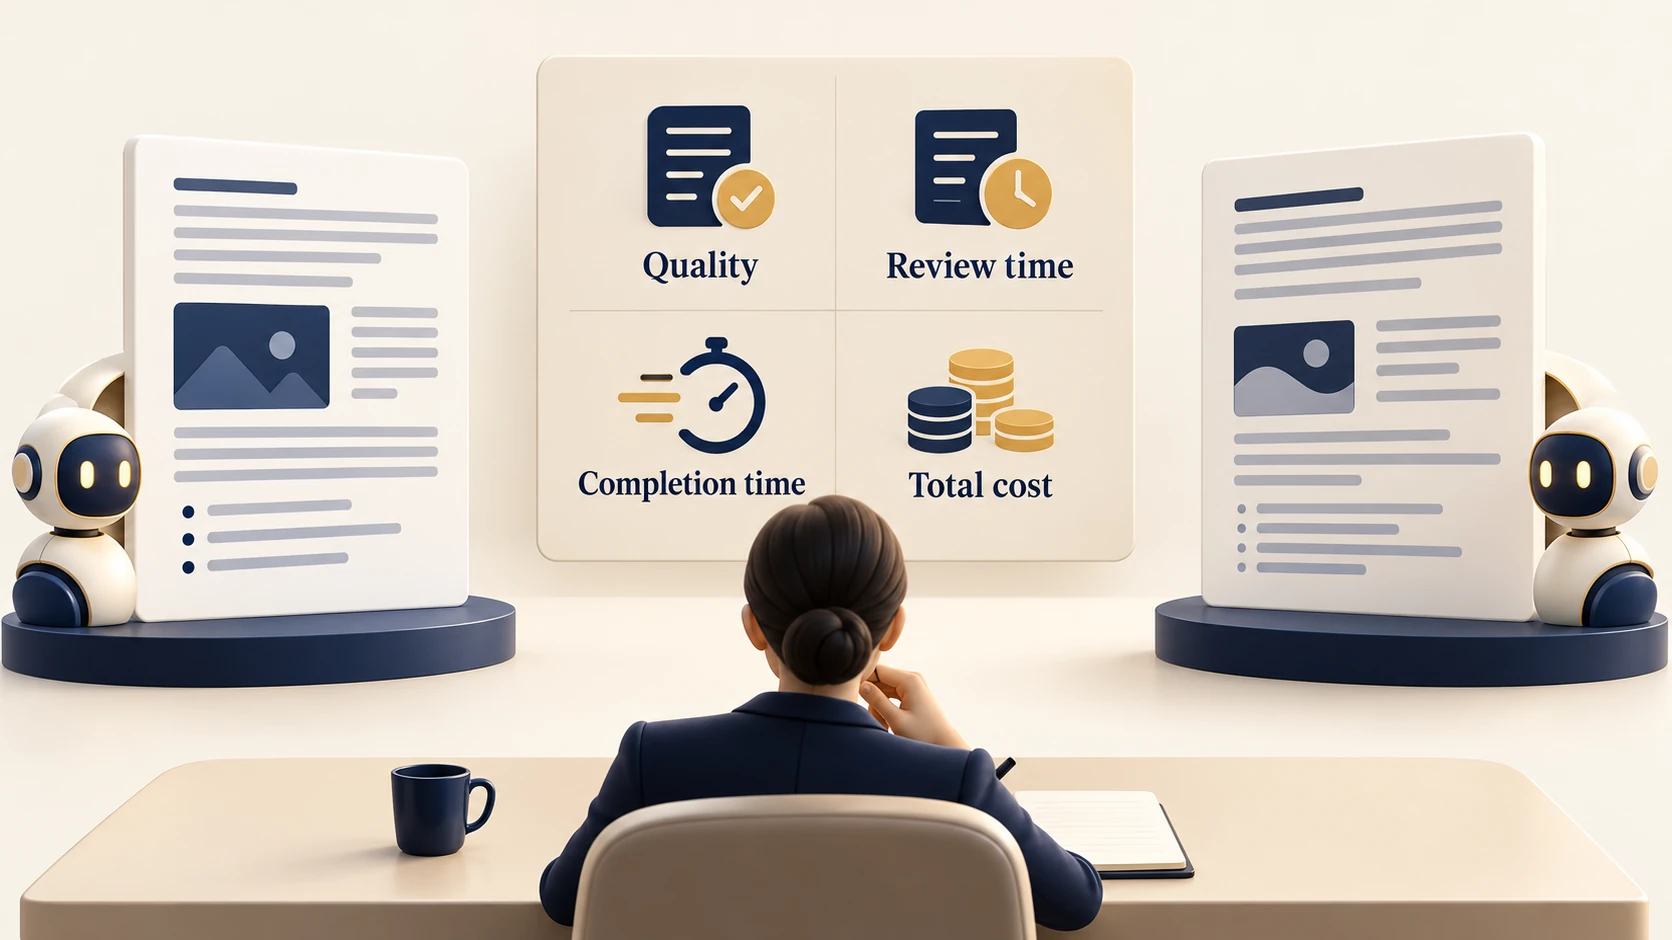
Para uma escolha final, use uma ficha de pontuação simples: saída aceita, tempo de correção, tempo de conclusão e custo total. Atribua pesos a esses fatores de acordo com o trabalho. Uma equipe de pesquisa pode colocar a qualidade das evidências em primeiro lugar; um sistema de processamento em lote pode se preocupar mais com o custo depois que um limite mínimo de qualidade for atingido.
Não há necessidade de declarar um modelo como vencedor em todas as tarefas. Escolha o K3.1 Pro quando ele entrega um resultado melhor para suas restrições, e mantenha o Opus quando a sua avaliação apoiar mantê-lo.