
A Kimi posiciona a K3.1 Pro Highspeed como a versão mais rápida da K3.1 Pro, com as mesmas capacidades do modelo. As taxas base de entrada e saída de API listadas são o dobro das da versão regular. A decisão é se a saída mais rápida elimina tempo de espera suficiente do seu fluxo de trabalho para justificar essa diferença.
Para um lote sem supervisão, o modelo regular é um ponto de partida sensato. Para um trabalho interativo com muitas revisões, a Highspeed merece uma comparação cronometrada. Meça a tarefa completa, incluindo ferramentas e revisão, antes de decidir.
O que as duas versões mudam
Para o contexto de lançamento mais amplo, veja As capacidades e disponibilidade da Kimi K3.1 Pro.
| Fator | K3.1 Pro | K3.1 Pro Highspeed |
|---|---|---|
| Posicionamento do fornecedor | Versão regular | Mesmas capacidades, saída mais rápida |
| Velocidade de saída anunciada | Referência | Aproximadamente 2–3× a referência |
| Entrada base de API por milhão de tokens | US$ 2 | US$ 4 |
| Saída base de API por milhão de tokens | US$ 10 | US$ 20 |
Velocidade é uma alegação do fornecedor, não uma medição feita por este artigo. As taxas de API e as permissões do quota do Coding Plan são mecanismos de faturamento diferentes.
Uma variante mais rápida não deve ser descrita como uma atualização separada de inteligência. Avalie o valor pela responsividade e pelo trabalho concluído. Você ainda deve verificar o conteúdo das respostas das duas versões.
Um exemplo simples de custo
Suponha que uma solicitação use 50.000 tokens de entrada sem cache e 5.000 tokens de saída. Pelas taxas base listadas, entrada mais saída custariam:
- K3.1 Pro: US$ 0,10 de entrada mais US$ 0,05 de saída, totalizando US$ 0,15.
- Highspeed: US$ 0,20 de entrada mais US$ 0,10 de saída, totalizando US$ 0,30.
Isso é um cálculo hipotético. Ele exclui gravações de cache, ferramentas, tentativas (retries) e outras cobranças. Ele também pressupõe contagens iguais de tokens, algo que uma avaliação real deve medir em vez de presumir.
Os US$ 0,15 extras podem valer a pena se economizarem um tempo significativo durante uma tarefa. Podem agregar pouco valor se você estiver enviando trabalho durante a noite e devolvendo na manhã seguinte. A mesma diferença de taxa pode levar a decisões diferentes dependendo de quando uma pessoa precisa da resposta.
Saída mais rápida não significa que cada tarefa termine três vezes antes
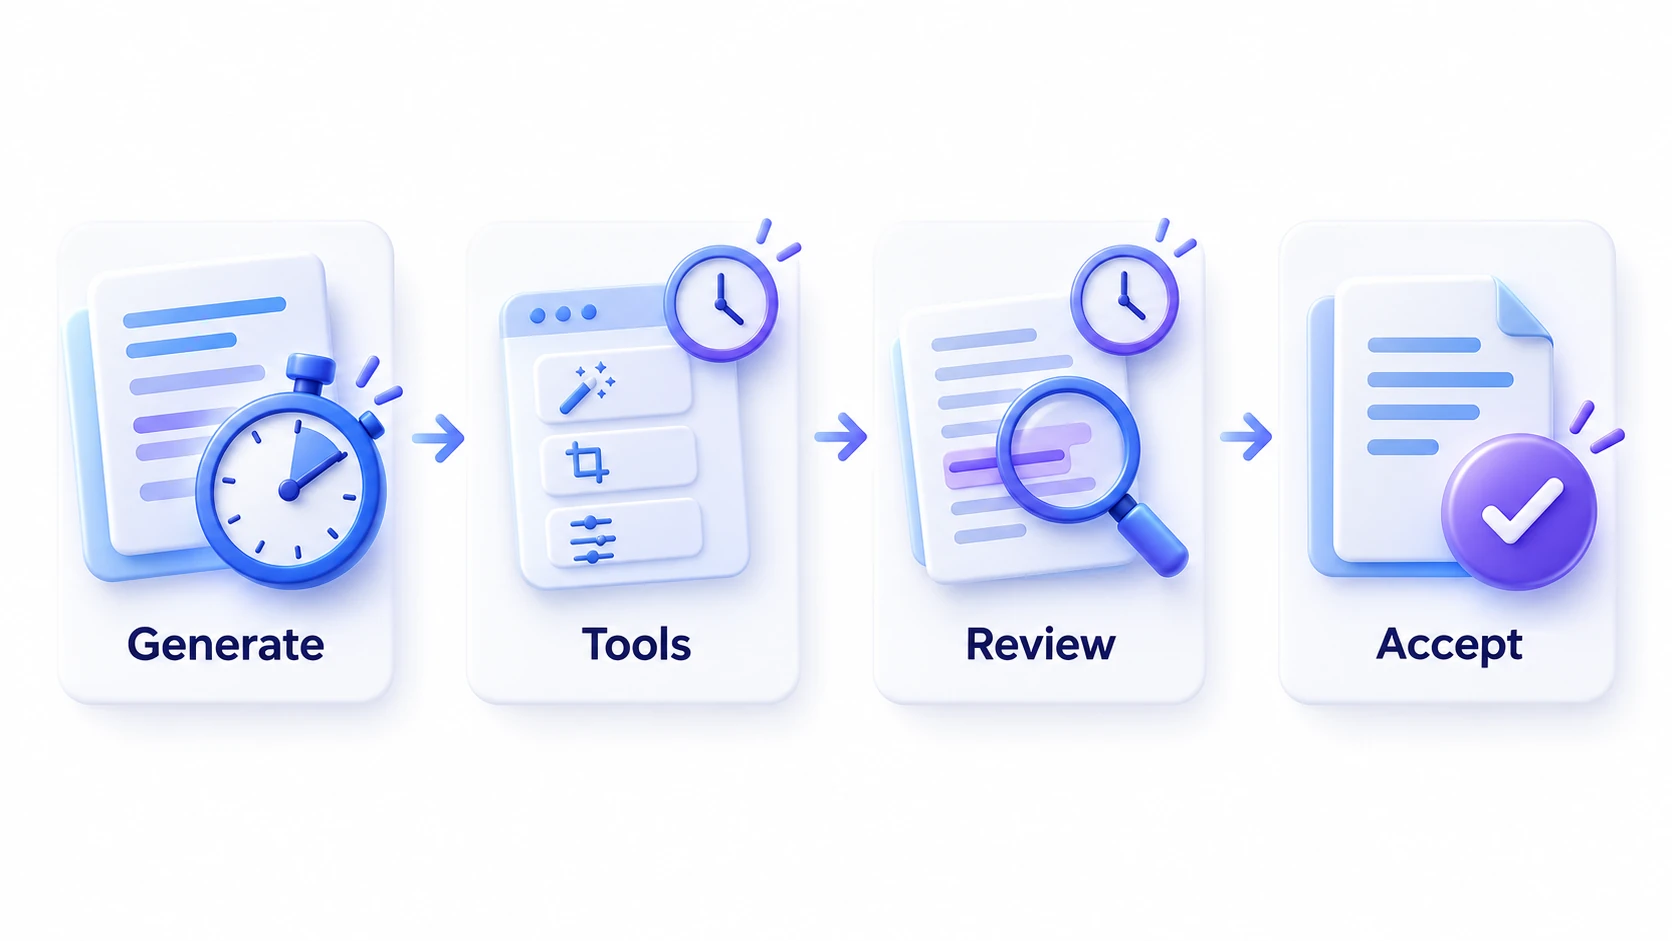
Uma tarefa com apoio de ferramentas pode incluir vários tipos de espera: geração do modelo, recuperação de documentos, execução de código, serviços externos e revisão humana. A alegação de velocidade de saída da Highspeed não estabelece uma redução equivalente em toda a sequência.
Considere uma tarefa ilustrativa que leva dez minutos, com seis minutos gastos gerando a saída do modelo e quatro minutos gastos em outras coisas. Mesmo que a geração ficasse três vezes mais rápida, o total se tornaria seis minutos: dois minutos de geração mais os quatro minutos que permanecem inalterados. Isso é uma economia útil, mas não é uma redução de três vezes no tempo total.
Este exemplo é um cálculo, não um resultado observado da Kimi. Ele serve para identificar o que você deve cronometrar no seu próprio fluxo de trabalho.
Se a maior parte do atraso vem de executar uma bateria de testes longa ou de esperar por um serviço de busca, resolva esse gargalo antes de presumir que um endpoint de modelo mais rápido vai resolver.
Quando a Highspeed vale a pena testar
Para uma comparação entre famílias de modelos, leia Kimi K3.1 Pro vs. Claude Opus 5.5.
A Highspeed é mais relevante quando você está presente e repetidamente precisa esperar o modelo para continuar. Exemplos incluem revisar uma explicação, trabalhar em várias opções de implementação ou refinar uma seção de documento, passo a passo.
Execute a mesma tarefa representativa nos dois variantes. Registre quando você a envia, quando a resposta útil fica disponível e quando você aceita o resultado final. Conte as revisões e inclua qualquer tempo gasto corrigindo erros.
Repita com mais de uma tarefa. Uma resposta curta pode parecer semelhante nas duas versões, enquanto uma resposta longa pode revelar uma diferença maior. Avalie a economia em relação ao custo extra real pelo serviço que você escolheu.
Quando a versão regular é suficiente
Se você ainda está migrando do modelo mais antigo, comece com Kimi K3.1 Pro vs. Kimi K3.
Comece com a K3.1 Pro regular quando você puder esperar pela conclusão sem interromper outros trabalhos. Exemplos incluem uma revisão de documento em fila, um resumo de pesquisa agendado ou um experimento em que a qualidade da resposta é a principal questão.
Também prefira um ponto de partida mais simples quando ainda não aprendeu como enquadrar a tarefa. A geração mais rápida não resolve um pedido ambíguo nem a falta de material de referência. Melhore as instruções, verifique as evidências e então decida se a responsividade ainda é um problema.
A Kimi K3.1 Pro está disponível no iWeaver, e o iWeaver oferece um teste gratuito do modelo. Essa afirmação não comprova a disponibilidade da Highspeed nem os termos do teste. Verifique a lista de modelos do serviço e a oferta atual antes de planejar em torno de uma variante específica.
Para trabalho com documentos, o AI Document Summarizer pode ajudar a criar uma visão inicial clara. Use essa visão para estreitar a pergunta que você quer que o modelo responda.
Use uma regra prática de ponto de equilíbrio
Para sua própria avaliação, compare o custo adicional com o valor do tempo que você realmente economiza. Um cálculo útil é:
Custo adicional do modelo ÷ minutos de espera ativa economizados = custo por minuto economizado.
Mantenha a qualidade como um requisito mínimo. Uma resposta que chega antes, mas exige mais tempo para corrigir, não necessariamente economizou tempo.
Escolha a Highspeed quando a redução medida na espera melhorar a forma como você trabalha e couber no seu orçamento. Mantenha a K3.1 Pro regular quando cumprir o prazo a um custo menor. Reavalie a escolha se a sua combinação de tarefas, os termos de acesso ou os preços mudarem.