“照片总结”可能意味着完全不同的事情。
一名学生可能想要对拍摄到的教科书页面进行总结。产品经理可能需要从仪表盘截图中提炼关键信息。开发者可能希望获得一个 API,用于在数千张图片中检测文字、物体和标签。
这些并不是同一种任务。
因此,最好的 AI 照片总结工具取决于:你到底需要可读的自然语言摘要、OCR、视觉推理,还是结构化的计算机视觉输出。
本 2026 对比将这些使用场景区分开来,方便你选择合适的工具。
快速对比
| 工具 | 最适合 | 它能提取什么 | 最合适的用户类型 |
|---|---|---|---|
| iWeaver | 结构化图像摘要 | 文本、视觉语境、图表、笔记 | 知识工作者与学生 |
| ChatGPT | 对话式图像分析 | 文本、物体、图表、截图 | 普通用户 |
| Gemini | 图像问答与视觉理解 | 照片、文本、视觉语境 | 普通用户 |
| Adobe Acrobat AI Assistant | 扫描文档和 PDF 图片 | OCR 加文档级语境 | 偏 PDF 的用户 |
| Google Cloud Vision | OCR 和机器视觉 API | 文本、标签、物体、地标 | 开发者 |
| Azure AI Vision | OCR、说明文字、图像分析 | 文本、说明文字、物体 | 开发者与企业 |
| Amazon Rekognition | 大规模图像检测 | 标签、物体、文字、审核信号 | 开发者与 AWS 团队 |
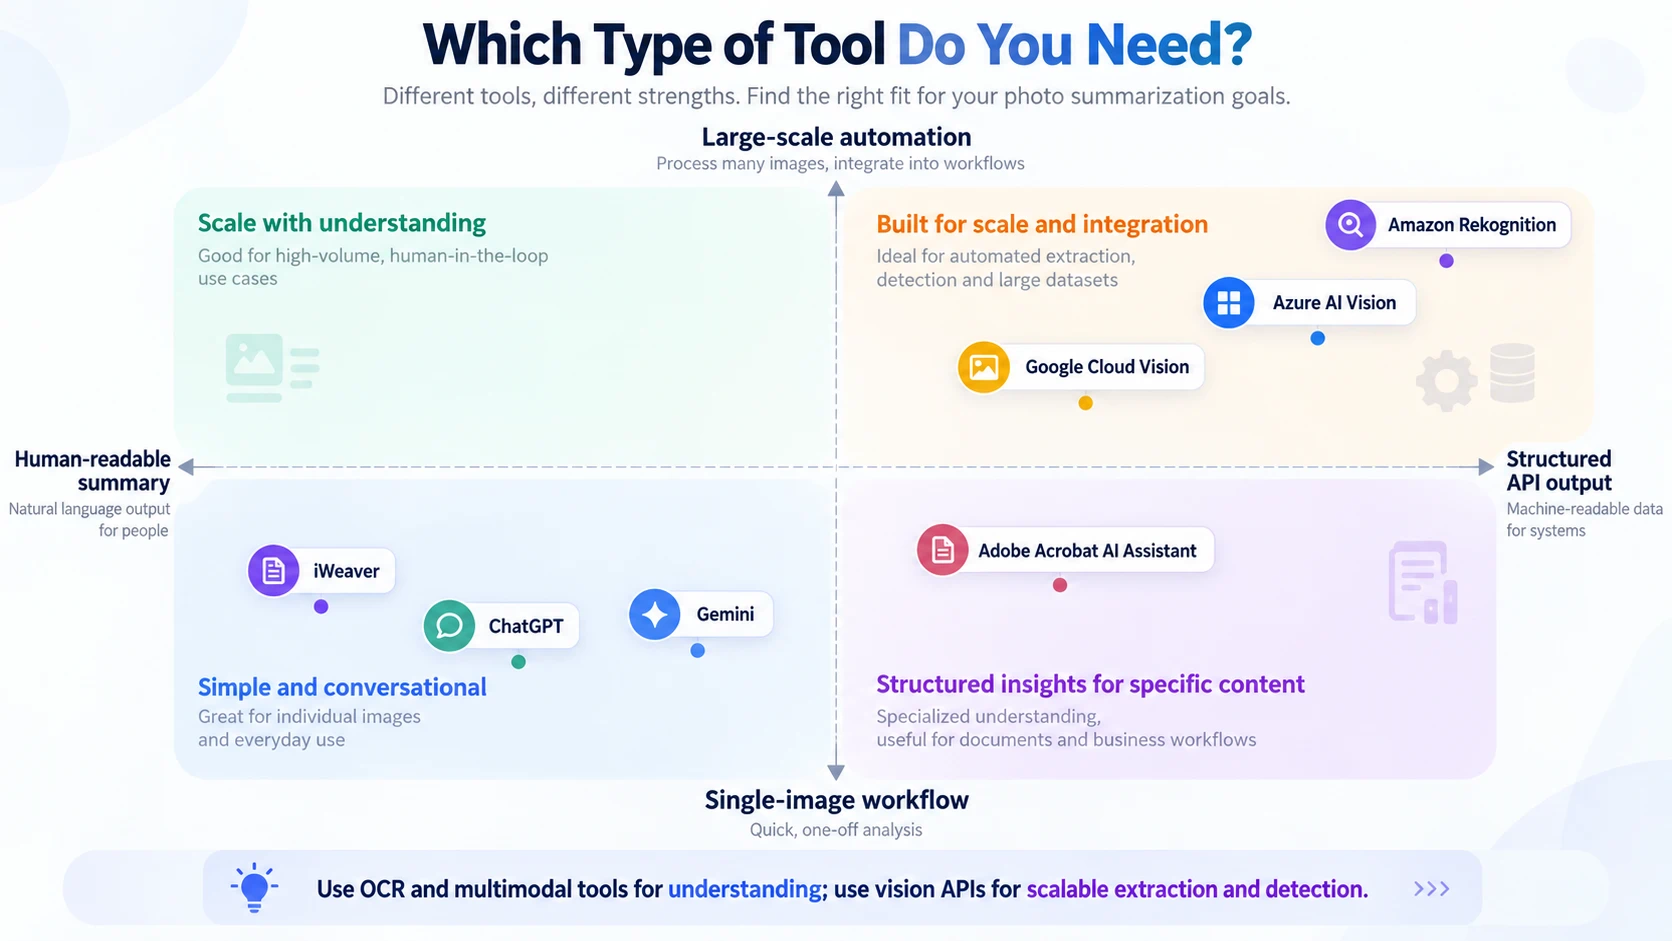
1. iWeaver — 最适合结构化图像摘要
iWeaver 的 AI Image Summarizer 面向的是想要理解一张图片的人,而不仅仅是识别图片里有什么。
你可以用它来处理:
- 截图
- 图表
- 视觉笔记
- 扫描页面
- 信息图
- 演示幻灯片
- 含有文字的图片
最有用的区别在于输出结构。该工具不会只返回 OCR 文本或标签;它可以把图片转化为要点、解释、笔记或后续追问的回答。
这使它特别适用于研究、学习、业务复盘以及知识工作流。
选择它当: 你希望获得一个人类可读、可继续加工的摘要。
2. ChatGPT — 最适合对话式图像分析
ChatGPT 可以分析上传的图片,并回答关于可见内容的问题。
当最初的摘要引出更多问题时,这尤其有用。
例如:
用五条要点总结这个仪表盘。
接着:
哪个指标变化最大?
然后:
把这些发现整理成一份发给我团队的简短更新。
同样的方法也适用于图表、截图、拍摄的文档以及许多其他视觉输入。
它的优势在于灵活性,而不是固定的“照片总结”格式。
对于高风险细节,请用原始图片核对数字、标签和小字。
选择它当: 你想以互动方式讨论一张图片,并将结果转化为另一种输出。
3. Gemini — 最适合通用图像问答
Gemini 支持上传图片,并能回答关于照片与视觉内容的问题。
用于日常场景时,它适合完成诸如:
- 解释截图展示了什么
- 从图片中读取文字
- 总结一张拍摄页面
- 识别可见元素
- 比较多个视觉细节
Google 的视觉生态也受益于它在 Lens 和图像理解方面长期积累的经验。
和任何多模态助手一样,一个好的提示应当把“观察”和“解释”分开。
可以尝试:
先列出所有肉眼可见的内容。再总结主要信息。标记任何你看不清的文字。
选择它当: 你需要一个通用型视觉助手来做快速分析。
4. Adobe Acrobat AI Assistant — 最适合扫描文档
“照片”很多时候其实是把文档页面拍成了图片。
如果你的输入是扫描版 PDF、报告、合同或归档文档,Adobe Acrobat AI Assistant 可能比通用照片分析器更适合。
其工作流结合 OCR 与文档语境,让用户无需把文件拆成单独图片,就能从扫描文本直接得到摘要与问题。
当页面顺序和文档结构很重要时,这一点尤为有用。
选择它当: 你的图片主要是 PDF 内的页面。
5. Google Cloud Vision — 最适合 OCR 和图像 API
Google Cloud Vision 并不是面向消费者的摘要生成工具。它是为开发者提供的计算机视觉服务。
它可以检测印刷体或手写体文字,并返回关于图片的结构化信息,包括标签以及其他视觉信号。
因此,当你需要搭建自己的总结流程时,它很有用。
一个典型流程是:
图片 → Cloud Vision OCR/标签 → 结构化数据 → 语言模型 → 最终摘要
这让开发者能够控制提取、存储、置信度校验以及后续处理。
尤其适用于大规模自动化场景:在这种情况下,人工上传型工具并不实用。
选择它当: 你正在通过 API 构建一款需要图像理解能力的应用。
6. Azure AI Vision — 最适合企业级计算机视觉
Azure AI Vision 为面向 Microsoft 的开发环境提供 OCR 和图像分析能力。
根据所使用的服务与模型不同,它可以提取文本、识别视觉元素,并生成可传入更大型 AI 工作流的描述性信息。
对于企业团队而言,主要价值在于集成。图像分析可以成为更广泛的 Azure 架构中的一个组成部分,涉及存储、搜索、自动化与语言模型。
它的体验并不等同于上传一张截图然后得到一份打磨精良的研究型摘要。
选择它当: 你的组织正把图像处理构建进一个基于 Azure 的系统。
7. Amazon Rekognition — 最适合基于 AWS 的图像检测工作流
Amazon Rekognition 也是另一种面向开发者的选项。
它可以在图片中检测标签、物体、文字以及其他视觉信号。已经在使用 AWS 的团队可以将这种结构化输出接入数据库、审核系统、搜索流程或语言模型。
对于“总结”,Rekognition 通常更像是感知层,而不是最终写作层。
这种区别很关键。计算机视觉 API 可能告诉你图片里有“人、骑自行车的人/自行车、道路以及文字”。多模态语言工具更适合把这些观察转化为自然语言解释。
选择它当: 你需要在 AWS 工作流中进行可扩展的图像分析。
图像总结工具 vs. OCR 工具:有什么区别?
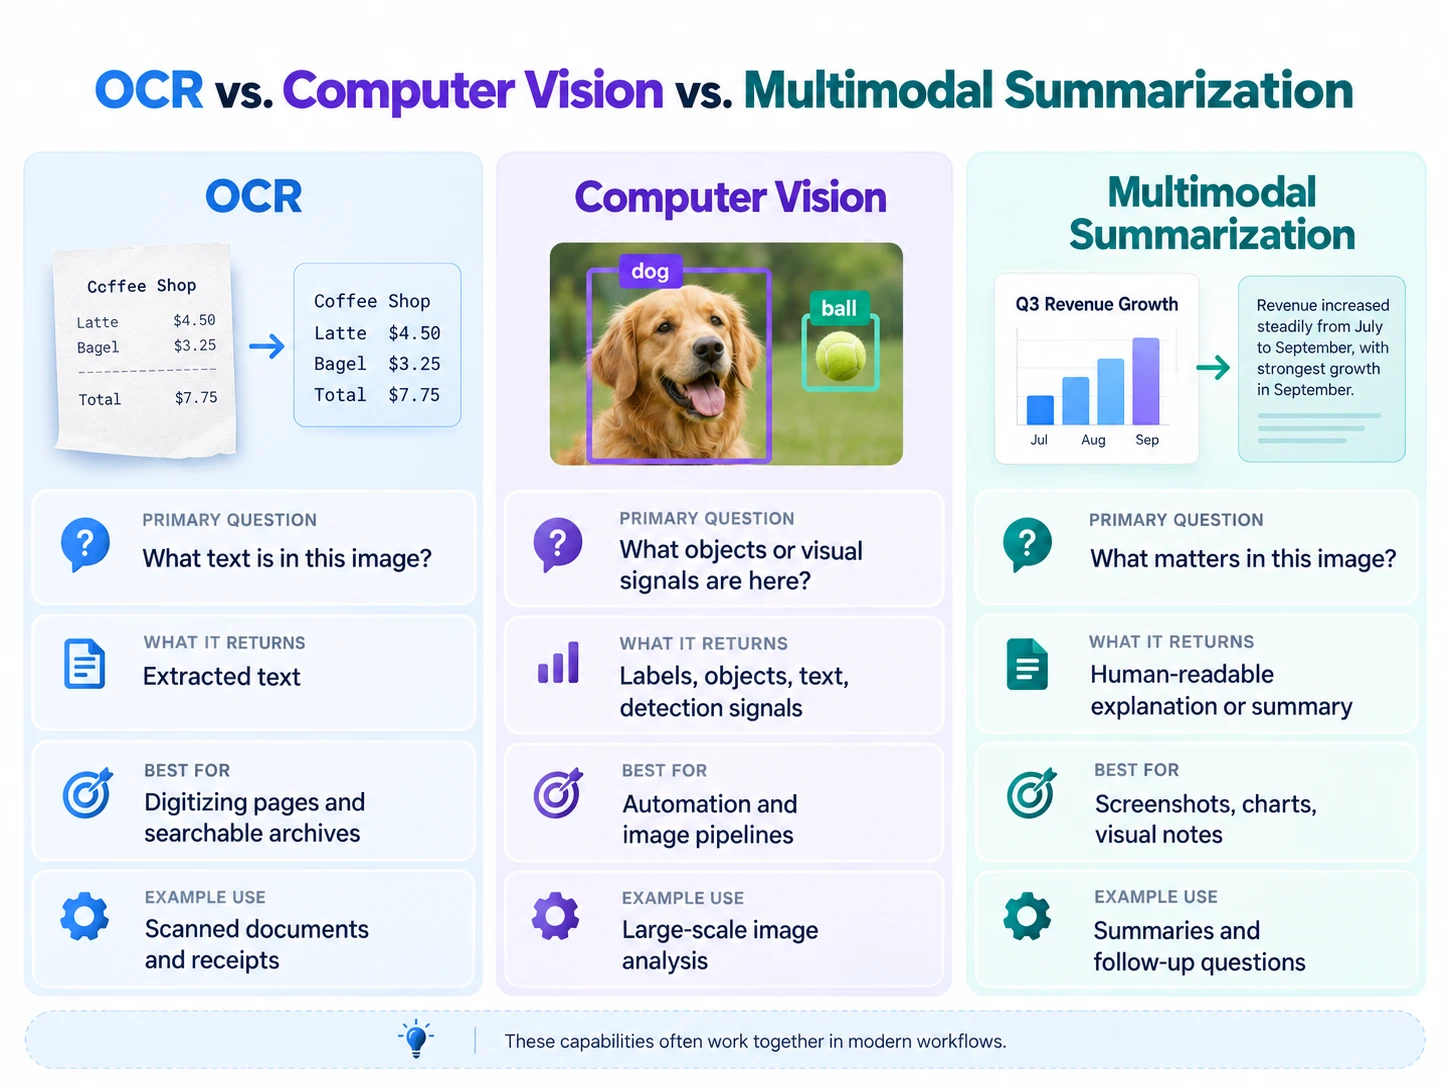
OCR 回答:
这张图片里有哪些文字?
图像总结工具回答:
这张图片中什么是重要的?
多模态助手还能更进一步:
在我的问题语境下,这张图片意味着什么?
这些能力有重叠,但并不完全相同。
如果你只是想把印刷文本数字化,OCR 可能就足够了。如果你需要对截图、图表或视觉笔记给出简明解释,请使用同时理解文字与版式的工具。
要查看逐步工作流,请参见 如何从图片总结文字。
如何选择合适的工具
问四个问题。
1. 重要信息主要是文字吗?
如果是,请优先考虑 OCR 的质量。
对于手写材料,请使用专门的 AI 手写识别 工作流,或其他为手写设计的 OCR 工具。
2. 版式重要吗?
对于图表、仪表盘、幻灯片集和信息图,仅靠文字提取是不够的。
选择能推理位置、标签、图例以及视觉关系的多模态工具。
3. 你只需要一张图片,还是成千上万张?
用于偶尔的人工分析,面向用户的摘要工具更简单。
当你面对成千上万或数百万张图片时,像 Google Cloud Vision、Azure AI Vision 或 Amazon Rekognition 这样的 API 更合适。
4. 摘要之后你还需要什么?
如果你想追问后续问题、比较图片、生成笔记,或把发现整理成另一份文档,请选择支持对话式工作流的工具。
如果你只需要为软件系统提供结构化标签,API 可能就够了。
提升照片摘要效果的提示示例
针对仪表盘:
用五条要点总结仪表盘。保留可见的日期范围和精确的指标数值。把观察结果与可能的解释分开。
针对扫描页面:
提取文字,然后总结主要论点。保持专有名词、日期和引文不变。看不清的文字要标记出来,而不是凭猜测。
针对图表:
解释坐标轴、各组内容、趋势、最高与最低数值,以及任何可见的异常。不要从相关性推断因果关系。
针对一组截图:
先分别总结每张截图。然后识别所有图片中反复出现的问题、差异,以及最重要的三条结论。
具体的提示能降低工具把注意力放在“视觉上显而易见但不重要”的细节上的概率。
隐私很重要
上传图片之前,先检查它还包含了什么。
截图可能会暴露姓名、电子邮件地址、内部仪表盘、客户信息、账号号码,或私密消息。
对与任务无关的信息进行裁剪或打码,并遵循你组织对机密图片的已批准数据处理政策。
最好的 AI 照片总结工具取决于你的工作。
当你想要可读的解释与后续追问时,选择 iWeaver、ChatGPT 或 Gemini。当这些“照片”其实是扫描文档时,使用 Adobe。当你正在把图像理解能力集成到软件中时,选择 Google Cloud Vision、Azure AI Vision 或 Amazon Rekognition。
关键区别很简单:OCR 用来提取文字,计算机视觉用来识别视觉元素,而多模态摘要会把这些信号转化为可理解的含义。