
Anthropic 发布了 Claude Fable 5.2 和 Claude Mythos 5.2,在编码、科学研究、推理以及复杂的技术工作流方面带来了显著改进。最引人关注的变化是:输出生成速度最高提升 30%,标准 API 定价降低 20%,并且在多项苛刻基准测试中表现更加强劲。
下面是变化内容、两种模型的对比,以及你是否真的需要它们。
Claude Fable 5.2 和 Mythos 5.2 是什么?
Claude Fable 5.2 和 Mythos 5.2 是 Anthropic 最新的前沿模型,专为尤其棘手的技术与研究问题而设计。
与主要为日常对话优化的模型不同,这些发布更聚焦于可能需要更长推理、复杂代码执行、工具使用以及多轮实验的任务。
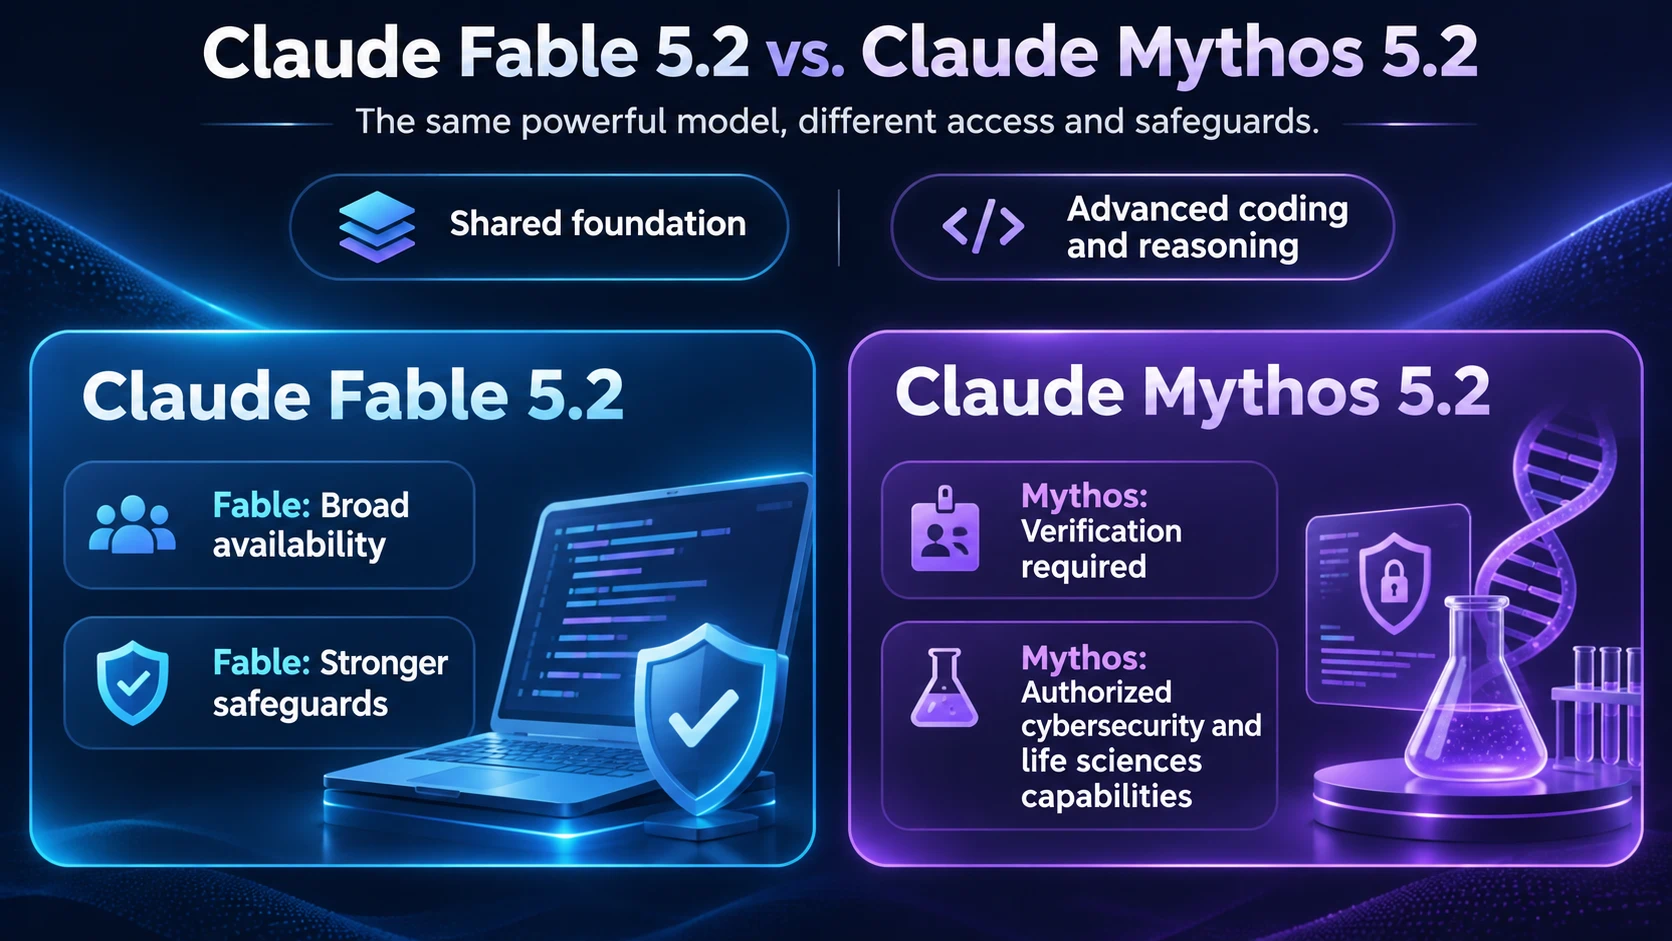
Claude Fable 5.2 是面向广泛用户的版本。它包含安全防护措施,用于限制某些高风险的网络安全与生物研究活动。
Claude Mythos 5.2 为在网络安全与生命科学领域开展工作的经验证组织提供专门能力。
| 功能 | Claude Fable 5.2 | Claude Mythos 5.2 |
|---|---|---|
| 底层模型 | 共享基础 | 共享基础 |
| 主要受众 | 开发者、工程师、研究人员 | 经验证的安全与生命科学团队 |
| 编码与推理 | 进阶 | 进阶 |
| 网络安全能力 | 由安全防护限制 | 扩展的授权能力 |
| 生物研究 | 在敏感领域受限 | 获批研究可用 |
| 通用可用性 | 广泛可用 | 需要验证 |
| 标准 API 定价 | $8 输入 / $40 输出 | $8 输入 / $40 输出 |
API 价格按每百万 tokens 计费。即便共享底层模型,访问与安全防护策略也不同。
Claude Fable 5.2 有哪些新变化?
1. 更强的编码与软件工程能力
编码是最清晰的改进方向之一。
在评估 AI 生成代码变更是否符合真实开源项目所需标准的 FrontierCode 2.0 测试中,Fable 5.2 在 Xhigh effort(最高精度努力模式)下取得了 49.1% 的成绩,而 Fable 5.1 为 32.4%。
Anthropic 还报告称,由运行早期版本 Fable 5.2 的代理完成了从 Python 到 Rust 的生产迁移。迁移后的服务启动速度大约快了 26 倍。
在另一个实验中,Fable 协调了超过 1,000 个 AI 子代理来构建一个原型操作系统,该系统能够在笔记本电脑上完成启动。
这些例子指向了高级代码助手使用方式的变化:模型不再只被用于处理孤立的代码建议,而是越来越多地在端到端的工程项目中接受测试。
这并不意味着不再需要代码审查、安全检查或人工审批。
2. 更快的响应与更好的效率
Anthropic 表示,Fable 5.2 和 Mythos 5.2 的输出生成速度比它们的 5.1 前辈最高快 30%。
它们还引入了可选的快速模式,可将 token 生成速度最高提升至 2.5 倍。
对于运行较长编码会话或多代理工作流的开发者而言,更快的生成速度可以减少迭代之间的等待时间。
不过,更快的输出不一定更便宜。快速模式的费用是标准 token 费率的两倍,因此团队应评估节省的时间是否值得这部分额外成本。
3. 科学研究与数学推理
Anthropic 公告中一些最雄心勃勃的说法与研究相关。
公司报告称,Fable 5.2 参与解决了两项涉及黑洞与量子引力的开放理论物理难题。
它还在 30 小时内协调了约 1,000 个代理,用于形式化 Fermat's Last Theorem(费马最后定理)的证明。形式化的含义是将数学证明转换为软件可逐步验证的形式;这并不等同于发现该定理原始证明。
与此同时,Mythos 5.2 也帮助开发了一种用于建模复杂病毒蛋白结构的计算方法;Anthropic 报告称,在测试的 34 个衣壳(capsids)中,有 28 个得到准确模型。
这些结果表明,AI 辅助的科研工作机会正在增加。不过,需要注意的是,这些仍然是公司报告的特定研究演示,而不等同于证据证明这些模型能够独立解决任意科学问题。
Claude Fable 5.2 基准测试:到底提升了多少?
Anthropic 发布了跨编程、业务工作流、推理与研究等领域的对比结果。
| 基准测试 | Fable 5.1 | Fable 5.2 |
|---|---|---|
| FrontierCode 2.0 | 32.4% | 49.1% |
| FrontierSWE v2 | 56.3% | 69.9% |
| AutomationBench | 31.4% | 51.4% |
| Humanity's Last Exam(带工具) | 65.6% | 74.2% |
| Chartography(不带工具) | 44.8% | 73.4% |
来源:结果通常反映每个模型可用的最高努力设置,不应被解读为相同成本下的对等比较。
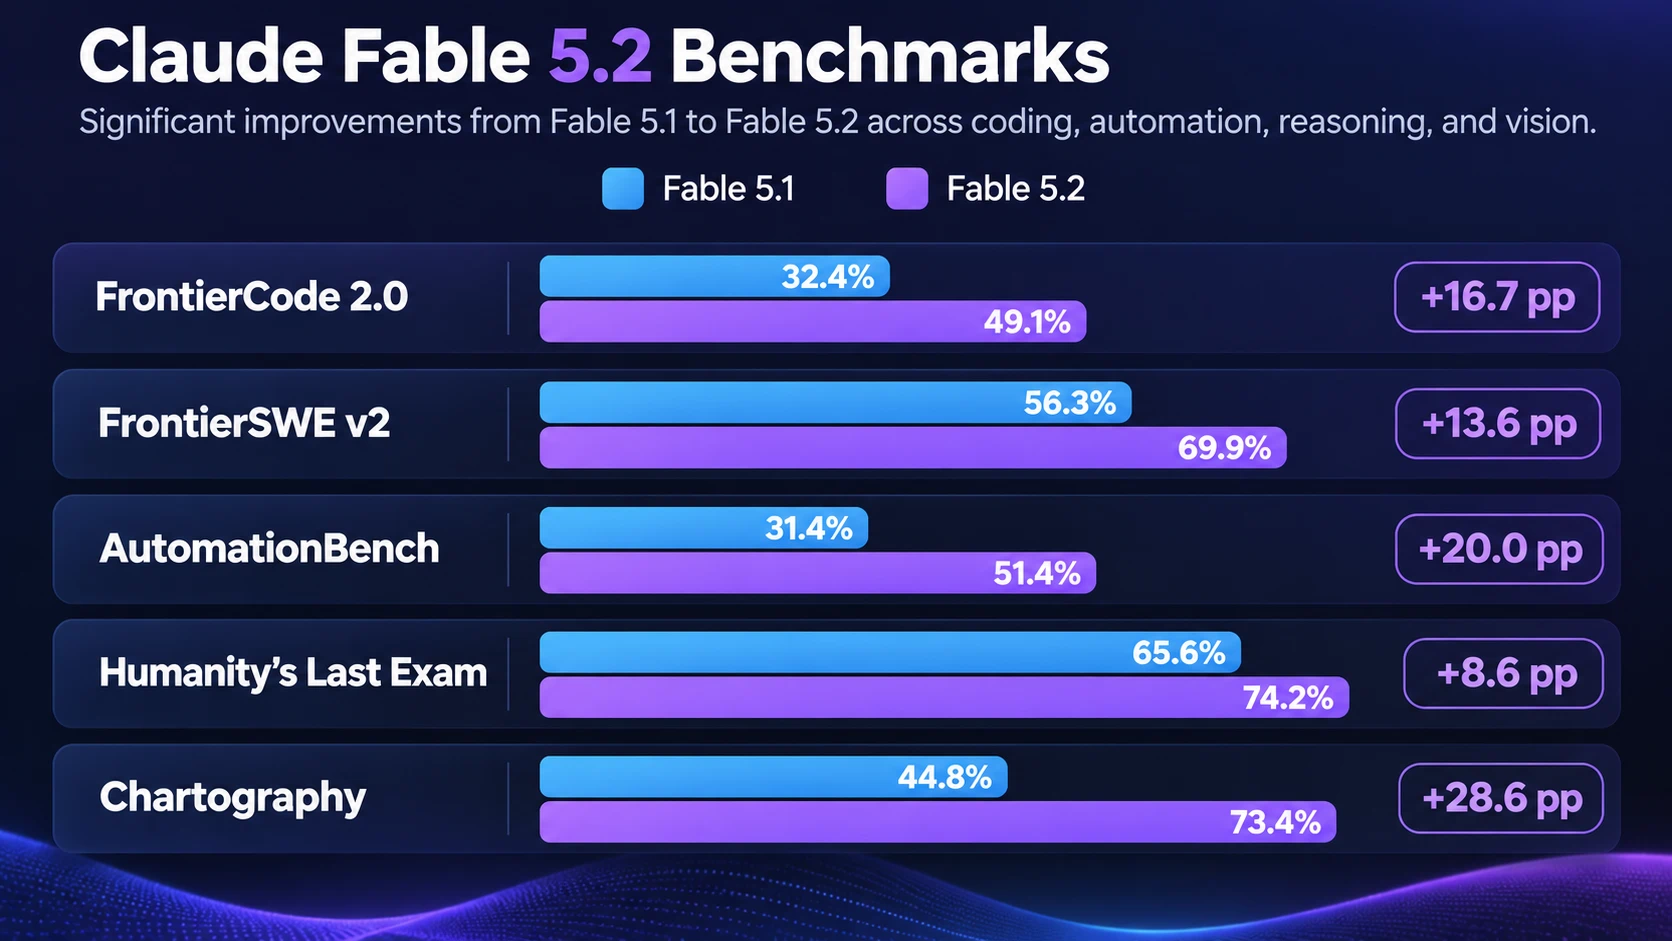
对于知识工作者来说,图表解读与业务工作流表现可能尤其值得关注。它们与分析报告、解读图表以及处理多步骤信息问题等任务相关。
不过,基准测试分数也有局限性。性能会取决于任务复杂度、可用工具、推理设置以及结果如何被评估。
更高的基准分数当然是一个值得在你自己的工作流中测试模型的理由,但它并不能保证在每一种情境下都能得到更好的结果。
Claude Fable 5.2 和 Mythos 5.2 的定价
与上一代相比,Anthropic 已降低标准 API 价格。
| 每 1M tokens 的定价 | 5.1 生成 | 5.2 生成 |
|---|---|---|
| 标准输入 | $10 | $8 |
| 标准输出 | $50 | $40 |
| 快速模式输入 | — | $16 |
| 快速模式输出 | — | $80 |
新的标准价格代表 输入与输出成本均降低 20%。
对于需要处理大量信息的企业来说,这可能让更高级的推理工作流变得更具经济性。
实际成本仍取决于 token 消耗量、努力设置、缓存(caching)、工具使用以及完成任务所需的尝试次数。
Claude Mythos 5.2:为什么限制访问?
Claude Mythos 5.2 对网络安全专业人士与生物学研究人员尤其相关。
Anthropic 表示,新模型能够比以往代际模型更有效地识别、复现并帮助修复软件漏洞。
其报告的 CVE Rediscovery(漏洞复现)结果达到 89.6%,而 Mythos 5.1 为 78.3%。
这些能力可以帮助获授权的防御方调查弱点,但同时也带来了被滥用的风险。
因此,Anthropic 通过其 Cyber Verification Program(网络安全验证计划)与 Life Sciences Verification Program(生命科学验证计划)来限制 Mythos 的直接访问。
在这些领域,Fable 5.2 仍保留更强的安全防护。Anthropic 报告称,其更新后的安全防护策略产生的不必要拦截也比 Fable 5.1 更少。
这种做法体现了更广泛的 AI 行业挑战:在提供更有用的高级能力的同时,管理与日益强大的模型相关的风险。
如何访问 Claude Fable 5.2 和 Mythos 5.2
Claude Fable 5.2 可通过受支持的 Claude 服务以及主要云平台使用,包括 Amazon Web Services、Google Cloud 和 Microsoft Azure。
开发者可以使用模型标识符:
claude-fable-5-2
Anthropic 还宣布,在上线首周期间,对符合条件的付费 Claude 订阅用户提供临时的额外 Fable 使用额度。
Claude Mythos 5.2 需要通过相应的验证计划来获取访问权限;不过 Claude Enterprise 客户可以使用 Claude Security,其中整合了来自 Anthropic 更广泛模型家族的能力。
通过 Anthropic 提供的可用性,并不意味着每一家第三方 AI 平台都已集成这些模型。
Fable 5.2 vs. Opus 5.5:你该选哪个?
尽管 Fable 5.2 的能力令人印象深刻,Anthropic 并不建议把它用于所有场景。
对大多数日常编程与知识类任务,公司建议从 Claude Opus 5.5 开始。
当某项任务难到需要额外的推理资源时,Fable 5.2 才更合适。
可以考虑在复杂的软件迁移、延伸的研究问题、复杂的工程分析或多代理协作等场景中使用 Fable 5.2。
对于日常写作、文档摘要、普通编码以及直截了当的问题,选择一个更经济的模型可能就足够了。
实际的选择并不只是看哪个模型分数最高。关键在于:在你可用的时间与预算范围内,哪个模型能提供可靠结果。
这对研究与知识工作意味着什么?
此次发布强调,AI 正在从生成单个答案,迈向处理更长、更紧密连接的工作流。
但即便模型在推理方面越来越强,人们仍需要理解重要决策背后的文档、研究与数据。
这时,一个有条理的信息工作流就会变得非常有用。
通过 iWeaver,你可以:
- 使用 AI Knowledge Base 在你选择的文档与参考资料中探索问题。
- 借助 Research Paper Analyzer 查看学术方法、研究发现与局限性。
- 通过 Financial Statement Analysis 检查财务报表、比率与趋势。
这些工具能帮助你把分散的来源材料整理成结构化的笔记与分析,并可与原始资料进行核对。
它们与更强大的 AI 系统整体趋势相辅相成,同时不要求每一种文档任务都必须使用计算成本最高的模型。
Claude Fable 5.2 比 Claude Opus 5.5 更好吗?
在许多更高阶的基准测试中,Fable 5.2 表现更好,尤其是在困难的编码与研究任务上。然而,Anthropic 建议大多数日常编码与知识工作从 Opus 5.5 开始。
Claude Fable 5.2 和 Mythos 5.2 有什么区别?
两者共享同一个底层模型。Fable 在处理敏感的网络安全与生物任务方面提供更强的安全防护,而 Mythos 则为在这些领域工作的经验证组织提供专门的访问能力。
Claude Fable 5.2 免费吗?
Anthropic 已将 Fable 5.2 面向更广泛用户开放,但具体使用情况取决于相应的 Claude 套餐、平台限制或 API 计费安排。广泛可用并不意味着无限制的免费访问。
Claude Fable 5.2 需要多少钱?
标准 API 定价起步为每百万输入 tokens $8、每百万输出 tokens $40。可选快速模式分别为 $16 与 $80。
有人都可以使用 Claude Mythos 5.2 吗?
不可以。直接访问仅限通过 Anthropic 验证计划符合条件的组织。某些由 Mythos 驱动的安全能力也可通过 Claude Enterprise 产品获得。
Claude Fable 5.2 与 Mythos 5.2 代表了迈向更强大 AI 系统的重要一步,这些系统能够处理更大、更具挑战性的技术项目。
在编码、科学研究与推理方面的改进值得关注,尤其是在标准 API 价格更低的同时。
但最重要的启示可能是:这些模型的设计意图。最强模型用于最难的问题,较小模型用于日常任务,并且在全流程中都有人工监督。
对于日常研究与文档量较大的工作,眼下的优先级仍然相同——整理你的来源、核查证据,并把信息转化为真正有用的内容。
探索 iWeaver,在一个 AI 工作空间中对你的研究资料进行总结、分析与整理。