
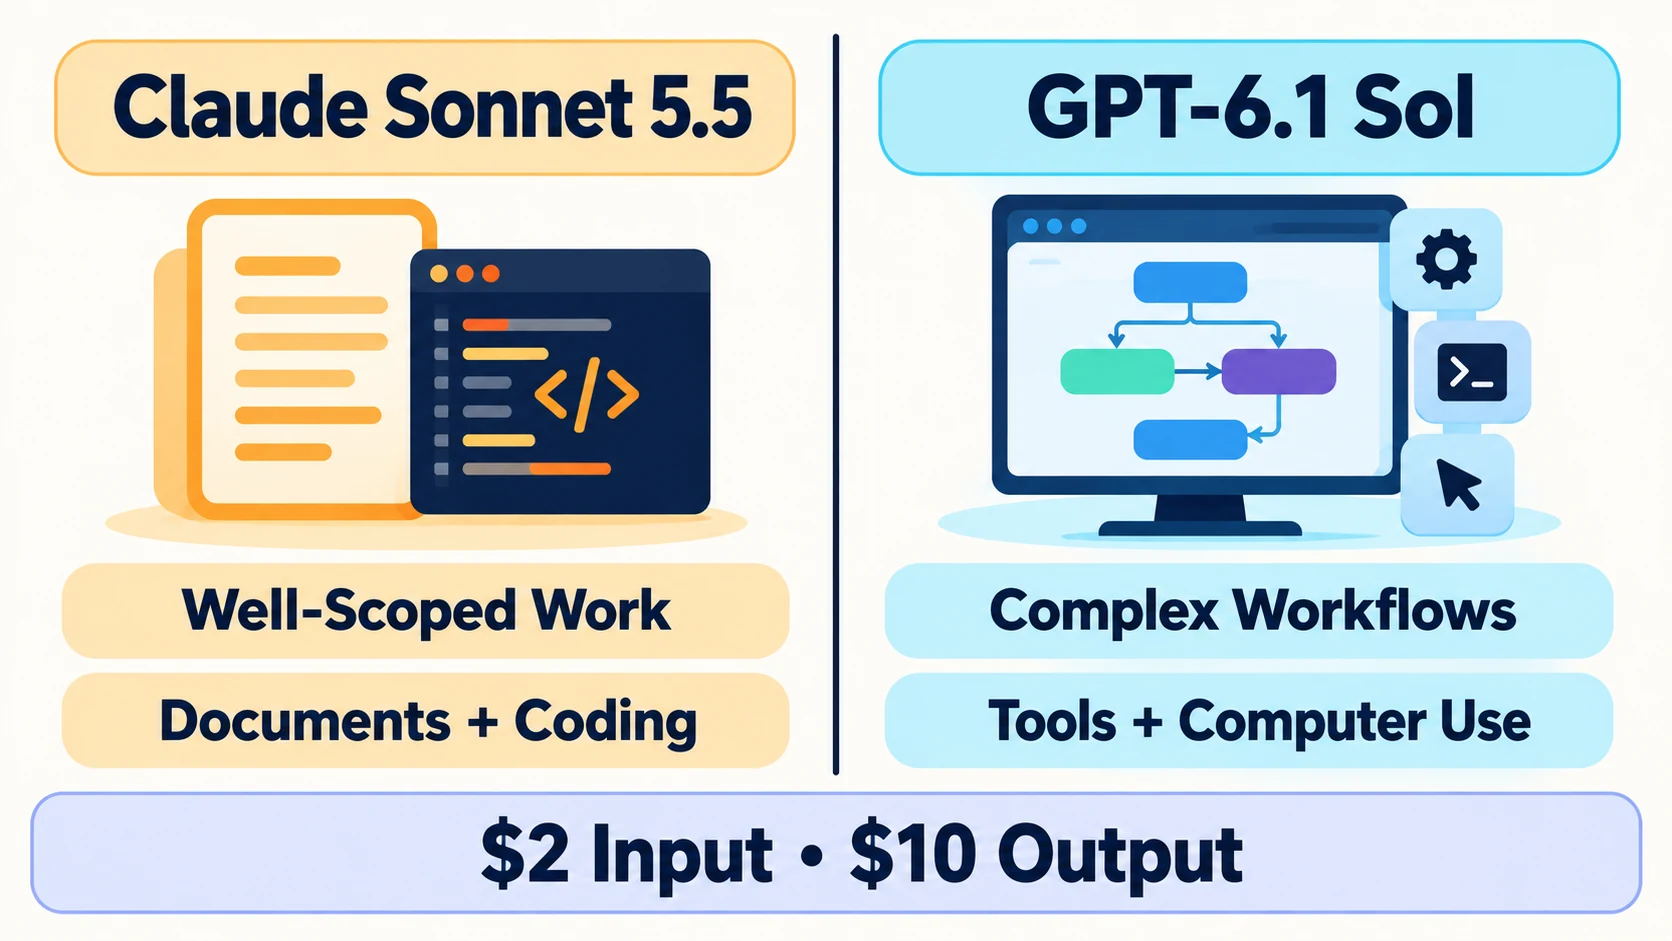
Claude Sonnet 5.5 和 GPT-6.1 Sol 的标准 API 令牌价格相同,但它们的设计侧重点不同。Sonnet 5.5 更适合快速、边界清晰的代码编写以及专业任务。GPT-6.1 Sol 则面向更复杂的代码开发、计算机操作、工具驱动的工作以及专业工作流,同时在较低成本下提供接近 Astra 的性能。
实际选择取决于具体任务。Sonnet 5.5 值得在“限定范围内的编码”、更精致的文档、幻灯片和电子表格场景中先试试。你在需要非常大的上下文窗口、OpenAI 的 Responses API 工具,或多步骤工作流时,GPT-6.1 Sol 是一个很强的候选。iWeaver 提供 GPT-6.1 Sol 免费试用,让你可以在选择之前,先用自己的文档和研究任务对模型进行测试。
Claude Sonnet 5.5 vs GPT-6.1 Sol 概览
| 细节 | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| 标准输入价格 | $2 / 1M tokens | $2 / 1M tokens |
| 标准输出价格 | $10 / 1M tokens | $10 / 1M tokens |
| 缓存读取价格 | $0.20 / 1M tokens | $0.10 / 1M tokens |
| 上下文窗口 | 查看所选 Claude 平台 | 1,050,000 tokens |
| 最大输出 | 查看所选 Claude 平台 | 128,000 tokens |
| 官方侧重点 | 边界清晰的编程与专业任务 | 复杂编程、计算机使用与专业工作 |
| 推理控制 | 可调节的努力程度 | low、medium、high、xhigh 和 max |
| API 模型名称 | claude-sonnet-5-5 |
gpt-6.1-sol |
GPT-6.1 Sol 的数据来自 OpenAI 的模型文档。Sonnet 5.5 的定价与定位来自 Anthropic 的发布公告。长上下文定价、批处理、快速模式、缓存写入、工具调用以及云服务商条款都可能影响最终成本。
编码:对“范围控制”的重视,和原始能力同样重要
Anthropic 将 Sonnet 5.5 定位为适合日常专业工作的快速模型,用于修复漏洞以及明确范围内的任务。其发布材料报告了强劲的编码表现,包括在 Terminal-Bench 4.0 上取得 70.6%,以及在 FrontierCode 1.1 Main 上以 Max effort 达到 46.2%。
GPT-6.1 Sol 则定位于复杂代码开发和“代理式”工作。OpenAI 还为它提供了代码执行、托管 shell、应用补丁、计算机使用以及通过 Responses API 提供的其他工具。
这些事实并不能直接证明存在“唯一通用的赢家”。一次代码评估应当使用相同的代码仓库问题、指令、运行环境以及时间预算。检查模型是否找到正确原因、是否只改动了必要文件、是否执行了合适的检查,以及在任务完成时是否及时停止。
当任务边界明确且需要快速迭代时,可选择 Sonnet 5.5 进行试用。当工作需要更广的代码仓库上下文、工具协同,或需要多阶段的实现与验证时,选择 GPT-6.1 Sol 进行试用。
文档与知识工作
Sonnet 5.5 被明确定位为用于生成更精致的文档、幻灯片和电子表格。Anthropic 的发布证据也同样强调了专业知识工作能力,并指出相较于 Sonnet 5,效率有所提升。
GPT-6.1 Sol 提供了已记录的 1,050,000-token 上下文窗口,最高可输出 128,000 个输出 tokens。这使它成为大规模文档集合、研究综合、政策审阅以及细致的结构化交付内容的一个有吸引力的选择。
仅有上下文容量并不能证明文档质量。请使用相同的资料包同时测试两种模型,并要求它们提取关键数据、调和相互冲突的表述、区分证据与推断,并展示每个结论来自哪里。产出更易审计结果的模型,可能比写出更顺滑“初稿”的模型更有价值。
工具与工作流匹配
GPT-6.1 Sol 的最明显优势,是它通过 Responses API 提供了可查阅的工具能力面。它支持网页搜索、文件搜索、图像生成、代码执行、托管 shell、计算机使用、MCP 以及工具搜索。对于那些已经基于 OpenAI 代理栈构建团队来说,这有可能降低集成摩擦。
Sonnet 5.5 可通过 Claude 产品、Claude Platform、AWS、Google Cloud 以及 Microsoft Azure 使用。当一个组织已经使用这些环境,或其提示词与评估已针对 Claude 进行调优时,它可能更自然地融入现有流程。
围绕模型的生态平台同样重要。日志记录、权限管理、源代码管理、审阅步骤、数据需求以及团队工作流,都可能比某个基准测试上的小差异更关键。
希望先了解早期基准的读者,可以在评估 6.1 更新带来哪些变化之前,先查看 iWeaver 发布的 Claude Sonnet 5.5 vs GPT-6 对比 。
成本:相同的令牌价格,不同的任务成本
两种模型都标注了标准价格:输入每百万 tokens 为 $2,输出每百万 tokens 为 $10。这并不意味着完成任务的成本相同。
总任务成本包含提示词大小、缓存行为、推理投入、工具调用、重试次数、输出长度以及人工审阅。Anthropic 表示 Sonnet 5.5 可以比 Sonnet 5 使用更少的 tokens 并运行更快,但这只是与其前代的对比——并不能证明它比 GPT-6.1 Sol 更便宜。
衡量达到可接受结果所需的总成本。即使某一次回复更长,只要总体需要更少的修正,它仍可能更省钱。
你应该选择哪一个模型?
当你的首要目标是边界清晰的编程、快速迭代,或生成更精致的文档与办公风格的输出时,可以试用 Claude Sonnet 5.5。它最强的公开证据与产品定位,正对应这些任务。
当你需要更大的上下文窗口、OpenAI 的工具生态、复杂的多步骤工作,或 Astra 的更低成本替代方案时,可以试用 GPT-6.1 Sol。当你的应用已经依赖 Responses API 时,它也是更自然的选择。
要做出公平的决定,别只用一个通用提示词运行:请用三个有代表性的任务来测试——一个例行任务、一个困难任务,以及一个资料密集的任务。评估正确性、完整性、延迟、总 tokens、不必要的改动,以及审阅时间。
你可以在 iWeaver 中开始 GPT-6.1 Sol 免费试用,并用你自己的文档或研究工作流进行评估。最好的模型,是在投入最少的总体精力下达到你质量标准的那个——而不是标题最响的那个。