
Gemini 4 Argon 是 Google 全新的旗舰推理模型,面向需要在多个步骤中持续投入、才能解决的棘手问题。它的发布对那些需要协调彼此冲突的文档、排查技术问题,或基于证据构建论点的人来说很关键。真正有价值的问题是:它能否在回答审核者进行更少修改的情况下,完成这些任务。
Google 最初通过向可信的网络安全合作伙伴进行受限推送的方式推出 Argon。Google 随后宣布,Gemini 应用中将向 Google AI Pro 和 Ultra 订阅者开放访问权限。把该模型描述为“仅对早期测试者开放”的文章,现在需要补上这项限定。
为什么持续推理很重要
Google 将 Argon 定位为用于复杂软件工程、科学问题求解以及长期的专业任务。这样的定位意味着一个有用的评估目标:那些早期错误可能会在后续多个决策中不断扩散的工作。它并不能证明每一项总结或写作任务都会变得更好,也不能证明该模型无需审核也能正常工作。
想象一份由三份报告汇总而成的研究简报:第一份使用了较早的定义,第二份描述的是不同人群,第三份把两者都做了总结,却没有解释两者差异。一个有用的回答应当在提出建议之前,先把这些边界保持清晰。即便听起来很有说服力,混合了关键发现、写得流畅的段落也会让任务失败。
这就是推理模型的实际机会:在朝答案推进的同时,保留问题的结构。要评估它,可以让它把冲突点、支撑证据和缺失信息分别作为独立输出。这样,一次失败会比单次“精致综合”的产出更容易识别。
已发布的规格到底意味着什么
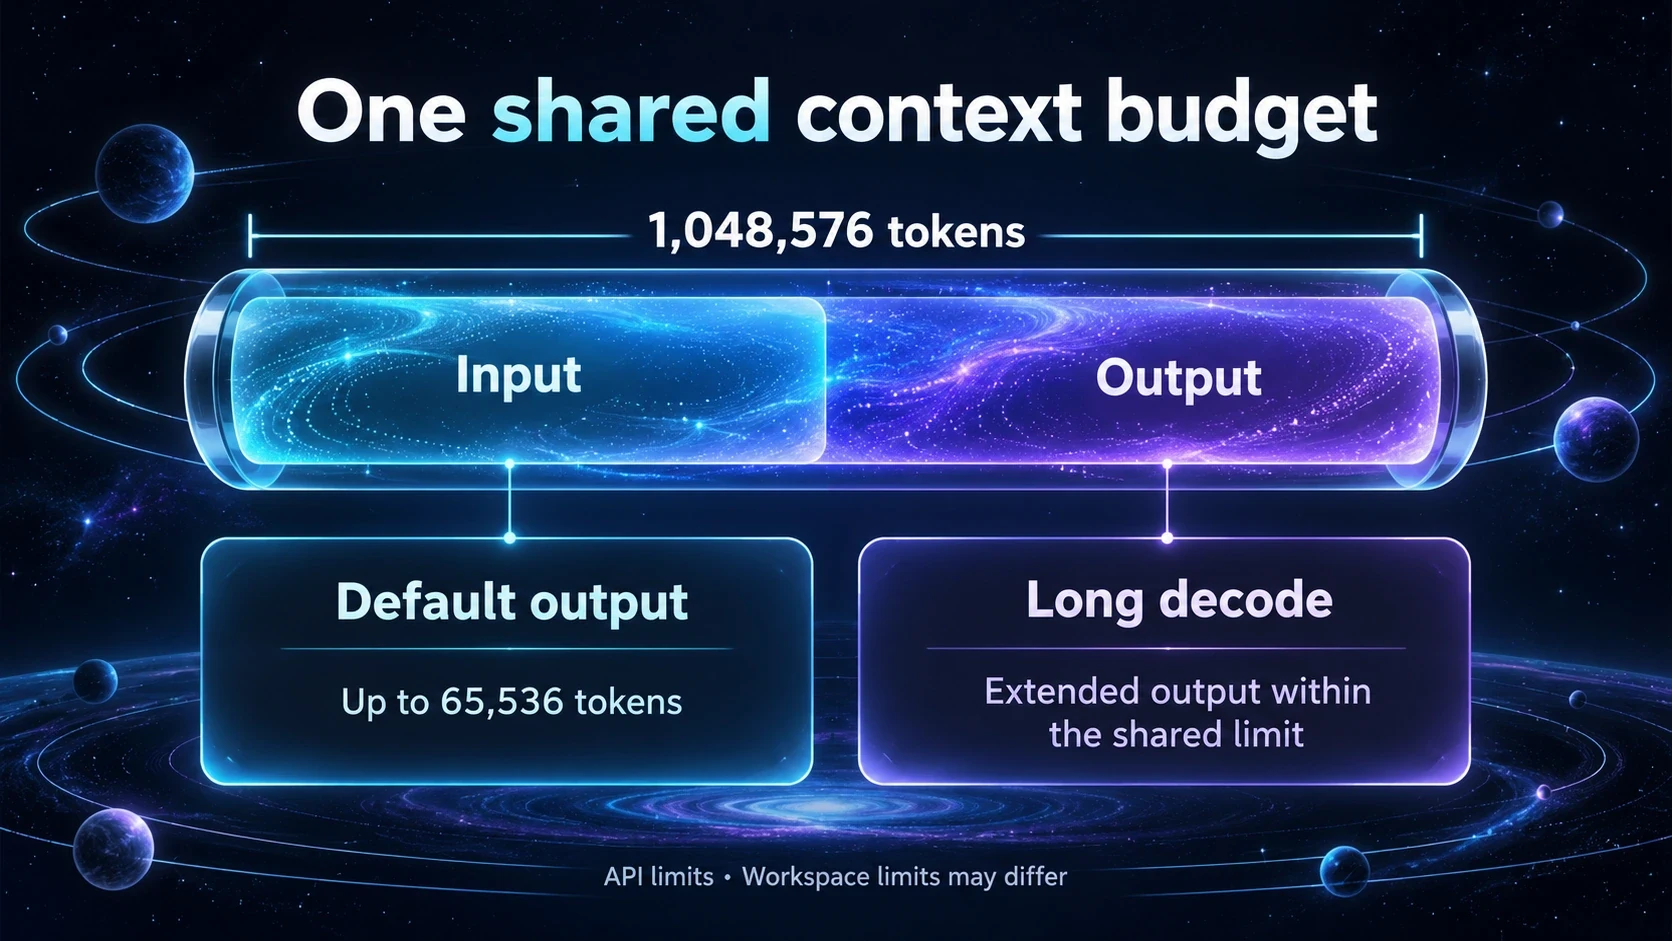
Gemini API 模型文档 列出了文本、图像、视频、音频以及 PDF 输入,并提供文本输出。它描述了统一的输入与输出上下文窗口,总计 1,048,576 tokens。默认同步输出上限为 65,536 tokens;要把输出扩展到统一上限,需要更长的解码。
这些是 API 规格。应用或第三方界面可能会暴露不同的能力子集,因此不应把模型“发布的最大值”当作对任何特定工作区的承诺。输入支持也不意味着图像或音频生成:这些输出能力并未被列为 Argon 支持。
在文档工作中,更重要的是“容量”与“可用性”之间的区别,而不是某个头条数字。更大的窗口让你有空间提供材料,但它并不会决定哪个版本才是权威。标注来源、说明日期,并解释答案应如何处理矛盾。更短但组织良好的资料包,能让结果更容易被核查。
三项值得作为首个测试来用的任务
让彼此冲突的来源达成一致
给模型一小组带有可识别分段的报告。让它说明哪些说法一致、哪些冲突,以及由于定义不同而无法进行对比的内容。要求每一项发现都必须给出来源引用,并由你自己检查几条引用。这个测试的关键在于:答案是否保留了你已知存在的差异。
解释一项困难的论证
选择一段你足够了解、能够判断其对错的内容。先让它给出论证前提、结论以及未明说的假设,然后再要求它为一位更不技术的读者做解释。为了更聚焦的文档工作流程,iWeaver 的 PDF Explainer 旨在帮助你拆解难懂段落,而不仅仅是把内容压缩变短。
编写决策简报
提供两个选项、明确的评价标准,以及每个选项对应的证据。让模型提出推荐选项,说明哪些证据会改变该推荐,并标记仍未回答的问题。该测试用于验证它能否在你的约束条件内进行推理,而不是为了填满一张看起来吸引人的表格而编造事实。
如果你正在考虑是否要从现有的 Gemini 工作流切换,我们的 Gemini 4 Argon vs Gemini 3.8 Flash 对比 解释了如何比较任务难度、输出需求以及审核所需的工作量。
如何解读发布基准测试
Google 的公告把基准测试结果作为“进步证据”。这些结果是有用的信号,但来源是模型供应商,而评估条件又同样关键。本文不会报告独立的实际动手基准,也不会声称 Argon 是每项任务的最佳模型。
在把基准测试转化为采购或工作流决策之前,请先识别任务、工具设置以及成功标准。然后再与自己的工作进行对照。代码基准无法证明文献综述的准确性;一份更长的回答也无法证明它的参考资料是正确的。
将模型引入可重复的工作流
Gemini 4 Argon 现在已在 iWeaver 中提供,并且 iWeaver 提供该模型的免费试用。在工作区中选择它,并用一个真实任务搭配明确的验收标准。若要实现基于来源的工作流以及可供你调整的提示词,请参照我们的 使用 Gemini 4 Argon 指南。
最强的首用场景是可验证的基于来源的任务。准备证据、定义所需输出、检查结果,并保留对下一轮运行的修改内容。Argon 的发布为困难工作提供了一个新的候选方案。是否继续使用它,应取决于它在该工作流中究竟做对了什么。