
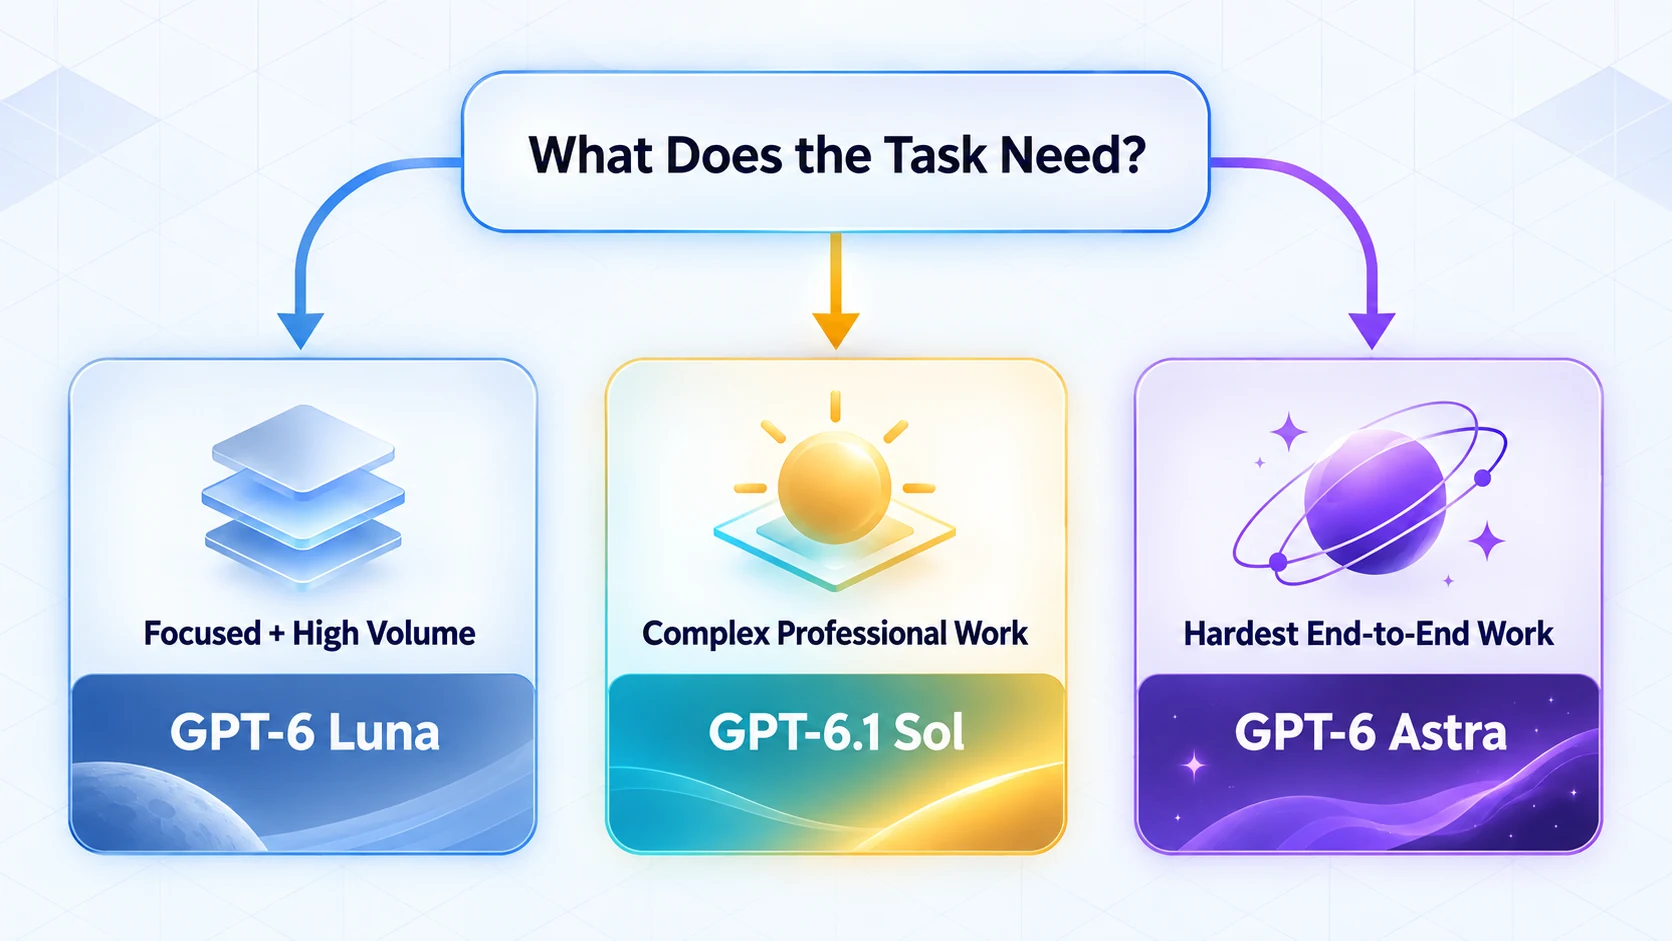
GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna 面向不同层级的工作需求而设计。Astra 是处理最艰难端到端任务的最高能力选项。GPT-6.1 Sol 在复杂任务表现与更低价格之间取得平衡。Luna 则是针对聚焦、高频工作量的经济之选。
对于许多专业工作流而言,GPT-6.1 Sol 是更明智的起点。它的标准输入与输出 token 计费是 Astra 的五分之一,而 OpenAI 将其定位为“接近 Astra 的性能”。iWeaver 提供 GPT-6.1 Sol 免费试用,让你在决定是否升级到 Astra 或降低到 Luna 之前,就能用真实任务验证这种平衡。
GPT-6 模型对比
| 详情 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Luna |
|---|---|---|---|
| 主要角色 | 最艰难的端到端工作 | 成本更低的复杂任务 | 聚焦、高频工作 |
| 标准输入价格 | $10 / 1M tokens | $2 / 1M tokens | $0.10 / 1M tokens |
| 标准输出价格 | $50 / 1M tokens | $10 / 1M tokens | $0.50 / 1M tokens |
| 上下文窗口 | 1,050,000 | 1,050,000 | 1,050,000 |
| 最大输出 | 128,000 | 128,000 | 128,000 |
| 推理工作量 | 低至最大 | 低至最大 | 无至最大 |
| 图像输入 | 支持 | 支持 | 支持 |
| 最佳起点 | 高风险、困难的工作 | 最复杂的专业工作流 | 重复且注重成本的任务 |
这些规格与定位基于 OpenAI 的模型目录、GPT-6 Astra 模型页 以及 GPT-6.1 Sol 模型页。标准 token 费率不包含所有长上下文、缓存、处理模式、区域或工具相关的费用。
选择 GPT-6 Astra 来处理最艰难的任务
OpenAI 将 Astra 描述为其最强大的、适用于高要求端到端工作的模型。它面向困难推理、软件工程、研究、计算机使用以及文档创建等场景——当质量比最低 token 价格更重要时,Astra 正是为此而生。
当任务存在歧义、跨越多个阶段、需要持续判断,或失败成本很高时,Astra 就很有意义。例如:复杂的系统迁移、开放式的研究调查,或必须在协调多种工具的同时适应新信息的工作流。
由于 Astra 的标准 token 价格是 GPT-6.1 Sol 的五倍,如果把每个常规请求都路由给 Astra,可能会造成浪费。关键问题在于:Astra 额外能力带来的改进——是否足以显著降低错误、重试次数或人工审核成本,从而抵消差异。
iWeaver 先前的 GPT-6 Astra vs Sol vs Luna 指南 提供了该系列的原始对比,并为 6.1 更新提供了有用的基准。
选择 GPT-6.1 Sol 来实现均衡的专业工作
GPT-6.1 Sol 面向复杂编码、计算机使用以及各类专业任务而设计。它在上下文与最大输出规模上保留了与 Astra 相同的已记录规格,同时按 token 计费显著更低。
因此,Sol 是一个很强的默认候选,适用于研究整合、偏文档密集的分析、多步骤编码、结构化报告撰写以及代理(agent)工作流。当 Luna 对任务来说偏轻,而又很难为每次运行都合理化选择 Astra 时,Sol 尤其贴合。
GPT-6.1 Sol 支持 low、medium、high、xhigh 和 max 推理工作量。文档默认值为 medium。从这里开始,只有在具有代表性的评估表明更困难的任务确实从中受益时,才逐步提高推理工作量。
选择 GPT-6 Luna:追求高吞吐与效率
Luna 是 OpenAI 面向成本敏感型、聚焦且高频工作负载的模型。它的标准 API token 价格相比 Sol 与 Astra 都要低得多。
它很适合作为分类、提取、转换、简短摘要、常规客户运营以及其他带有清晰指令的可重复任务的候选。由于 Luna 既支持 none 推理工作量,也支持更高设置,开发者拥有更大的空间来为简单工作负载优化速度与成本。
低价格并不自动意味着 Luna 是最省的运营选择。如果某个任务反复失败或需要大量人工复核,将其路由到 Sol 可能反而降低总成本。
一个可落地的模型路由规则
使用能够可靠满足验收标准的最小模型:
- 对于范围窄、重复性强的任务,从 Luna 开始。
- 当工作需要更深层推理、长上下文或多个协同步骤时,切换到 GPT-6.1 Sol。
- 只有在 Astra 的任务最艰难、且 Sol 无法达到所需的质量或可靠性时,才保留使用 Astra。
这种路由方式比直接宣称“某个模型就是赢家”更有价值。它把模型选择与任务难度、风险以及审核成本关联起来。
如何测试差异
从你的真实工作中创建一个小型评估集。包含一个简单任务、一个典型任务和一个困难任务。对每个模型都使用相同的数据来源、输出要求和评分标准。
评估:
- 正确性与完整性。
- 对指令的遵循。
- 不受支持的主张或不必要的改动。
- 时间与总 token 使用量。
- 人工审核与纠错投入。
从 iWeaver 中的 GPT-6.1 Sol 免费试用开始,并把结果当作你均衡基准。如果任务很容易完成,Luna 可能就足够了。如果在精心设计的提示词与适当的推理工作量之后,输出仍然不达预期,那么 Astra 值得进行一次受控测试。