
GPT-6.1 Sol 是 OpenAI GPT-6 系列中更新的均衡模型。它保留了大上下文窗口、最大输出规模,以及与 GPT-6 Sol 对应的标准 2 美元 /10 美元(输入/输出)定价点,但 OpenAI 现在将 6.1 定位为:以更低成本提供接近 Astra 的复杂任务表现。
此次更新还改变了一个重要配置细节:GPT-6.1 Sol 支持推理强度从 low 到 max,但不再支持 none 或 minimal。开发者和高阶用户应将该模型视为一次升级来评估,而不是假设此前的每个设置都能原样复制。
iWeaver 提供 GPT-6.1 Sol 免费试用,让你用一种简单的方式,把更新后的模型与您已经熟悉的结果和工作流进行对比。
GPT-6.1 Sol vs GPT-6 Sol 对比表
| 详情 | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| 定位 | 复杂编码与智能体式工作流 | 更低成本下的接近 Astra 复杂工作表现 |
| 标准输入价格 | 每 1M tokens 2 美元 | 每 1M tokens 2 美元 |
| 标准输出价格 | 每 1M tokens 10 美元 | 每 1M tokens 10 美元 |
| 上下文窗口 | 1,050,000 tokens | 1,050,000 tokens |
| 最大输出 | 128,000 tokens | 128,000 tokens |
| 推理强度 | None、low、medium、high、xhigh、max | Low、medium、high、xhigh、max |
| 工具调用 | 建议使用 Responses API | 使用工具调用时需要 Responses API |
| API 模型 ID | gpt-6-sol |
gpt-6.1-sol |
本对比参考了 OpenAI 的 GPT-6.1 Sol 文档、当前模型目录 以及 GPT-6 指南。价格会因长上下文、缓存、服务等级、区域处理以及工具使用而有所不同。
主要变化是能力定位
GPT-6 Sol 作为 GPT-6 系列中“均衡”成员推出,面向复杂编码与智能体式工作流。GPT-6.1 Sol 获得更雄心的描述:以更低成本在复杂编码、计算机使用以及专业工作上达到接近 Astra 的表现。
关于原始的家族定位,请参见 iWeaver 的 GPT-6 Astra vs Sol vs Luna 对比。它为理解更新后的 Sol 模型当前所处位置提供了基线。
这并不意味着每一次 6.1 的回答都会与 Astra 相同,或每项 GPT-6 Sol 任务都会得到提升。这意味着 Sol 正被定位得更靠近 OpenAI 顶级档在“质量-成本曲线”上的位置。团队应在自己的评估集上验证这一说法,尤其是涉及判断、长文源材料、工具,以及多个依赖步骤的任务。
上下文与输出限制仍然很大
两款模型都列出了 1,050,000 tokens 的上下文窗口,以及 128,000 tokens 的最大输出。因而已经依赖大输入的应用无需为更小的上下文容量重新设计。
这一限制并不是建议你把每个请求都填满。超过 272,000 tokens 的输入会按文档中列出的 GPT-6.1 Sol 费率获得更高的长上下文定价。较大的提示词也可能让你更难判断哪些内容更相关。即便完整数据集能放得下,检索、来源标注与分阶段分析仍然很有价值。
推理设置需要注意
GPT-6 Sol 支持 none,而 GPT-6.1 Sol 不支持。更新后的模型支持 low、medium、high、xhigh 和 max,其中 medium 是文档中标注的默认值。
如果现有工作流使用了 none 或 minimal,OpenAI 建议迁移到 6.1 时先从 low 开始,然后在有代表性的任务上对比输出。更高的推理强度可能提升困难推理的表现,但也可能增加延迟与 tokens 用量。不要在未测量影响的情况下默认提高该设置。
GPT-6.1 Sol 支持在不使用工具的请求中使用 Chat Completions。对于工具调用,请使用 Responses API。支持的工具集包括:网页搜索、文件搜索、图像生成、代码执行、托管 Shell、应用补丁、计算机使用、MCP 以及工具搜索。
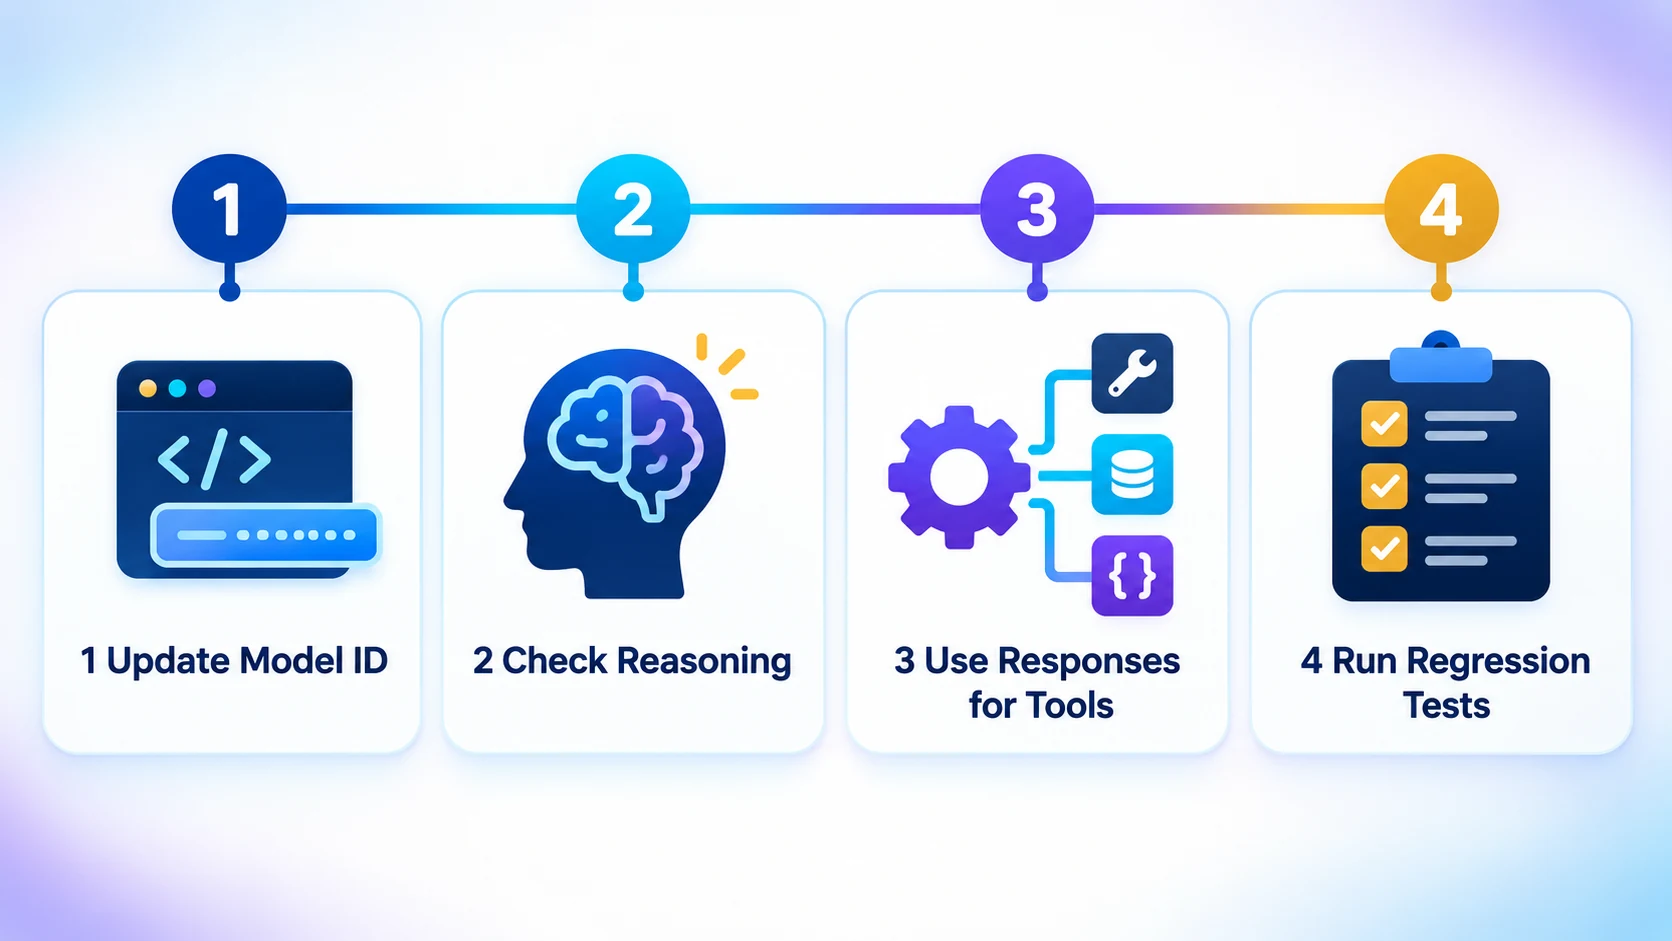
这对智能体应用尤为重要。模型升级不只是模型 ID 的更换;还可能需要检查端点、不受支持的参数、推理设置、缓存行为、工具定义以及评估结果。
你应该升级吗?
当你在编码、计算机使用、研究、文档创建或其他复杂的专业工作中使用 GPT-6 Sol 时,GPT-6.1 Sol 值得评估。最有力的升级理由是:在相同标准的输入/输出 tokens 价格下,可能获得更高的完成质量。
若生产工作流依赖 none 推理、尚未完成回归测试,或需要已被验证的稳定行为,则可以先让 GPT-6 Sol 暂时保留。等你在相同输入与验收标准上对比两种模型后再进行升级。
一个简单的迁移测试
选择 10–20 个任务来代表你的应用实际执行的工作。包含常见场景、困难场景、长上下文场景以及已知失败场景。用等效指令运行两个模型并记录:
- 准确性与任务完成情况。
- 指令遵循与范围控制。
- 工具调用是否成功。
- 延迟与总 tokens 用量。
- 人工审查与修正所需时间。
仅在确认以下用法后再更新模型 ID:是否使用了 none、minimal、采样参数、工具调用以及提示词缓存。OpenAI 的迁移指南提到:当推理处于激活状态时,某些参数可能不被支持。
如果你想快速动手评估,可以在 iWeaver 中开始 GPT-6.1 Sol 免费试用,并重新运行你熟悉的研究、文档或写作任务。使用同一套质量检查清单,将结果与之前的 Sol 输出进行对比。这样,升级决策就会更具体,而不是只依赖某个发布标签。