
GPT-6.1 Sol 是 OpenAI 面向复杂编码、计算机使用与专业工作的均衡型模型。OpenAI 将其定位为以更低价格提供接近 Astra 的性能,使其成为许多需要超越轻量模型、但不想为每个任务都承担 Astra 成本的用户的“现实中间选择”。
iWeaver 现在提供 GPT-6.1 Sol 免费试用,让用户能在决定如何融入自己的工作流之前,直接用它测试模型在研究、文档、写作、分析以及其他知识工作任务中的表现。
GPT-6.1 Sol 一览
| 详情 | GPT-6.1 Sol |
|---|---|
| 最适合 | 复杂编码、计算机使用、研究与专业工作 |
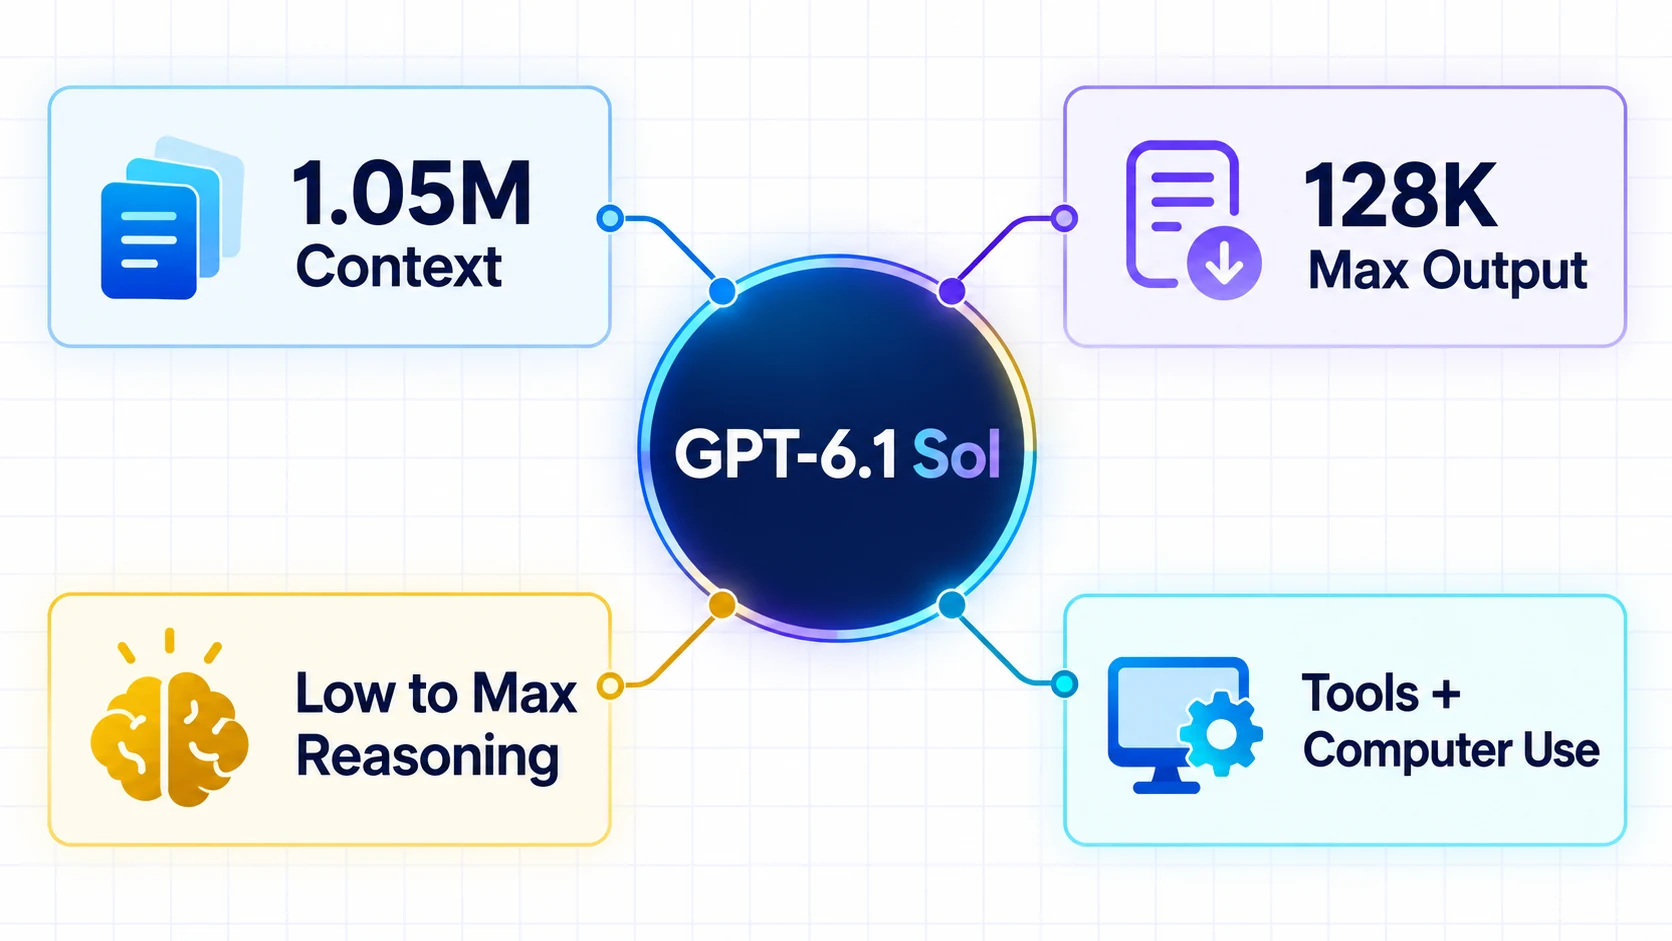
| 上下文窗口 | 1,050,000 tokens |
| 最大输出 | 128,000 tokens |
| 知识截止 | 2026 年 4 月 30 日 |
| 图像输入 | 支持 |
| 音频和视频输入 | 不支持 |
| 推理强度 | low、medium、high、xhigh 和 max |
| 标准 API 输入价格 | $2 / 1M tokens |
| 标准 API 输出价格 | $10 / 1M tokens |
| 微调 | 不支持 |
以上规格来自 官方 GPT-6.1 Sol 模型页面。在长上下文提示、处理模式、缓存、区域处理以及工具调用等情况下,API 价格可能会发生变化,因此标准 token 费率仅用于成本预估的起点。
GPT-6.1 Sol 位于 GPT-6 Astra 与 GPT-6 Luna 之间。Astra 面向最困难的端到端工作,而 Luna 更重视高效、规模化任务。Sol 的目标是在显著更低的 token 价格下,尽可能保留 Astra 的能力。
如需了解更高端的背景,可阅读 iWeaver 之前的 GPT-6 Astra 概览,其中解释了 Astra 在要求高的端到端工作中所扮演的角色。
该模型专为涉及多个相互连接步骤的工作而构建,而非单次短答案。示例包括:审阅一大批文档、排查技术问题、协调整合工具、生成结构化报告,或将一项编码任务从诊断一路推进到验证。
“接近 Astra 的性能”是 OpenAI 的产品定位,并不保证 Sol 在每个提示上都能与 Astra 完全匹配。更关键的问题是:Sol 能否以更低的总成本满足你自己的任务验收标准。
1.05M-Token 上下文窗口
GPT-6.1 Sol 支持 1,050,000-token 的上下文窗口。这为大型代码库、长报告、多份论文、转录内容、政策文档或延长的项目历史提供了空间。
更大的上下文窗口并不意味着你上传的每一项细节都会自动获得同等关注。更好的效果仍取决于清晰的资料组织与精确的请求。针对大型文档任务,你可以告诉模型:
- 哪些文件是权威来源。
- 它必须回答哪些问题。
- 它应当引用或参考哪些证据。
- 输出应当如何进行结构化。
- 哪些不确定性需要标记,而不是进行猜测。
iWeaver 会在这个流程周边提供更实用的工作流。你可以把源材料放入同一个工作区,定义所需的输出,然后继续迭代完善结果,而不是把模型当作一次性聊天框。
推理强度:从 low 到 max
GPT-6.1 Sol 支持五档推理强度:low、medium、high、xhigh 和 max。其中 medium 是文档中标注的默认值。
较低推理强度适合日常的信息抽取、改写、分类以及范围清晰的问题。较高推理强度更适用于需要规划、对冲突证据进行调和、复杂调试或谨慎的多步骤分析的任务。推理越多不一定越好:它可能会在不提升直观回答质量的情况下增加延迟与成本。
该模型不支持 none 或 minimal 推理强度。迁移应用的开发者还应注意:工具调用属于 Responses API 范畴。仅当请求不包含工具时,才支持 Chat Completions。
GPT-6.1 Sol 能做什么?
分析文档与研究
该模型可以跨越长篇源材料集合:提取主张、对比各部分内容、识别矛盾,并生成结构化输出。若准确性很重要,最终结果仍需要进行源头核验。
处理复杂编码任务
GPT-6.1 Sol 旨在支持需要仓库上下文、工具使用、多次编辑与验证的代码工作。一份好的评估应衡量正确性、非必要的更改、测试结果、耗时以及评审投入——而不仅仅是模型是否生成了代码。
协调工具
通过 Responses API,GPT-6.1 Sol 支持多种工具,包括:网页搜索、文件搜索、代码执行、计算机使用、图像生成、MCP 以及工具搜索。可用性与费用可能因工具与环境而不同。
生成专业化输出
该模型可帮助你把源材料转化为报告、简报、计划、表格与结构化草稿。其较大的最大输出能力支持相当可观的交付内容。尽管如此,通常来说,相比在一次请求中直接索要“超大最终答案”,更简洁的提示与分阶段的审核往往更可靠。
GPT-6.1 Sol 的限制
GPT-6.1 Sol 仍可能误读某个来源、忽略例外情况、生成不正确的代码,或过于自信地给出推断。其知识截止也意味着当前信息可能需要浏览或使用你提供的最新来源。
对于重要工作,请核验引用内容、计算结果、引文、代码执行结果以及业务结论。请把它视为在可审查流程中的胜任协作者,而不是最终权威。
如何试用 GPT-6.1 Sol
评估该模型最快的方法,是使用你已理解正确结果的任务来进行验证。选择一个真实的报告、研究问题、文档集合或编码难题,并明确一份成功答案必须包含什么。
你可以在 iWeaver 中免费试用 GPT-6.1 Sol。上传你的文档,描述所需结果,并将输出与自己的常规工作流进行对比。请从准确性、完整性、节省时间以及结果需要多少人工复核来判断。
这种以任务为单位的评估,告诉你的信息不仅仅是基准分数——也能帮助你决定 Sol 是否足够,以及在何时另一个模型档位更值得使用。