„Bildzusammenfassung“ kann sehr Unterschiedliches bedeuten.
Ein Student möchte vielleicht eine Zusammenfassung einer fotografierten Lehrbuchseite. Ein Produktmanager benötigt möglicherweise die Kernbotschaft aus einem Dashboard-Screenshot. Ein Entwickler möchte eventuell eine API, die Text, Objekte und Labels über Tausende von Bildern hinweg erkennt.
Das sind nicht dieselben Aufgaben.
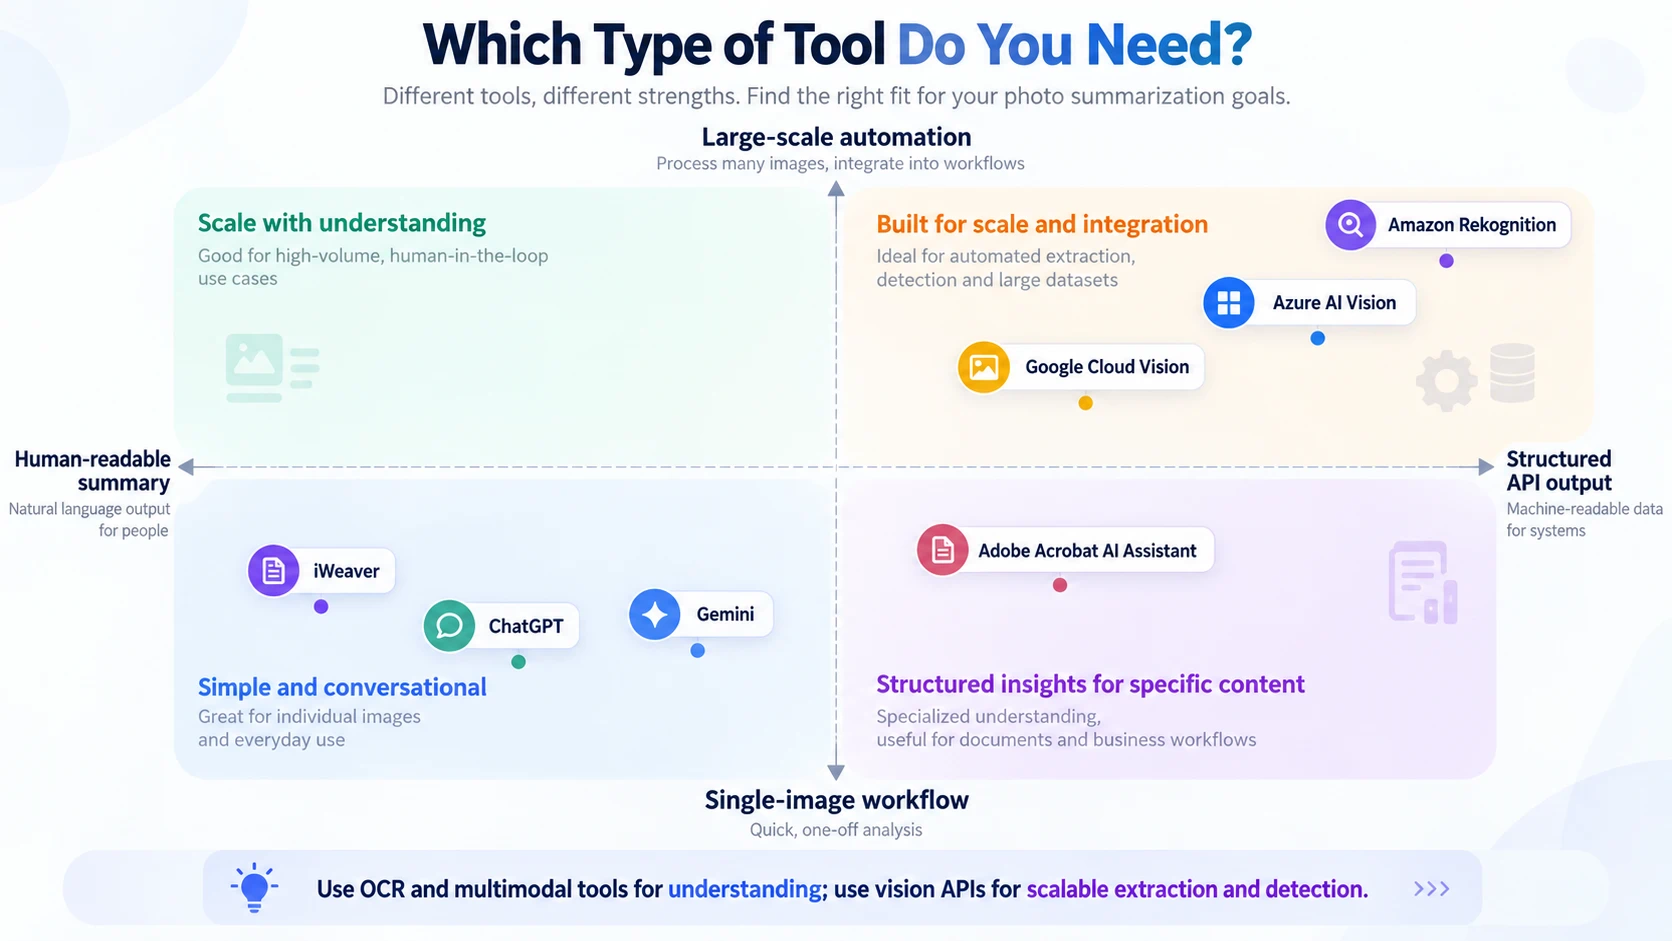
Das beste Tool für KI-Bildzusammenfassungen hängt daher davon ab, ob du eine lesbare Zusammenfassung in natürlicher Sprache, OCR, visuelles Reasoning oder eine strukturierte Ausgabe aus der Computer Vision brauchst.
Dieser Vergleich für 2026 trennt diese Anwendungsfälle, damit du die richtige Tool-Art wählen kannst.
Kurzer Vergleich
| Tool | Am besten für | Was es extrahieren kann | Beste Nutzergruppe |
|---|---|---|---|
| iWeaver | Strukturierte Bildzusammenfassungen | Text, visueller Kontext, Diagramme, Notizen | Knowledge Workers und Studierende |
| ChatGPT | Konversationsbasierte Bildanalyse | Text, Objekte, Diagramme, Screenshots | Allgemeine Nutzer |
| Gemini | Bild-Q&A und visuelles Verstehen | Fotos, Text, visueller Kontext | Allgemeine Nutzer |
| Adobe Acrobat AI Assistant | Gescannte Dokumente und PDF-Bilder | OCR plus Kontext auf Dokumentenebene | Nutzer mit vielen PDFs |
| Google Cloud Vision | OCR- und Machine-Vision-APIs | Text, Labels, Objekte, Landmarken | Entwickler |
| Azure AI Vision | OCR, Bildunterschriften, Bildanalyse | Text, Bildunterschriften, Objekte | Entwickler und Unternehmen |
| Amazon Rekognition | Bilderkennung in großem Maßstab | Labels, Objekte, Text, Moderationssignale | Entwickler und AWS-Teams |
1. iWeaver — Am besten für strukturierte Bildzusammenfassungen
iWeavers AI Image Summarizer ist für Menschen entwickelt, die ein Bild verstehen möchten – und nicht nur erkennen, was darin enthalten ist.
Du kannst ihn verwenden mit:
- Screenshots
- Diagrammen
- Visuellen Notizen
- Gescannter Seiten
- Infografiken
- Präsentationsfolien
- Bildern mit Text
Der entscheidende Unterschied ist die Ausgabe-Struktur. Statt nur OCR-Text oder Labels zurückzugeben, kann das Tool das Bild in Kernpunkte, Erklärungen, Notizen oder Antworten auf Nachfrage umwandeln.
Das macht es zu einer praktischen Option für Forschung, Lernen, Business-Reviews und Wissens-Workflows.
Wähle es, wenn: du eine lesbare Zusammenfassung möchtest, mit der du weiterarbeiten kannst.
2. ChatGPT — Am besten für konversationsbasierte Bildanalyse
ChatGPT kann hochgeladene Bilder analysieren und Fragen zum sichtbaren Inhalt beantworten.
Das ist hilfreich, wenn die erste Zusammenfassung zu weiteren Fragen führt.
Zum Beispiel:
Fasse dieses Dashboard in fünf Stichpunkten zusammen.
Dann:
Welche Kennzahl hat sich am stärksten verändert?
Dann:
Formuliere diese Erkenntnisse als kurze Aktualisierung für mein Team.
Der gleiche Ansatz funktioniert auch mit Diagrammen, Screenshots, fotografierten Dokumenten und vielen anderen visuellen Eingaben.
Seine Stärke liegt in der Flexibilität – nicht in einem festen Format für Bildzusammenfassungen.
Für details mit hoher Relevanz prüfe Zahlen, Labels und kleinen Text anhand des Originalbilds.
Wähle es, wenn: du ein Bild interaktiv besprechen und das Ergebnis in eine weitere Ausgabe umwandeln möchtest.
3. Gemini — Am besten für allgemeines Bild-Q&A
Gemini unterstützt Bild-Uploads und kann Fragen zu Fotos und visuellem Inhalt beantworten.
Für den Alltag eignet es sich damit für Aufgaben wie:
- Erklären, was ein Screenshot zeigt
- Text aus einem Bild lesen
- Eine fotografierte Seite zusammenfassen
- Sichtbare Elemente identifizieren
- Mehrere visuelle Details vergleichen
Das visuelle Ökosystem von Google profitiert außerdem von seiner langen Geschichte mit Lens und Bildverständnis.
Wie bei jedem multimodalen Assistenten sollte ein gutes Prompt Beobachtung und Interpretation trennen.
Teste:
Liste zuerst auf, was sichtbar vorhanden ist. Fasse dann die wichtigste Botschaft zusammen. Markiere jeden Text, den du nicht klar lesen kannst.
Wähle es, wenn: du für eine schnelle Analyse einen allgemeinen visuellen Assistenten brauchst.
4. Adobe Acrobat AI Assistant — Am besten für gescannte Dokumente
Ein „Foto“ ist oft eigentlich eine Dokumentseite, die als Bild erfasst wurde.
Wenn deine Eingabe ein gescanntes PDF, ein Bericht, ein Vertrag oder ein archiviertes Dokument ist, passt der Adobe Acrobat AI Assistant möglicherweise besser als ein allgemeiner Foto-Analyzer.
Der Workflow kombiniert OCR und Kontext auf Dokumentenebene. So können Nutzer vom gescannten Text zu Zusammenfassungen und Fragen wechseln, ohne die Datei in einzelne Bilder zu zerlegen.
Das ist besonders nützlich, wenn Seitenreihenfolge und Dokumentstruktur eine Rolle spielen.
Wähle es, wenn: deine Bilder vor allem Seiten innerhalb von PDFs sind.
5. Google Cloud Vision — Am besten für OCR und Bild-APIs
Google Cloud Vision ist kein Tool, das für Verbraucher Bildzusammenfassungen schreibt. Es ist ein Computer-Vision-Dienst für Entwickler.
Es kann gedruckten oder handschriftlichen Text erkennen und strukturierte Informationen zu Bildern zurückgeben – einschließlich Labels und weiterer visueller Signale.
Das macht es nützlich, wenn du deine eigene Zusammenfassungs-Pipeline aufbauen möchtest.
Ein typischer Workflow ist:
Bild → Cloud Vision OCR/Labels → strukturierte Daten → Sprachmodell → finale Zusammenfassung
So erhalten Entwickler Kontrolle über Extraktion, Speicherung, Confidence-Checks und die nachgelagerte Verarbeitung.
Das ist besonders hilfreich für Automatisierung im großen Maßstab, bei der ein manuelles Upload-Tool nicht praktikabel wäre.
Wähle es, wenn: du eine Anwendung entwickelst, die über eine API Bildverständnis benötigt.
6. Azure AI Vision — Am besten für Enterprise-Computer-Vision
Azure AI Vision stellt OCR- und Bildanalyse-Funktionen für Microsoft-orientierte Entwicklungsszenarien bereit.
Je nach verwendetem Service und Modell kann es Text extrahieren, visuelle Elemente identifizieren und beschreibende Informationen erzeugen, die in einen größeren KI-Workflow übergeben werden können.
Für Unternehmen liegt der Hauptwert in der Integration. Bildanalyse kann ein Baustein in einer breiteren Azure-Architektur werden – einschließlich Speicherung, Suche, Automatisierung und Sprachmodellen.
Das ist nicht dasselbe wie das Hochladen eines einzelnen Screenshots und das Erhalten einer polierten Studienzusammenfassung.
Wähle es, wenn: deine Organisation Bildverarbeitung in ein Azure-basiertes System einbaut.
7. Amazon Rekognition — Am besten für AWS-Workflows zur Bilderkennung
Amazon Rekognition ist eine weitere, entwicklerorientierte Option.
Es kann Labels, Objekte, Text und andere visuelle Signale über Bilder hinweg erkennen. Teams, die AWS bereits nutzen, können diese strukturierte Ausgabe mit Datenbanken, Moderationssystemen, Such-Pipelines oder Sprachmodellen verbinden.
Für „Zusammenfassung“ fungiert Rekognition meist eher als Wahrnehmungsschicht statt als finale Schreibschicht.
Dieser Unterschied ist wichtig. Eine Computer-Vision-API kann dir sagen, dass ein Bild eine Person, ein Fahrrad, eine Straße und Text enthält. Ein multimodales Sprachtool eignet sich besser, um diese Beobachtungen in eine Erklärung in natürlicher Sprache zu verwandeln.
Wähle es, wenn: du skalierbare Bildanalyse in einem AWS-Workflow brauchst.
Bildzusammenfasser vs. OCR-Tool: Was ist der Unterschied?
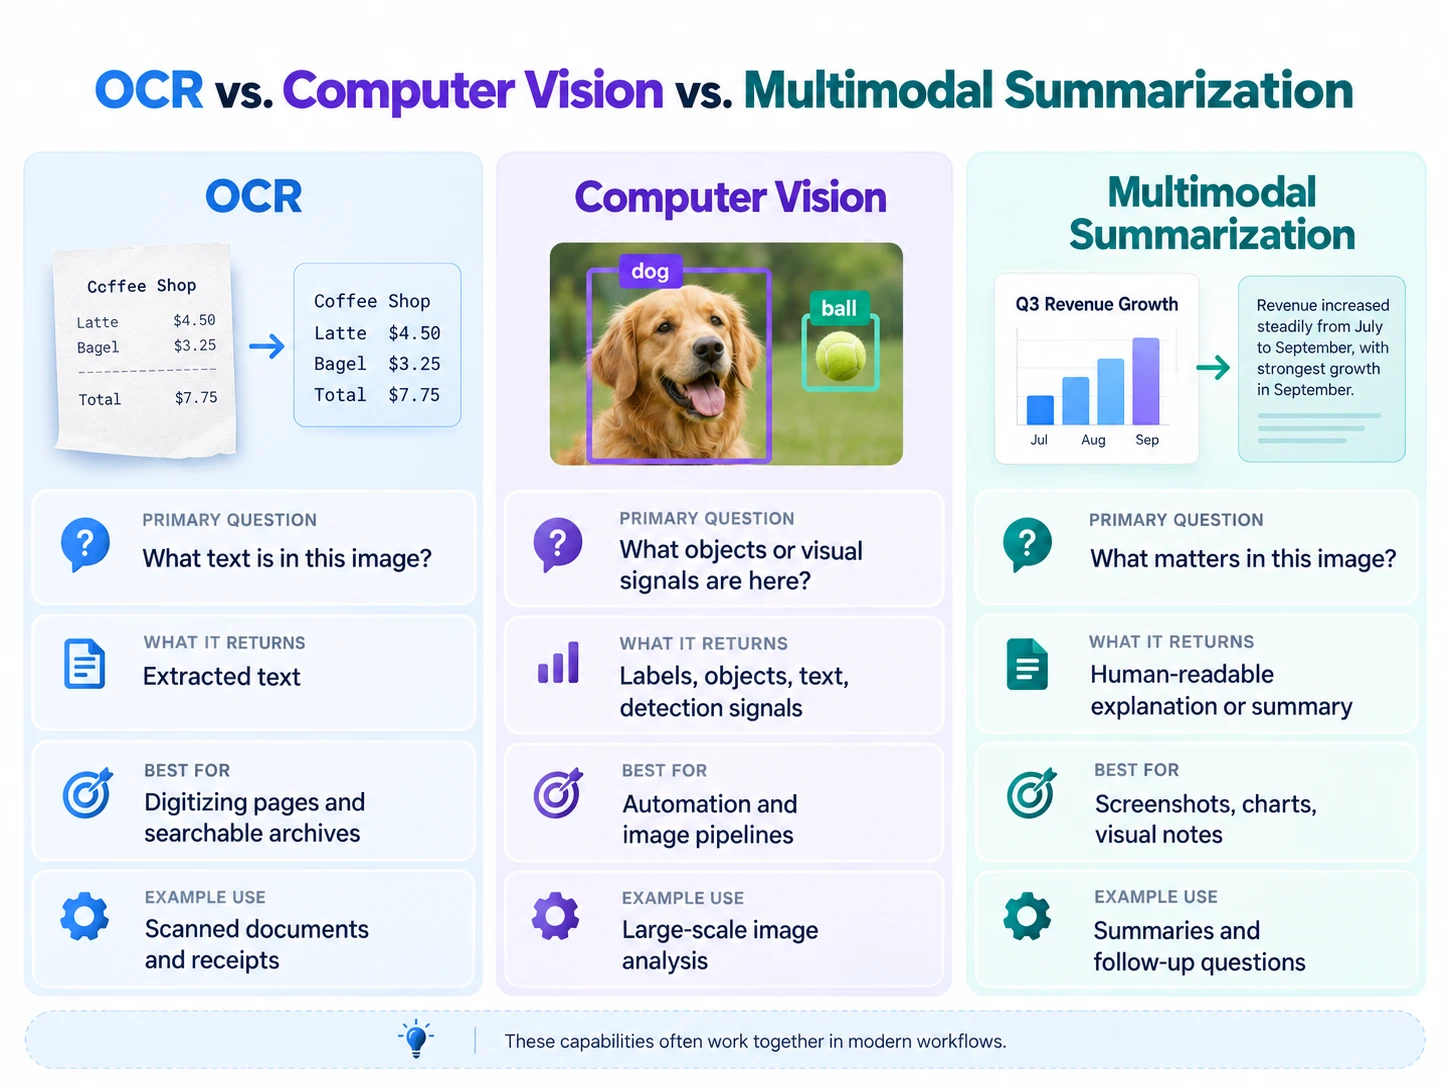
OCR beantwortet:
Welcher Text ist in diesem Bild?
Ein Bildzusammenfassungs-Tool antwortet:
Was ist an diesem Bild wichtig?
Ein multimodaler Assistent kann noch weiter gehen:
Was impliziert das Bild im Kontext meiner Frage?
Diese Fähigkeiten überschneiden sich, aber sie sind nicht identisch.
Wenn du nur gedruckten Text digitalisieren musst, kann OCR reichen. Wenn du eine prägnante Erklärung für einen Screenshot, ein Diagramm oder eine visuelle Notiz brauchst, nutze ein Tool, das sowohl Text als auch Layout versteht.
Für einen Schritt-für-Schritt-Workflow siehe so fasst du Text aus einem Bild zusammen.
So wählst du das richtige Tool
Stelle vier Fragen.
1. Ist die wichtige Information hauptsächlich Text?
Wenn ja, priorisiere die OCR-Qualität.
Für handschriftliches Material nutze einen spezialisierten AI Handwriting Recognition-Workflow oder ein anderes OCR-Tool, das für Handschrift entwickelt wurde.
2. Ist das Layout wichtig?
Für Diagramme, Dashboards, Slide-Decks und Infografiken reicht Textextraktion allein nicht.
Wähle ein multimodales Tool, das über Position, Labels, Legenden und visuelle Beziehungen reasonieren kann.
3. Brauchst du ein einzelnes Bild oder tausende?
Für gelegentliche manuelle Analysen ist ein nutzerorientierter Summarizer einfacher.
Für Tausende oder Millionen von Bildern ist eine API wie Google Cloud Vision, Azure AI Vision oder Amazon Rekognition passender.
4. Was brauchst du nach der Zusammenfassung?
Wenn du Folgefragen stellen möchtest, Bilder vergleichen, Notizen generieren oder Erkenntnisse in ein weiteres Dokument umwandeln willst, wähle ein Tool mit einem konversationsbasierten Workflow.
Wenn du nur strukturierte Labels für ein Softwaresystem brauchst, kann eine API ausreichen.
Prompt-Beispiele für bessere Bildzusammenfassungen
Für ein Dashboard:
Fasse das Dashboard in fünf Stichpunkten zusammen. Behalte den sichtbaren Datumsbereich und die exakten Kennzahlenwerte. Trenne Beobachtungen von möglichen Erklärungen.
Für eine gescannte Seite:
Extrahiere den Text und fasse dann die Hauptargumentation zusammen. Behalte Eigennamen, Daten und Zitate unverändert. Markiere unlesbaren Text, statt zu raten.
Für ein Diagramm:
Erkläre die Achsen, Gruppen, den Trend, die höchsten und niedrigsten Werte sowie alle sichtbaren Auffälligkeiten. Leite keine Kausalität aus Korrelationen ab.
Für eine Reihe von Screenshots:
Fasse zuerst jeden Screenshot einzeln zusammen. Identifiziere danach wiederkehrende Probleme, Unterschiede und die drei wichtigsten Schlussfolgerungen über alle Bilder hinweg.
Spezifische Prompts verringern die Wahrscheinlichkeit, dass das Tool sich auf visuell offensichtliche, aber unwichtige Details konzentriert.
Datenschutz ist wichtig
Bevor du ein Bild hochlädst, prüfe, was es außerdem enthält.
Screenshots können Namen, E-Mail-Adressen, interne Dashboards, Kundendaten, Kontonummern oder private Nachrichten offenlegen.
Schneide Informationen zu oder schütze sie (redact), die für die Aufgabe nicht notwendig sind, und halte dich an die von deiner Organisation freigegebene Policy für den Umgang mit vertraulichen Daten bei solchen Bildern.
Das beste Tool für KI-Bildzusammenfassungen hängt vom Job ab.
Wähle iWeaver, ChatGPT oder Gemini, wenn du eine lesbare Erklärung und Follow-ups möchtest. Verwende Adobe, wenn die „Fotos“ eigentlich gescannte Dokumente sind. Wähle Google Cloud Vision, Azure AI Vision oder Amazon Rekognition, wenn du Bildverständnis in Software einbaust.
Der entscheidende Unterschied ist ganz einfach: OCR extrahiert Text, Computer Vision erkennt visuelle Elemente, und multimodale Zusammenfassungen machen aus diesen Signalen Bedeutung.