
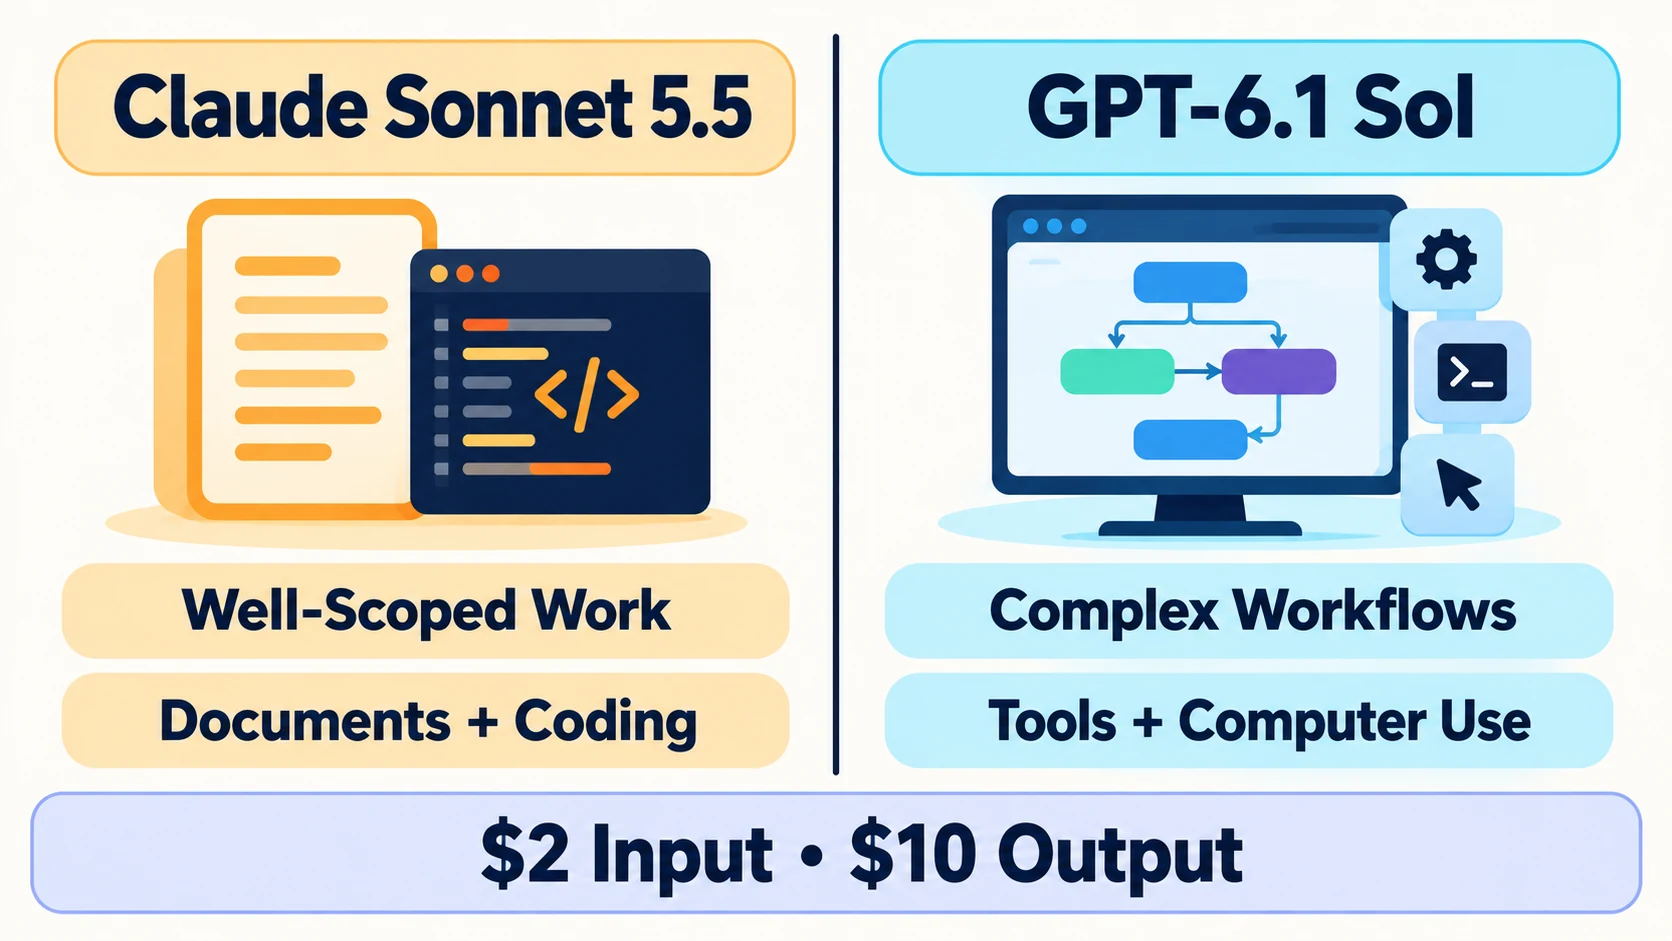
Claude Sonnet 5.5 und GPT-6.1 Sol haben die gleichen Standard-API-Tokenpreise, sind jedoch für unterschiedliche Stärken ausgelegt. Sonnet 5.5 ist für schnelles, gut abgegrenztes Programmieren und professionelle Aufgaben positioniert. GPT-6.1 Sol zielt auf komplexes Coding, Computer-Nutzung, toolgesteuerte Arbeit und professionelle Workflows – und bietet dabei eine nahezu-Astra-Leistung zu geringeren Kosten.
Die praktische Entscheidung hängt von der Aufgabe ab. Sonnet 5.5 verdient einen Test für abgegrenztes Coding, polierte Dokumente, Slides und Tabellen. GPT-6.1 Sol ist ein starker Kandidat, wenn du ein sehr großes Kontextfenster brauchst, die Responses-API-Tools von OpenAI oder einen mehrstufigen Workflow.
Claude Sonnet 5.5 vs GPT-6.1 Sol auf einen Blick
| Detail | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|
| Standard-Eingabepreis | $2 pro 1M Tokens | $2 pro 1M Tokens |
| Standard-Ausgabepreis | $10 pro 1M Tokens | $10 pro 1M Tokens |
| Cache-Read-Preis | $0.20 pro 1M Tokens | $0.10 pro 1M Tokens |
| Kontextfenster | Sieh die ausgewählte Claude-Plattform | 1,050,000 Tokens |
| Maximale Ausgabe | Sieh die ausgewählte Claude-Plattform | 128,000 Tokens |
| Ausgewiesener Fokus | Gut abgegrenztes Coding und professionelle Aufgaben | Komplexes Coding, Computer-Nutzung und professionelles Arbeiten |
| Reasoning-Steuerung | Anpassbarer Aufwand | Niedrig, mittel, hoch, xhigh und max |
| API-Modellname | claude-sonnet-5-5 |
gpt-6.1-sol |
Die GPT-6.1-Sol-Zahlen stammen aus OpenAIs Modell-Dokumentation. Preisgestaltung und Positionierung von Sonnet 5.5 stammen aus Anthropics Ankündigung zur Veröffentlichung. Long-Context-Preise, Batch-Verarbeitung, Fast-Modes, Cache-Writes, Tool-Calls und die Bedingungen des Cloud-Anbieters können die finalen Kosten verändern.
Coding: Scope Control ist genauso wichtig wie rohe Leistungsfähigkeit
Anthropic positioniert Sonnet 5.5 als schnelles Modell für den alltäglichen professionellen Einsatz, Bugfixes und klar abgegrenzte Aufgaben. In den Veröffentlichungsunterlagen werden starke Coding-Ergebnisse genannt – darunter 70,6% auf Terminal-Bench 4.0 und 46,2% bei Max effort auf FrontierCode 1.1 Main.
GPT-6.1 Sol ist für komplexes Coding und agentenartiges Arbeiten positioniert. OpenAI stellt ihm außerdem den Zugriff auf Codeausführung, gehostete Shell, Apply-Patch, Computer-Nutzung und weitere Tools über die Responses API bereit.
Diese Fakten belegen keinen universellen Sieger. Eine Coding-Auswertung sollte die gleiche Repository-Issue, Anweisungen, Umgebung und das gleiche Zeitbudget verwenden. Prüfe, ob das Modell die richtige Ursache gefunden hat, nur die notwendigen Dateien geändert, passende Checks ausgeführt und gestoppt hat, sobald die Aufgabe erledigt war.
Wähle Sonnet 5.5 für einen Test, wenn die Aufgabe abgegrenzt ist und schnelle Iterationen zählen. Wähle GPT-6.1 Sol für einen Test, wenn der Job einen breiteren Repository-Kontext, Tool-Koordination oder mehrere Implementierungs- und Verifikationsstufen erfordert.
Dokumente und Wissensarbeit
Sonnet 5.5 ist ausdrücklich dafür positioniert, hochwertige Dokumente, Slides und Tabellen zu erstellen. Das Veröffentlichungsergebnis von Anthropic betont außerdem professionelle Wissensarbeit und eine verbesserte Effizienz im Vergleich zu Sonnet 5.
GPT-6.1 Sol bietet ein dokumentiertes Kontextfenster von 1.050.000 Tokens und bis zu 128.000 Output-Tokens. Das macht es zu einer interessanten Option für große Dokumentensammlungen, das Synthesieren von Recherchen, die Prüfung von Policy-Dokumenten und detaillierte strukturierte Deliverables.
Allein die Kontextkapazität beweist noch keine Dokumentqualität. Teste beide Modelle mit demselben Quellpaket und bitte sie, Zahlen zu extrahieren, widersprüchliche Passagen abzugleichen, Belege von Schlussfolgerungen zu trennen und aufzuzeigen, woher jede Erkenntnis stammt. Das Modell, das ein besser nachvollziehbares Ergebnis liefert, kann wertvoller sein als das, das den flüssigeren ersten Entwurf schreibt.
Tools und Workflow-Passung
Der deutlichste Vorteil von GPT-6.1 Sol ist die dokumentierte Tool-Oberfläche über die Responses API. Es unterstützt Websuche, Dateisuche, Bildgenerierung, Codeausführung, gehostete Shell, Computer-Nutzung, MCP sowie Tool-Suche. Das kann die Integrationshürden für Teams reduzieren, die bereits auf OpenAIs Agent-Stack aufbauen.
Sonnet 5.5 ist über Claude-Produkte, die Claude Platform, AWS, Google Cloud und Microsoft Azure verfügbar. Es passt möglicherweise natürlicher, wenn eine Organisation diese Umgebungen bereits nutzt oder Prompts und Evaluierungen für Claude entsprechend angepasst sind.
Die Plattform rund um das Modell ist entscheidend. Logging, Berechtigungen, Source-Management, Review-Schritte, Datenanforderungen und Team-Workflow können einen kleinen Unterschied in einem Benchmark überwiegen.
Leser, die die frühere Baseline sehen möchten, können sich vor der Bewertung dessen, was das 6.1-Update verändert, iWeavers veröffentlichten Claude Sonnet 5.5 vs GPT-6 Vergleich ansehen.
Kosten: Gleicher Token-Preis, unterschiedliche Task-Kosten
Beide Modelle listen Standardpreise von $2 pro Million Input-Tokens und $10 pro Million Output-Tokens. Das heißt jedoch nicht, dass sie für eine Aufgabe die gleichen Kosten verursachen.
Die Gesamtkosten einer Aufgabe beinhalten Prompt-Größe, Cache-Verhalten, Reasoning-Aufwand, Tool-Calls, Retries, Output-Länge und menschliches Review. Anthropic sagt, dass Sonnet 5.5 weniger Tokens verwenden und schneller laufen kann als Sonnet 5. Das ist jedoch ein Vergleich mit dem Vorgänger – kein Beleg dafür, dass es günstiger als GPT-6.1 Sol ist.
Messe die gesamten Kosten, um zu einem akzeptablen Ergebnis zu kommen. Ein Modell, das weniger Korrekturen benötigt, kann günstiger sein – selbst wenn eine einzelne Antwort länger ausfällt.
Welches Modell solltest du wählen?
Teste Claude Sonnet 5.5, wenn deine Priorität gut abgegrenztes Coding, schnelle Iterationen oder polierte Dokumente und Office-ähnliche Outputs sind. Die stärksten öffentlichen Belege und die Produktpositionierung passen genau zu diesen Aufgaben.
Teste GPT-6.1 Sol, wenn du ein großes Kontextfenster, OpenAIs Tool-Ökosystem, komplexe Multi-Step-Arbeit oder eine günstigere Alternative zu Astra brauchst. Es ist außerdem die natürlichere Option, wenn deine Anwendung bereits von der Responses API abhängt.
Für eine faire Entscheidung solltest du drei repräsentative Aufgaben statt eines generischen Prompts testen: eine Routineaufgabe, eine schwierige Aufgabe und eine quellintensive Aufgabe. Bewerte Korrektheit, Vollständigkeit, Latenz, gesamte Tokens, unnötige Änderungen und Review-Zeit.
Du kannst eine kostenlose Testversion von GPT-6.1 Sol in iWeaver starten und es mit deinen eigenen Dokumenten oder deinem Research-Workflow evaluieren. Das beste Modell ist das, das deinen Qualitätsstandard mit dem geringsten gesamten Aufwand erfüllt – nicht das mit der lautesten Headline.