
GPT-6.1 Sol ist das ausgewogene Modell von OpenAI für komplexes Coden, Computer-Nutzung und professionelle Arbeit. OpenAI positioniert es als Anbieter von nahezu-Astra-Leistung zu einem niedrigeren Preis – die praktische Mittelwahl für alle, die mehr als ein leichtgewichtiges Modell brauchen, aber nicht für jede einzelne Aufgabe die Kosten von Astra tragen möchten.
iWeaver bietet jetzt eine kostenlose Testphase für GPT-6.1 Sol, die Nutzern einen direkten Weg gibt, das Modell vor der Entscheidung, wie es in ihren Arbeitsablauf passt, anhand von Forschung, Dokumenten, Texten, Analysen und weiteren Knowledge-Work-Aufgaben zu testen.
GPT-6.1 Sol im Überblick
| Detail | GPT-6.1 Sol |
|---|---|
| Am besten geeignet für | Komplexes Coden, Computer-Nutzung, Forschung und professionelle Arbeit |
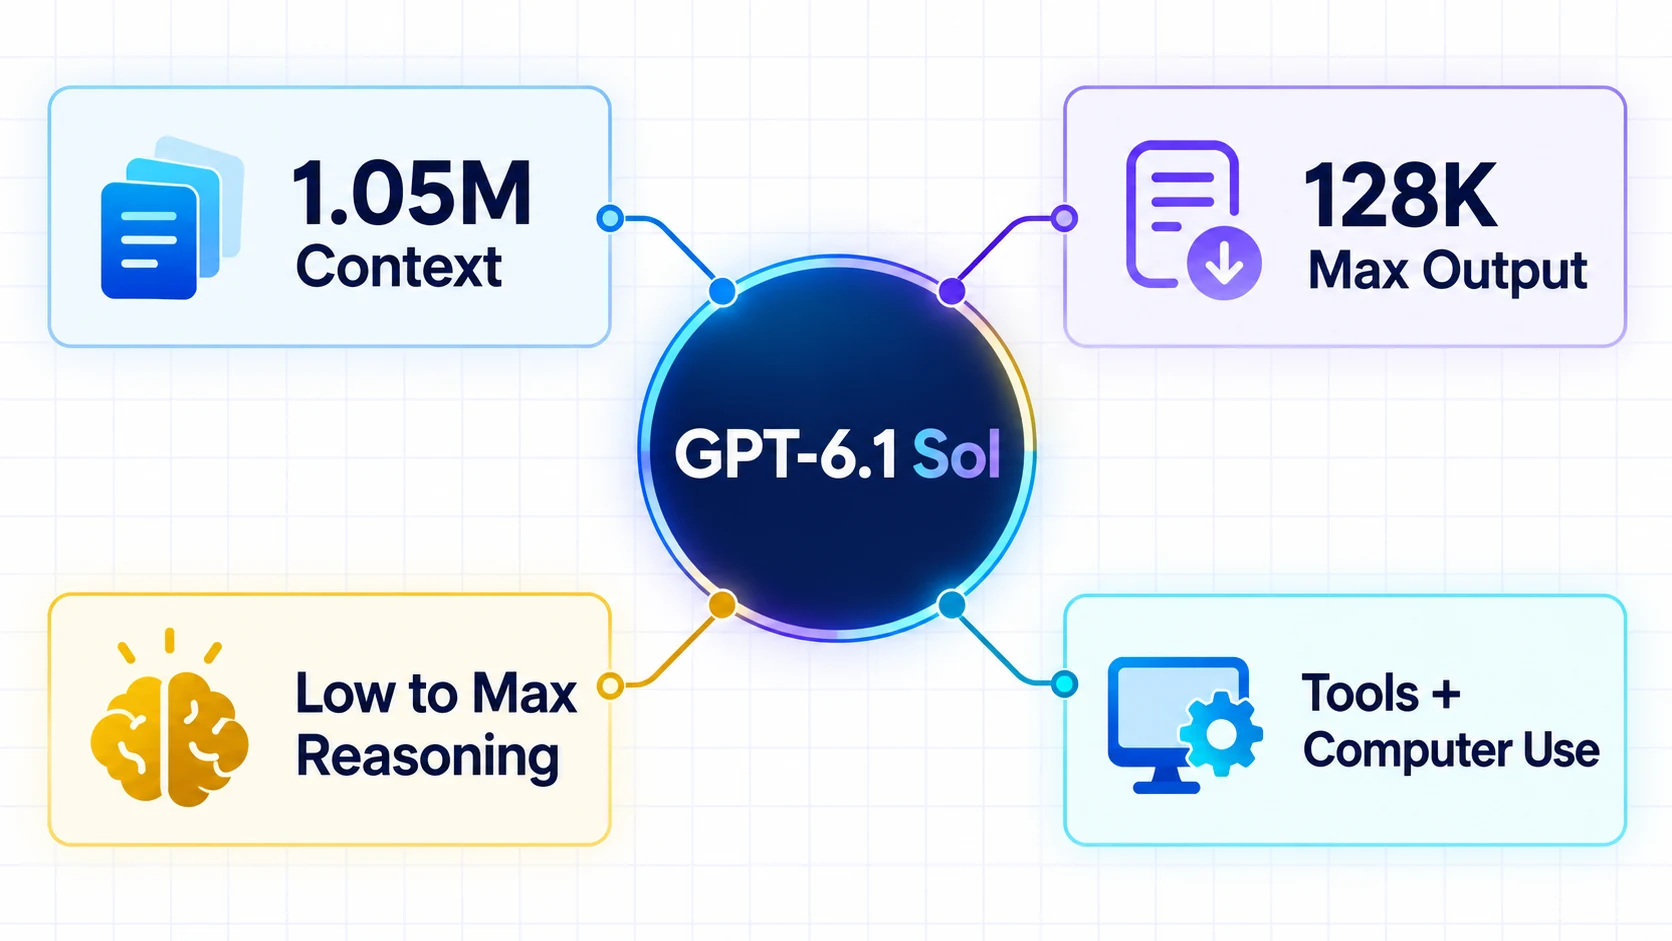
| Kontextfenster | 1.050.000 Tokens |
| Max. Ausgabe | 128.000 Tokens |
| Wissensstand | 30. April 2026 |
| Bild-Eingabe | Unterstützt |
| Audio- und Video-Eingabe | Nicht unterstützt |
| Reasoning-Aufwand | low, medium, high, xhigh und max |
| Standard-API-Eingabepreis | 2 $ pro 1 Mio. Tokens |
| Standard-API-Ausgabepreis | 10 $ pro 1 Mio. Tokens |
| Feintuning | Nicht unterstützt |
Diese Spezifikationen stammen von der offiziellen GPT-6.1 Sol-Modellseite. API-Preise können sich bei Long-Context-Prompts, im jeweiligen Verarbeitungsmodus, bei Caching, je nach Region sowie bei Tool-Aufrufen ändern. Daher sind die Standard-Tokenraten nur ein Ausgangspunkt für Kostenschätzungen.
Was ist neu an GPT-6.1 Sol?
GPT-6.1 Sol nimmt den Platz zwischen GPT-6 Astra und GPT-6 Luna ein. Astra ist für die anspruchsvollste Ende-zu-Ende-Arbeit gedacht, während Luna effiziente, hochvolumige Aufgaben priorisiert. Sol zielt darauf ab, einen Großteil der Fähigkeiten von Astra zu behalten – allerdings zu einem deutlich niedrigeren Token-Preis.
Für mehr Kontext zur oberen Stufe lies den früheren GPT-6 Astra-Überblick von iWeaver, der erklärt, welche Rolle Astra bei anspruchsvoller Ende-zu-Ende-Arbeit spielt.
Das Modell ist für Arbeit gebaut, die mehrere verbundene Schritte umfasst – statt nur eine einzelne kurze Antwort. Beispiele sind das Durchsehen einer großen Dokumentensammlung, die Untersuchung eines technischen Problems, das Koordinieren von Tools, das Erstellen eines strukturierten Berichts oder das Bearbeiten einer Coding-Aufgabe von der Diagnose bis zur Verifikation.
„Near-Astra performance“ ist die Produktpositionierung von OpenAI – keine Garantie, dass Sol Astra bei jeder Eingabe entspricht. Die entscheidende Frage lautet, ob Sol die Akzeptanzkriterien für deine eigene Aufgabe zu geringeren Gesamtkosten erfüllt.
Ein Kontextfenster mit 1,05 Mio. Tokens
GPT-6.1 Sol unterstützt ein Kontextfenster von 1.050.000 Tokens. Das schafft Platz für große Codebasen, lange Reports, mehrere Papers, Transkripte, Policy-Dokumente oder eine erweiterte Projekt-Historie.
Ein großes Kontextfenster bedeutet nicht, dass jede hochgeladene Detailinformation automatisch gleich stark berücksichtigt wird. Bessere Ergebnisse hängen weiterhin von einer klaren Quellenorganisation und einer präzisen Anfrage ab. Bei einer großen Dokumentenaufgabe gib dem Modell:
- Welche Dateien maßgeblich sind.
- Welche Fragen es beantworten muss.
- Welches Belegmaterial es zitieren oder referenzieren soll.
- Wie die Ausgabe strukturiert sein sollte.
- Welche Unsicherheiten es kennzeichnen soll – statt zu raten.
iWeaver ergänzt hierzu einen praxisnahen Workflow. Du kannst Quellmaterial in einem Workspace zusammenführen, die gewünschte Ausgabe definieren und das Ergebnis weiter verfeinern, anstatt das Modell als reine One-Shot-Chatbox zu behandeln.
Reasoning-Aufwand: von Low bis Max
GPT-6.1 Sol unterstützt fünf Stufen für den Reasoning-Aufwand: low, medium, high, xhigh und max. „Medium“ ist die dokumentierte Standardeinstellung.
Ein niedrigerer Aufwand kann für routinemäßiges Extrahieren, Umformulieren, Klassifizieren und klar abgegrenzte Fragen passend sein. Ein höherer Aufwand ist eher sinnvoll, wenn eine Aufgabe Planung erfordert, widersprüchliche Belege abgleichen muss, komplexes Debugging umfasst oder eine sorgfältige Analyse über mehrere Schritte benötigt. Mehr Reasoning ist nicht automatisch besser: Es kann Latenz und Kosten erhöhen, ohne eine einfache Antwort wirklich zu verbessern.
Das Modell unterstützt keinen none- oder minimal-Reasoning-Aufwand. Entwickler, die eine Anwendung migrieren, sollten außerdem beachten, dass Tool-Aufrufe in der Responses API beheimatet sind. Chat Completions wird nur für Anfragen ohne Tools unterstützt.
Was kann GPT-6.1 Sol?
Dokumente und Forschung analysieren
Das Modell kann über lange Quellensammlungen hinweg arbeiten, Behauptungen extrahieren, Abschnitte vergleichen, Widersprüche identifizieren und strukturierte Ausgaben erzeugen. Das Ergebnis braucht jedoch weiterhin eine Quellprüfung, wenn Genauigkeit entscheidend ist.
Komplexe Coding-Aufgaben bewältigen
GPT-6.1 Sol ist für Software-Arbeit konzipiert, die Repository-Kontext, Tool-Nutzung, mehrere Änderungen und Verifikation erfordert. Eine gute Bewertung sollte Korrektheit, unnötige Änderungen, Testergebnisse, benötigte Zeit und den Aufwand für Reviewer messen – nicht nur, ob das Modell Code erzeugt hat.
Tools koordinieren
Über die Responses API unterstützt GPT-6.1 Sol Tools einschließlich Websuche, Dateisuche, Code-Ausführung, Computer-Nutzung, Bildgenerierung, MCP und Tool-Suche. Verfügbarkeit und Gebühren können je nach Tool und Umgebung variieren.
Professionelle Ergebnisse erstellen
Das Modell kann dabei helfen, Quellmaterial in Reports, Briefs, Pläne, Tabellen und strukturierte Entwürfe zu verwandeln. Die große maximale Ausgabe unterstützt umfangreiche Deliverables. Für gewöhnlich sind jedoch knappe Prompts und eine stufenweise Überprüfung verlässlicher als der Wunsch nach einer riesigen Endantwort in einem einzigen Durchlauf.
Grenzen von GPT-6.1 Sol
GPT-6.1 Sol kann weiterhin eine Quelle falsch lesen, eine Ausnahme übersehen, falschen Code erzeugen oder eine Schlussfolgerung zu selbstbewusst formulieren. Auch der Wissensstand bedeutet: Aktuelle Informationen erfordern möglicherweise Browsing oder die Bereitstellung entsprechend aktueller Quellen.
Bei wichtigen Aufgaben solltest du Zitate, Berechnungen, Zitationen, Code-Ausführung und geschäftliche Schlussfolgerungen verifizieren. Betrachte das Modell als kompetenten Worker in einem überprüfbaren Prozess – nicht als letzte Instanz.
So probierst du GPT-6.1 Sol aus
Der schnellste Weg, das Modell zu bewerten, ist eine Aufgabe zu verwenden, deren korrektes Ergebnis du bereits verstehst. Wähle einen echten Report, eine Forschungsfrage, einen Dokumentensatz oder ein Coding-Problem und definiere, was eine erfolgreiche Antwort enthalten muss.
Du kannst GPT-6.1 Sol mit einer kostenlosen Testphase in iWeaver ausprobieren. Füge dein Quellmaterial hinzu, beschreibe das erforderliche Ergebnis und vergleiche die Ausgabe mit deinem normalen Workflow. Beurteile sie nach Genauigkeit, Vollständigkeit, eingesparter Zeit und wie viel Review das Ergebnis benötigt.
Eine solche Bewertung auf Aufgabenebene sagt dir mehr als nur ein Benchmark-Score – und hilft dir zu entscheiden, wann Sol ausreicht und wann eine andere Modellstufe sinnvoll ist.