
Kimi K3.1 Pro ist das erste Modell in der K3.1-Serie von Moonshot AI. Es kombiniert ein Modell der 3-Billionen-Klasse mit einem Kontextfenster von einer Million Tokens und nativer visueller Verstehen. Die Veröffentlichung konzentriert sich auf Coding-, 3D-Erstellungs- und Forschungsaufgaben, die mehrere Schritte erfordern. Eine zweite Version, K3.1 Pro Highspeed, priorisiert schnellere Antworten.
Für Leser, die entscheiden, ob sie es ausprobieren möchten, ist die hilfreiche Frage, welcher Teil ihrer Arbeit verbessert werden muss: das Denken über eine große Quellensammlung, das Durchführen einer Aufgabe durch mehrere Überarbeitungen oder das Verringern der Wartezeit zwischen Iterationen.
Kimi K3.1 Pro ist jetzt in iWeaver verfügbar, und iWeaver bietet eine kostenlose Testphase für das Modell. Hier ist eine praktische Vorgehensweise, um es anhand der relevanten Veröffentlichungsdetails gemeinsam mit der Evaluation einzuordnen.
Was ändert sich mit K3.1 Pro?
Verwendest du bereits das vorherige Modell? Sieh dir Kimi K3.1 Pro vs. Kimi K3 an, um eine Entscheidungsgrundlage für das Upgrade zu bekommen.
Kimi beschreibt K3.1 Pro als eine nachtrainierte Version von K3 – mit mehr Nachtrainings-Compute. Die Release-Beispiele decken Softwareentwicklung, parametrisches 3D-Modelling und dokumentenbasiertes finanzielles Research ab. Vollständige Modellgewichte sind für die Veröffentlichung bis zum 4. November 2026 geplant; gehosteter Zugriff und herunterladbare Gewichte haben jeweils separate Zeitpläne.
Diese Unterscheidung ist wichtig, wenn du eine lokale Bereitstellung planst. Du kannst ein gehostetes Modell evaluieren, bevor seine Gewichte eintreffen, aber eine gehostete Evaluation stellt nicht die Hardware, die Lizenzbedingungen oder die Bereitstellungskosten für ein zukünftiges lokales Setup fest.
Für alltägliche Wissensarbeit ist die Veröffentlichung ein guter Anlass, eine schwierige Aufgabe zu testen, die du bereits verstehst. Eine vertraute Aufgabe gibt dir einen Referenzpunkt: Du kannst erkennen, wenn eine Qualifikation fehlt, eine Rechnung falsch ist oder ein Schluss über die Evidenz hinausgeht.
Eine Million Tokens hilft nur, wenn die Quellen helfen
Ein großes Kontextfenster schafft Platz für mehr Material. Es sagt jedoch nicht, ob jede relevante Passage korrekt verwendet wird.
Stell dir vor, du bereitest ein Produkt-Research-Briefing anhand von Interviewnotizen, einem Anforderungsskript und einem Wettbewerberbericht vor. Die Bitte um „eine umfassende Analyse“ lässt mehrere Entscheidungen offen: Welche Evidenz ist relevant, wie sollen Konflikte behandelt werden, und was soll das finale Briefing enthalten.
Eine sinnvollere Anfrage definiert diese Entscheidungen:
Vergleiche das Anforderungsskript mit den Interviewnotizen. Identifiziere jedes unterstützte Kundenbedürfnis, zitiere die relevante Passage aus der Quelle und markiere Anforderungen, denen die Interview-Evidenz fehlt. Beende mit drei Fragen für die nächste Research-Runde.
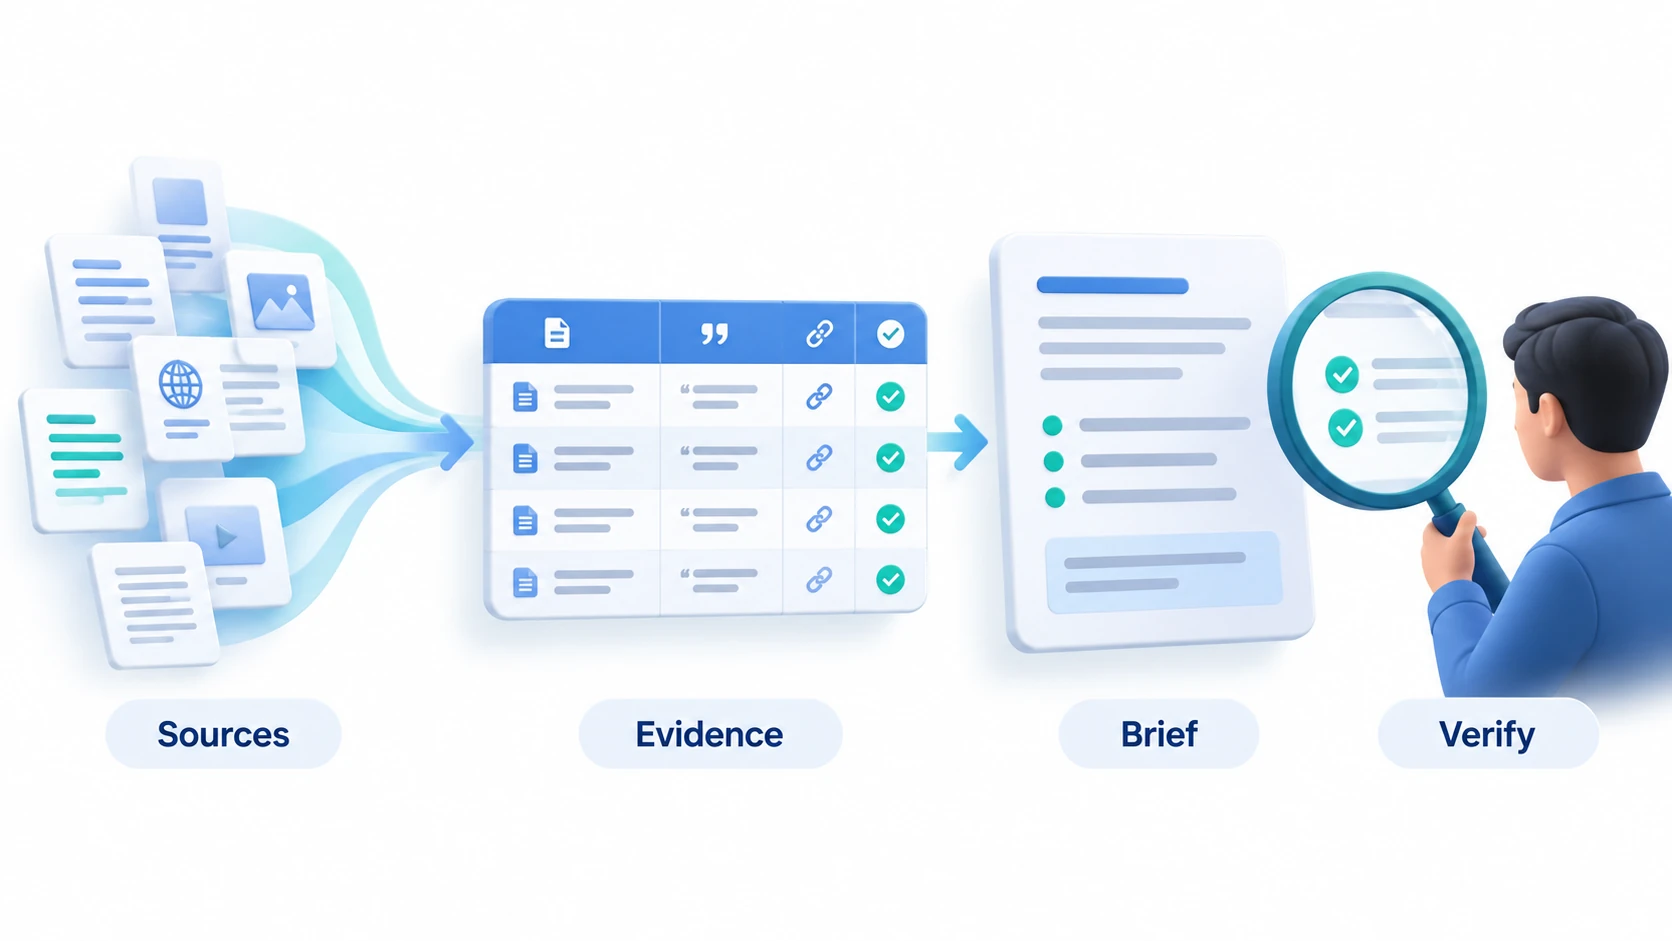
Der Nutzen, Quellen beisammenzuhalten, liegt in der Möglichkeit, sie zu vergleichen. Beurteile das Ergebnis daran, ob es die richtigen Beziehungen findet und Ausnahmen beibehält – nicht daran, wie viel Text es produziert.
Bevor du eine Sammlung hochlädst, entferne Duplikate und kennzeichne die verbleibenden Dateien. Halte Daten und Versionen sichtbar. Wenn zwei Berichte sich widersprechen, fordere das Modell auf, den Widerspruch darzustellen, bevor du eine Synthese versuchst.
K3.1 Pro vs. Highspeed: Was solltest du wählen?
Für einen tieferen Blick auf die Antwortgeschwindigkeit und die Ausgaben lies Kimi K3.1 Pro vs. Highspeed.
Kimi positioniert Highspeed so, dass es die gleichen Fähigkeiten mit etwa dem 2- bis 3-fachen Output-Tempo bietet. Seine API-Plattform listet derzeit die folgenden US-Dollar-Raten pro Million Tokens:
| API-Rate | K3.1 Pro | K3.1 Pro Highspeed |
|---|---|---|
| Input | $2 | $4 |
| Output | $10 | $20 |
| Cache write | $2 | $4 |
| Cache hit | $0.20 | $0.20 |
Das sind API-Raten – getrennt von Consumer-Abonnements und den iWeaver-Testbedingungen.
Beginne mit dem regulären Modell, wenn du die Antwortqualität evaluierst. Ziehe Highspeed in Betracht, wenn wiederholtes Warten deine Arbeit unterbricht, etwa beim Durchsehen mehrerer aufeinanderfolgender Überarbeitungen. Vergleiche die Gesamtkosten der Aufgabe und die Abschlusszeit in deiner eigenen Arbeitslast; die Output-Speed-Angabe eines Anbieters beschreibt nicht jede Komponente einer tool-unterstützten Aufgabe.
Halte die Eingaben für deine Evaluation identisch. Wenn du Quellen und Prompt änderst, während du das Modell wechselst, ist es schwierig zu verstehen, wodurch sich der Unterschied ergeben hat.
So testest du Kimi K3.1 Pro in iWeaver
Für die vollständige Schritt-für-Schritt-Anleitung folge How to Use Kimi K3.1 Pro.
Nutze die kostenlose Testphase, um eine einzelne begrenzte Aufgabe zu erledigen, etwa dabei, eine kurze Sammlung von Projekt-Dokumenten in ein Entscheidungs-Briefing umzuwandeln. iWeaver unterstützt Dokumentanalyse, Zusammenfassungen und Mind Maps in seinem Knowledge-Workflow. Entdecke iWeaver.
1. Wähle Material, das du verifizieren kannst
Beginne mit zwei oder drei zusammenhängenden Dokumenten, deren Inhalt du kennst. Füge eine Quelle mit einer Ausnahme oder widersprüchlichen Details hinzu, damit die Aufgabe mehr testet als nur das Schreiben einer Zusammenfassung.
Für einen ersten Überblick nutze den AI Document Summarizer. Überprüfe die extrahierten Punkte, bevor du eine umfassendere Synthese anforderst.
2. Lege Output- und Evidenzregeln fest
Verwende Kimi K3.1 Pro in der verfügbaren Modell-Auswahl und fordere ein konkretes Deliverable an. Halte die erste Aufgabe klein genug, um sie vollständig prüfen zu können.
Zum Beispiel:
Verwende nur die bereitgestellten Dokumente und erstelle einen Entwurf für ein Projekt-Entscheidungs-Briefing. Füge die vorgeschlagene Entscheidung, die unterstützende Evidenz, ungelöste Konflikte und fehlende Informationen hinzu. Hänge eine Quellenreferenz an jede Tatsachenbehauptung an. Kennzeichne Vorschläge als Vorschläge. Wenn ein Detail fehlt, sag das.
Das ist ein vorgeschlagener Prompt für die Evaluation – keine Aussage, dass ein Modell jede Anweisung immer befolgt. Prüfe, ob die Referenzen die zugehörigen Behauptungen stützen.
3. Prüfe das Ergebnis, bevor du die Aufgabe ausweitest
Wähle mehrere Aussagen, einschließlich der folgenreichsten, und gehe zu den ursprünglichen Quellen zurück. Prüfe Daten, Einheiten, Zuordnung und Ausnahmen. Bitte das Modell, jede Passage zu überarbeiten, die die Evidenz überhöht.
Wenn du einen visuellen Überblick über ein Dokument brauchst, bietet der PDF-to-Mind-Map-Workflow eine weitere Möglichkeit, die wichtigsten Ideen zu strukturieren. Behandle die Map als Navigationshilfe und gehe für die detaillierte Verifikation zurück zur Quelle.
Sobald die kleine Aufgabe funktioniert, erweitere die Quellmenge oder die Komplexität des Outputs. So erhältst du einen klareren Blick darauf, wo der Workflow anfängt, mehr Anleitung zu benötigen.
Was Entwickler vor dem Verbinden prüfen sollten
Kimi Code verwendet die IDs k3.1-pro und k3.1-pro-highspeed. In der Dokumentation heißt es, dass K3.1 Pro Thinking Mode erfordert, und es wird empfohlen, beim Wechsel von einem älteren Modell eine frische Sitzung zu starten. Der Zugriff auf den Kontext hängt außerdem von der Mitgliedsstufe ab: Die beworbene maximale Kapazität ist nicht in jedem Plan verfügbar.
Vermeide es, Einstellungen aus einem anderen Zugriffskanal zu kopieren, ohne sie zu prüfen. Modell-IDs, Endpoints, Plan-Kontingente und Anwendungssteuerungen sollten aus der Dokumentation für den Service stammen, den du tatsächlich nutzt.
Für eine Coding-Evaluation definiere vor dem Lauf ein beobachtbares Ergebnis: einen fehlenden Test, der bestehen sollte, einen reproduzierbaren Bug, der verschwinden sollte, oder eine Funktion mit klaren Akzeptanzkriterien. Überprüfe ebenso die Änderungen wie die finale Erklärung.
Wie viel solltest du den Benchmark-Bestätigungen glauben?
Kimi berichtet Verbesserungen über Coding- und Knowledge-Work-Evaluationen hinweg. Dabei handelt es sich um vom Anbieter gemeldete Ergebnisse mit festgelegten Tools und Bewertungskonditionen; dieser Artikel stellt keinen unabhängigen Hands-on-Benchmark dar.
Für deine eigene Testphase halte vier Dinge fest: ob der Output korrekt ist, wie viel Korrektur er benötigt, wie lange die vollständige Aufgabe dauert und was es über deinen gewählten Zugangsweg kostet. Eine polierte erste Antwort kann dennoch umfangreiche Prüfungen erfordern.
K3.1 Pro lohnt sich zu evaluieren, wenn deine Arbeit das Vergleichen von Quellen beinhaltet oder eine komplexe Aufgabe durch mehrere Überarbeitungen führt. Bringe ein klares Deliverable, Evidenzregeln und ein Ergebnis mit, das du verifizieren kannst. Beginne in iWeaver mit einem Dokument-Workflow in der kostenlosen Testphase und erweitere dann auf Basis dessen, was das Modell tatsächlich liefert.