
Claude Opus 5.5 y la familia GPT-6 de OpenAI ahora compiten por muchas de las mismas cargas de trabajo exigentes de IA, pero con enfoques diferentes.
Anthropic sitúa Claude Opus 5.5 en torno a la programación de agentes de larga duración y el trabajo profesional basado en conocimiento. OpenAI divide GPT-6 en tres modelos: Astra para las tareas de extremo a extremo más difíciles, Sol para la codificación compleja y los agentes, y Luna para cargas de trabajo enfocadas y de alto volumen.
Así que la comparación útil ya no es simplemente Claude vs GPT.
Es:
Claude Opus 5.5 vs GPT-6 Astra, Sol y Luna: ¿qué modelo se ajusta a tu carga de trabajo real?
Claude Opus 5.5 vs GPT-6 de un vistazo
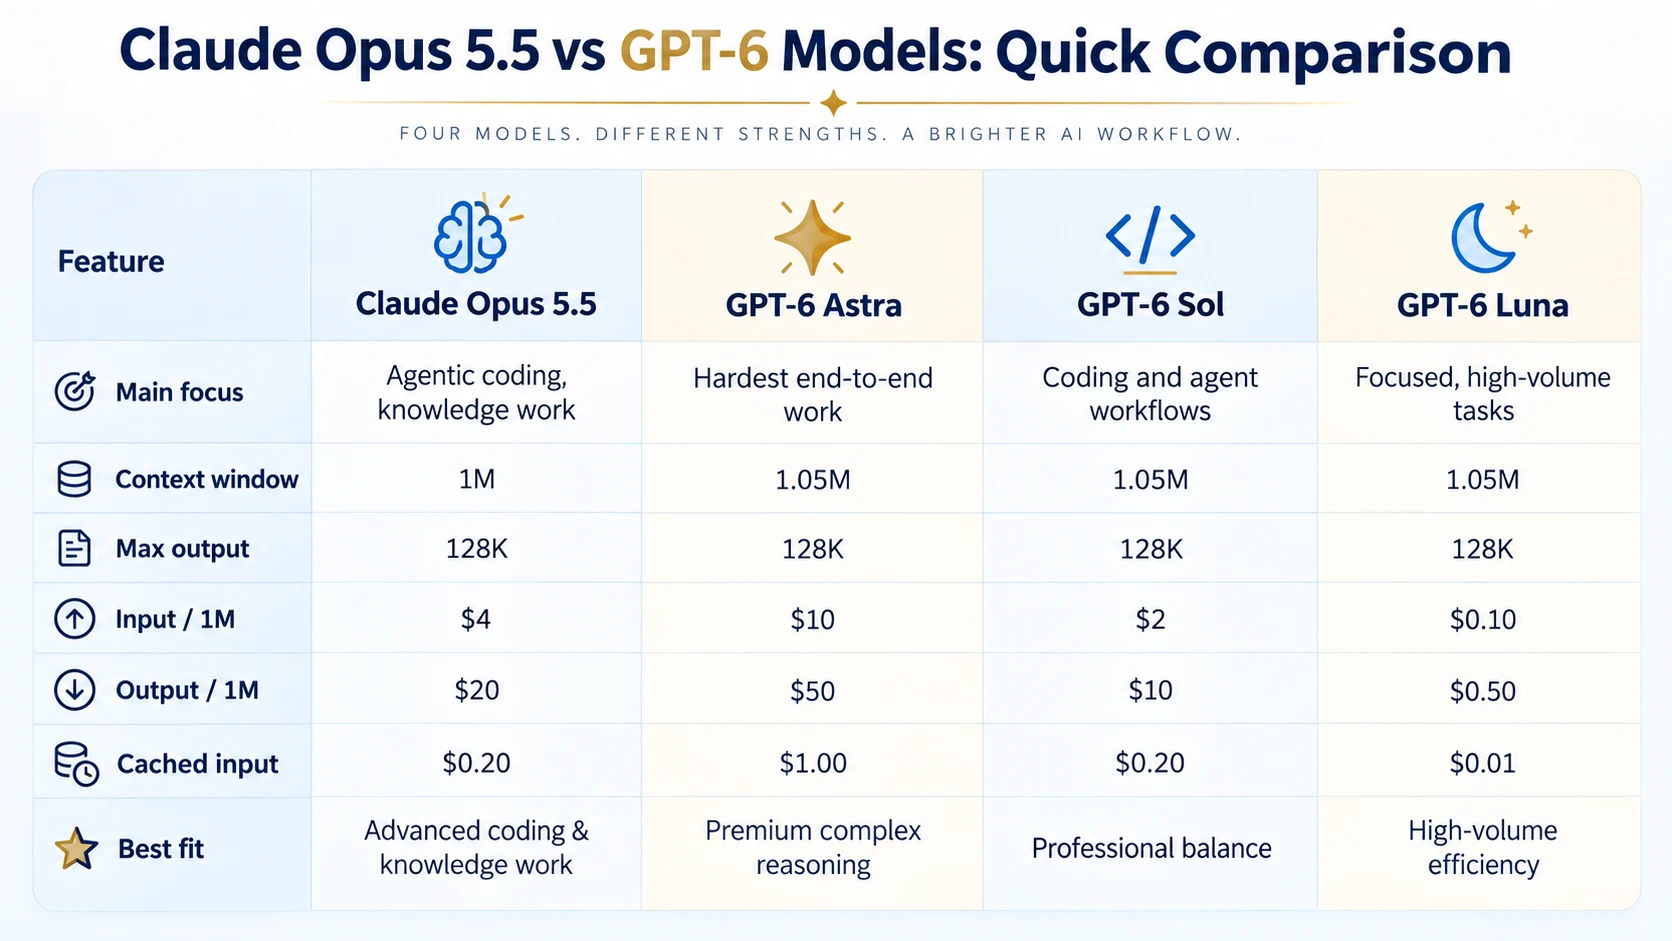
| Funcionalidad | Claude Opus 5.5 | GPT-6 Astra | GPT-6 Sol | GPT-6 Luna |
|---|---|---|---|---|
| Enfoque principal | Programación agente, trabajo de conocimiento | El trabajo de extremo a extremo más difícil | Codificación y flujos de trabajo de agentes | Tareas enfocadas y de alto volumen |
| Ventana de contexto | 1M | 1.05M | 1.05M | 1.05M |
| Salida máxima | 128K | 128K | 128K | 128K |
| Entrada / 1M | $4 | $10 | $2 | $0.10 |
| Salida / 1M | $20 | $50 | $10 | $0.50 |
| Entrada en caché | $0.20 | $1.00 | $0.20 | $0.01 |
| Corte de conocimiento | Junio 2026 | 30 abr. 2026 | 20 abr. 2026 | 18 may. 2026 |
Claude Opus 5.5 admite una ventana de contexto de 1M tokens y una salida estándar de 128K, mientras que los tres modelos GPT-6 ofrecen una ventana de contexto ligeramente mayor de 1.05M con la misma salida máxima de 128K.
Claude Opus 5.5 vs GPT-6 Astra
GPT-6 Astra es la comparación directa más cercana con Claude Opus 5.5 cuando la tarea implica razonamiento difícil, codificación, investigación o agentes de larga duración.
OpenAI describe Astra como su modelo más capaz para el trabajo de extremo a extremo más difícil, incluyendo razonamiento complejo, codificación, uso de computadora, investigación y creación de documentos. Anthropic describe Opus 5.5 como un modelo para la programación de agentes de larga duración y el trabajo de conocimiento.
La mayor diferencia práctica es el precio.
Claude Opus 5.5 cuesta:
- $4 / 1M tokens de entrada
- $20 / 1M tokens de salida
GPT-6 Astra cuesta:
- $10 / 1M tokens de entrada
- $50 / 1M tokens de salida
Con las tarifas estándar publicadas, Opus 5.5 cuesta, por lo tanto, un 60% menos por token de entrada y de salida que Astra.
Astra sí ofrece una ventana de contexto ligeramente mayor—1.05M frente a 1M—, pero esa diferencia es relativamente pequeña comparada con la brecha de precios.
¿Qué muestran los benchmarks?
Los resultados publicados de Opus 5.5 por Anthropic incluyen comparaciones directas con GPT-6 Astra.
En las pruebas de Anthropic, Opus 5.5 obtuvo mejores puntuaciones en benchmarks como Terminal-Bench 4.0 y FrontierCode v1.1, mientras que GPT-6 Astra salió mejor en pruebas como AutomationBench y Terminal-Bench-Science 0.1. Anthropic también señala que las diferencias entre benchmarks deben interpretarse con cuidado porque las condiciones de prueba y la incertidumbre estadística varían.
Eso hace difícil reducir la comparación a una sola puntuación general.
Para flujos de trabajo reales, la mejor prueba suele ser si el modelo puede completar tu tarea de codificación, investigación o de agente de forma fiable y cuánto cuesta esa tarea completa.
Claude Opus 5.5 vs GPT-6 Sol
GPT-6 Sol puede ser, en realidad, la alternativa más interesante a Opus 5.5 para muchos usuarios profesionales.
Ambos modelos están posicionados explícitamente alrededor de la codificación y los flujos de trabajo de agentes.
Pero sus precios varían:
| Modelo | Entrada / 1M | Salida / 1M |
|---|---|---|
| Claude Opus 5.5 | $4 | $20 |
| GPT-6 Sol | $2 | $10 |
GPT-6 Sol cuesta la mitad por token estándar de entrada y salida.
También ofrece una ventana de contexto de 1.05M frente a los 1M de Opus 5.5. Ambos admiten hasta 128K tokens de salida.
Esto hace que Sol merezca la pena para cargas de trabajo frecuentes como:
- Programación diaria
- Revisión de código
- Agentes de IA
- Flujos de trabajo basados en herramientas
- Investigación
- Análisis de documentos
- Automatización de procesos de negocio
Opus 5.5 se vuelve más interesante cuando quieres el razonamiento de clase Opus de Anthropic y su enfoque en tareas de agentes de larga duración, mientras que Sol se posiciona como una opción más orientada al costo para la codificación y las cargas de trabajo de agentes recurrentes.
Claude Opus 5.5 vs GPT-6 Luna
Claude Opus 5.5 y GPT-6 Luna apuntan a cargas de trabajo muy diferentes.
Luna es el modelo GPT-6 más eficiente de OpenAI para tareas enfocadas y de alto volumen. Su precio en la API es solo:
- $0.10 / 1M tokens de entrada
- $0.50 / 1M tokens de salida
Eso está muy por debajo del precio de Opus 5.5 ($4 / $20).
Luna tiene más sentido para tareas como:
- Clasificación
- Extracción de información
- Formateo
- Resúmenes cortos
- Procesamiento de contenido
- Automatización repetitiva
Opus 5.5 está orientado al extremo opuesto del espectro de carga de trabajo: codificación compleja, trabajo más profundo de conocimiento y tareas que pueden requerir razonamiento sostenido a lo largo de muchos pasos.
Así que esto es menos un concurso directo entre modelos y más decidir si una tarea necesita, en absoluto, un modelo avanzado de razonamiento.
Precios: dónde encaja cada modelo
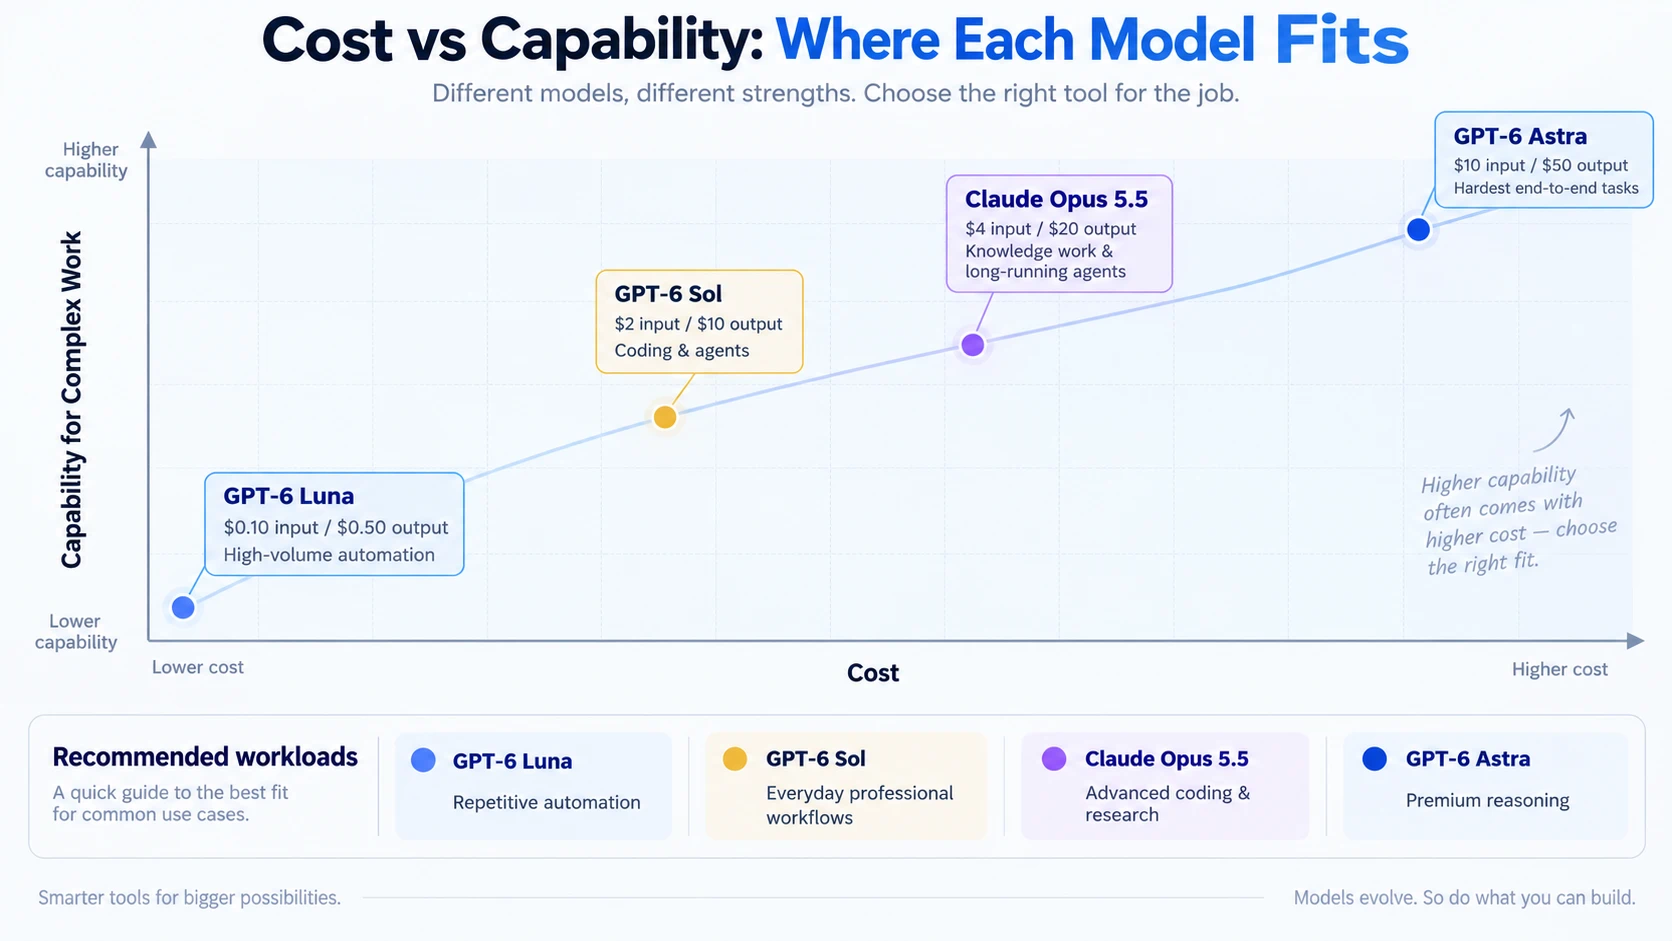
La escalera de precios deja el posicionamiento especialmente claro.
| Modelo | Entrada | Salida | Posición relativa |
|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.50 | Eficiencia para alto volumen |
| GPT-6 Sol | $2 | $10 | Equilibrio profesional |
| Claude Opus 5.5 | $4 | $20 | Codificación avanzada y trabajo de conocimiento |
| GPT-6 Astra | $10 | $50 | Razonamiento de extremo a extremo premium |
Estos son precios estándar publicados por token. OpenAI aplica precios más altos a las solicitudes de GPT-6 con más de 272K tokens de entrada, así que cargas de trabajo con contexto muy largo pueden cambiar el cálculo del costo.
Anthropic también admite almacenamiento en caché de prompts en Opus 5.5 a $0.20 por cada millón de tokens de lectura de caché, lo que puede importar para agentes que reutilizan repetidamente contextos grandes.
¿Qué modelo se ajusta a qué tarea?
Una forma práctica de comparar los cuatro modelos es por carga de trabajo, no por marca.
| Tarea | Modelos que merece la pena probar |
|---|---|
| Razonamiento difícil de extremo a extremo | Claude Opus 5.5 / GPT-6 Astra |
| Proyectos grandes de codificación | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Agentes de larga duración | Claude Opus 5.5 / GPT-6 Sol / Astra |
| Codificación profesional cotidiana | GPT-6 Sol / Claude Opus 5.5 |
| Investigación y trabajo de conocimiento | Claude Opus 5.5 / GPT-6 Astra / Sol |
| Extracción de alto volumen | GPT-6 Luna |
| Clasificación y formateo | GPT-6 Luna |
| Automatización repetitiva | GPT-6 Luna / Sol |
No hay razón para que cada paso de un flujo de trabajo tenga que usar el mismo modelo.
Un agente en producción podría usar Luna para extracción ligera, Sol para pasos de razonamiento regulares y derivar las tareas especialmente difíciles a Astra u Opus 5.5.
Eso puede importar más por costo que elegir un solo modelo para todo.
Prueba Claude Opus 5.5 y la serie GPT-6 en iWeaver
Las especificaciones y benchmarks son útiles, pero no siempre predicen qué modelo funcionará mejor con tus propios documentos, prompts o flujo de trabajo.
iWeaver te permite probar Claude Opus 5.5 junto con la serie GPT-6, incluyendo GPT-6 Astra, Sol y Luna, sin tener que crear integraciones de API separadas.
iWeaver también ofrece créditos diarios gratuitos, para que puedas probar la misma tarea real en distintos modelos—por ejemplo:
- Resumir PDFs
- Comparar varios documentos
- Investigación y análisis
- Escritura
- Extracción de conocimiento
- Preguntas de programación
Al ejecutar la misma tarea a través de varios modelos, es mucho más fácil comparar la profundidad de respuesta, la velocidad y la utilidad que confiar solo en números de benchmarks.
Si específicamente quieres empezar con el modelo insignia de OpenAI, consulta nuestra guía sobre cómo usar GPT-6 Astra gratis.
Claude Opus 5.5 ocupa una posición interesante dentro del mercado actual de modelos punteros.
Cuesta sustancialmente menos que GPT-6 Astra y, aun así, apunta a casos de uso de codificación, agentes y trabajo de conocimiento con demandas similares. GPT-6 Sol supera a Opus 5.5 en precio y se centra con fuerza en la codificación y los agentes, mientras que GPT-6 Luna cubre una necesidad totalmente distinta: procesamiento asequible a gran escala.
Por lo tanto, la pregunta útil no es simplemente “Claude Opus 5.5 o GPT-6?”
Sino si tu tarea necesita razonamiento de gama alta, rendimiento profesional equilibrado o eficiencia para alto volumen.
Por esa razón, probar el mismo flujo de trabajo con Opus 5.5, Astra, Sol y Luna suele ser más informativo que elegir solo a partir de tablas de benchmarks.