
Claude Sonnet 5.5 y Claude Opus 5.5 se distinguen menos por una simple jerarquía de “bueno frente a mejor” y más por la forma de la tarea. Anthropic posiciona Sonnet como la opción más rápida y de menor costo para el trabajo cotidiano bien delimitado, mientras que Opus está pensado para problemas complejos y abiertos que requieren un juicio cuidadoso a lo largo de muchos pasos. Sonnet cuesta la mitad por token estándar de entrada y salida; sin embargo, se queda sorprendentemente cerca de Opus en varias evaluaciones publicadas.
Un benchmark puede mostrar si un modelo tuvo éxito en un entorno controlado, pero quizá no capture qué tan consistentemente maneja la ambigüedad o mantiene en vista restricciones en competencia durante un proyecto largo. Elegir entre ambos es una decisión de enrutamiento: usa el modelo menos costoso que cumpla con los requisitos de calidad y riesgo de la tarea.
Sonnet 5.5 vs Opus 5.5 de un vistazo
| Detalle | Claude Sonnet 5.5 | Claude Opus 5.5 |
|---|---|---|
| Fecha de lanzamiento | 28 de septiembre de 2026 | 22 de septiembre de 2026 |
| Precio de entrada estándar | $2 por 1M tokens | $4 por 1M tokens |
| Precio de salida estándar | $10 por 1M tokens | $20 por 1M tokens |
| Precio de lectura de caché | $0.20 por 1M tokens | $0.20 por 1M tokens |
| Precio de escritura de caché | $2.50 por 1M tokens | $5 por 1M tokens |
| Rol declarado | Trabajo cotidiano rápido y bien delimitado | Trabajo complejo que requiere juicio sostenido |
| Nombre del modelo de la API | claude-sonnet-5-5 |
claude-opus-5-5 |
Las cifras anteriores provienen de los anuncios oficiales de Anthropic para Sonnet 5.5 y Opus 5.5. Son tarifas estándar de API; el modo rápido, la inferencia regional, las plataformas en la nube y el acceso por suscripción pueden seguir reglas de precios o uso diferentes.
Lo que realmente muestran los benchmarks
Sonnet 5.5 está cerca de Opus 5.5 en varias evaluaciones reportadas por Anthropic, pero la ventaja cambia según la tarea. Esa es precisamente la razón por la que los dos modelos no deberían reducirse a una sola puntuación.
| Benchmark | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| Terminal-Bench 4.0 | 70.6% | 66.4% |
| FrontierCode 1.1 Main | 46.2% en Max | 54.4% |
| CursorBench 4.0 | 55.5% | 57.8% |
| GDPval-AA v2.1 | 1844 | 1846 |
| AA-Briefcase v1.1 | 1811 | 1822 |
Sonnet lidera en el resultado publicado de Terminal-Bench, mientras que Opus lidera en FrontierCode, CursorBench, GDPval-AA y AA-Briefcase. La brecha mínima de GDPval-AA es destacable, pero Anthropic dice explícitamente que Opus sigue siendo claramente más fuerte en la experiencia propia y de testers externos en trabajos complejos y abiertos que requieren juicio sostenido. Las configuraciones de benchmark y los niveles de esfuerzo también difieren, así que una brecha numérica de dos puntos no debería confundirse con un veredicto completo de capacidad.
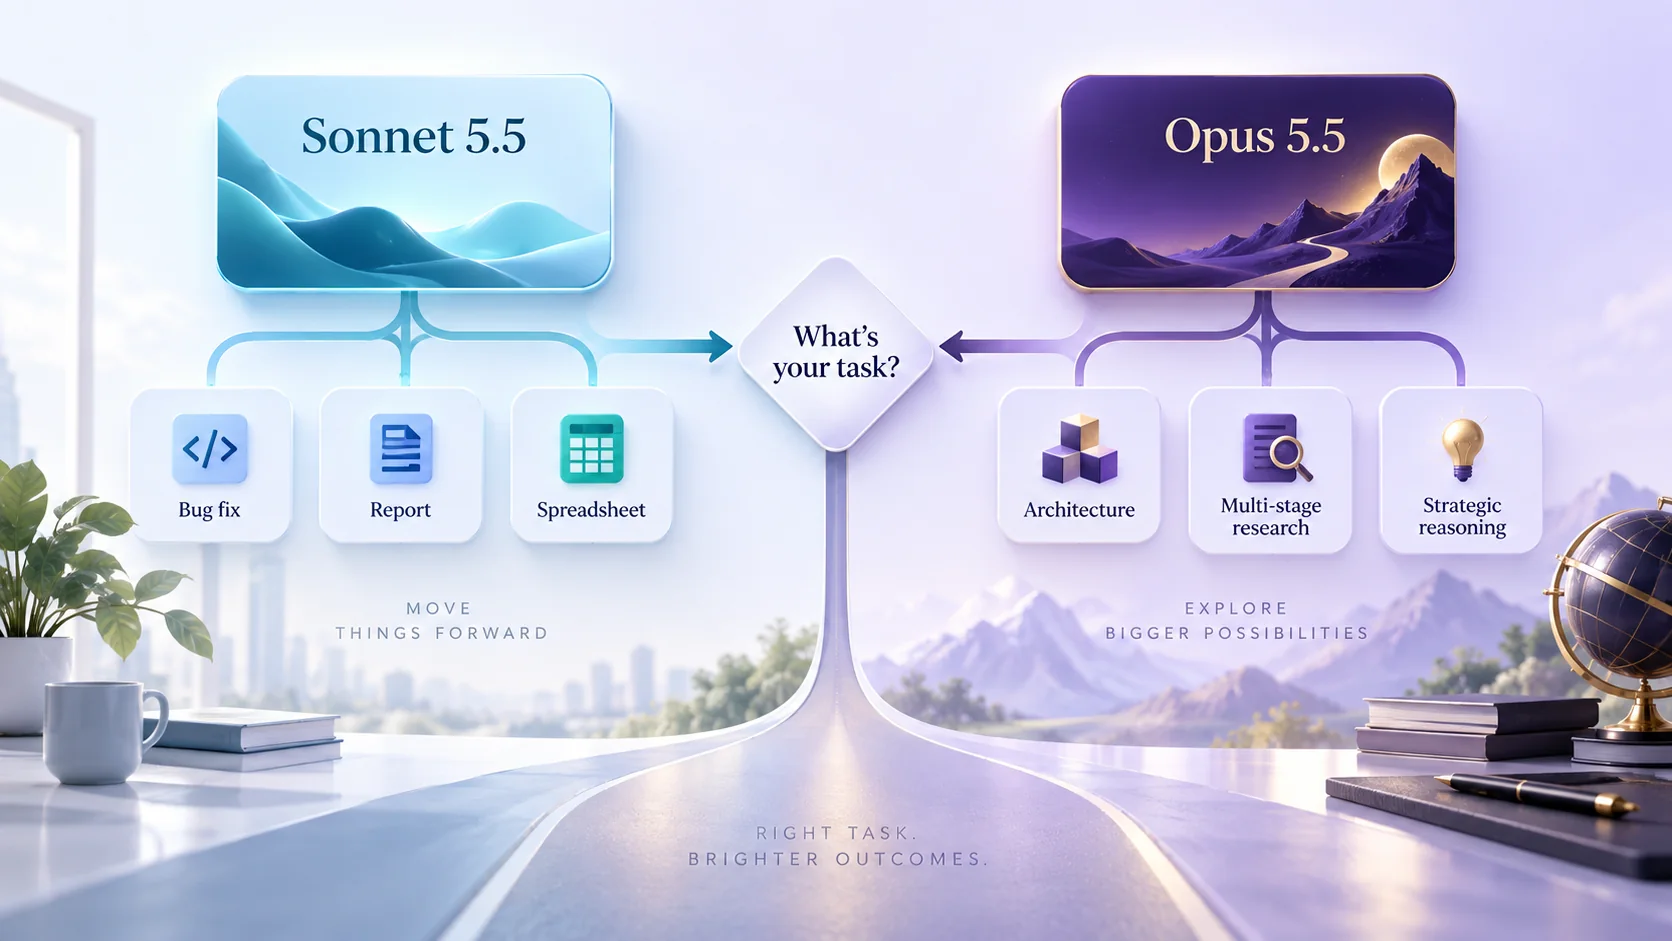
Sonnet tiene sentido cuando el éxito puede describirse de forma clara y verificarse sin una interpretación extensa. Ejemplos incluyen corregir un bug reproducible, transformar un conjunto de datos conocido, resumir una colección definida de documentos, redactar una presentación a partir de hallazgos aprobados o aplicar una reescritura consistente en muchos archivos. Estas tareas pueden seguir siendo exigentes, pero tienen límites y un punto de llegada reconocible.
La diferencia de precio se vuelve importante a volumen. Los tokens estándar de entrada y salida cuestan la mitad que Opus, mientras que las lecturas de caché cuestan lo mismo. Anthropic también indica que Sonnet 5.5 genera salida más de 30% más rápido que Sonnet 5, aunque no presenta esa afirmación como una comparación directa de velocidad con Opus 5.5. Los equipos deberían medir la latencia bajo su propia carga en lugar de asumir que el nombre del nivel predice el tiempo de respuesta en cada entorno.
Para flujos de trabajo recurrentes, el esfuerzo ajustable de Sonnet puede ayudar a controlar el costo. Un esfuerzo menor puede ser adecuado para clasificación, formateo o borradores rutinarios; un esfuerzo mayor podría justificarse para cambios de código o análisis que necesiten más revisión. La práctica clave es definir pruebas de aceptación y escalar los casos difíciles, en lugar de usar el esfuerzo máximo para todo.
Cuándo Opus 5.5 justifica su precio más alto
Opus es el candidato más fuerte cuando el modelo debe definir el problema mientras avanza. Una migración compleja de código, una estrategia entre equipos, una investigación de varias etapas o un análisis ambiguo pueden requerir que el modelo vuelva a revisar suposiciones, equilibre restricciones y mantenga la coherencia a lo largo de una larga cadena de acciones. Estas son las situaciones a las que Anthropic se refiere con “juicio sostenido”.
El cálculo de valor también cambia con el riesgo. Si un revisor senior debe pasar horas reparando una respuesta plausible pero sutilmente incorrecta, el ahorro en tokens fue una economía falsa. Opus podría valer la tarifa más alta cuando una sola ejecución exitosa evita una cantidad significativa de retrabajo, pero aun así debe evaluarse con criterios explícitos; una etiqueta premium no elimina la necesidad de comprobaciones de origen, pruebas y aprobación humana.
Programación: enruta por alcance, no por prestigio
Para programar, empieza por el límite de la tarea. Sonnet es un buen valor predeterminado para un bug localizado, un endpoint bien especificado, generación de pruebas o una refactorización acotada. Opus es más defendible para trabajo arquitectónico, coordinación entre múltiples repositorios, una migración con requisitos incompletos o una investigación en la que se desconoce la causa raíz.
Ejecuta ambos modelos con una muestra representativa antes de formalizar el enrutamiento. Evalúa corrección, riesgo de regresión, ediciones innecesarias, calidad de las pruebas, tiempo transcurrido, uso de tokens y el esfuerzo del revisor. La nota de FrontierCode de Anthropic es relevante aquí: más razonamiento puede llevar a un agente a hacer cambios fuera del alcance solicitado, así que la calidad incluye saber cuándo detenerse.
Trabajo de investigación y documentos
Las puntuaciones de casi Opus de Sonnet en las evaluaciones de trabajo de conocimiento de Anthropic lo convierten en una opción convincente para flujos de trabajo de documentos estructurados. Si el trabajo consiste en comparar cinco informes, extraer campos especificados o convertir notas aprobadas en un esquema de deck, Sonnet puede entregar la calidad requerida a un costo menor. Opus se vuelve más atractivo cuando las fuentes entran en conflicto, la pregunta de investigación evoluciona o el modelo debe hacer y defender elecciones interpretativas difíciles.
Sin importar qué modelo selecciones, la preparación de las fuentes a menudo determina la calidad de la salida. Archivos duplicados, versiones poco claras y falta de contexto pueden socavar incluso a un modelo sólido. El AI Summarizer de iWeaver puede ayudar a organizar archivos y enlaces mezclados en resúmenes, ideas clave, brief ejecutivos o notas estructuradas antes de que comience el análisis de nivel superior. Este es un flujo complementario de información; no implica que ningún modelo de Claude se pueda seleccionar actualmente dentro de iWeaver.
Una regla práctica de enrutamiento
Usa Sonnet primero cuando la tarea tenga entradas claras, una entrega clara y un método de validación directo. Escala a Opus cuando el problema siga siendo ambiguo después de la aclaración, abarque muchas etapas dependientes, tenga un costo alto de error o falle repetidamente tus pruebas de aceptación de Sonnet. Este enfoque suele ofrecer un balance más útil entre costo y calidad que elegir un solo modelo para cada solicitud.
La decisión final debe basarse en la economía de tareas completadas. Haz seguimiento del total de tokens, el uso de caché, los reintentos, la latencia, el tiempo del revisor y la severidad del fallo a lo largo de ejemplos reales. Las mejoras de benchmark de Sonnet 5.5 lo convierten en un valor predeterminado creíble para el día a día; Opus 5.5 sigue siendo la elección deliberada cuando la complejidad y el juicio justifican pagar más. Para explorar el modelo de menor costo en detalle, consulta Claude Sonnet 5.5: Benchmarks, Pricing, Features & What’s New, o continúa con How to Use Claude Sonnet 5.5.