
Gemini 4 Argon es el nuevo modelo insignia de razonamiento de Google, pensado para problemas difíciles que requieren un trabajo sostenido en múltiples pasos. Su lanzamiento importa para las personas que necesitan conciliar documentos en conflicto, investigar un problema técnico o desarrollar un argumento a partir de evidencia. La pregunta útil es si puede completar esas tareas con menos correcciones por parte de quien revisa la respuesta.
Google introdujo inicialmente Argon mediante un despliegue restringido a socios de ciberseguridad de confianza. Google anunció el acceso en la app Gemini para suscriptores de Google AI Pro y Ultra. Los artículos que describían el modelo como disponible solo para los primeros probadores ahora necesitan esa aclaración.
Por qué importa el razonamiento sostenido
Google posiciona Argon para la ingeniería de software compleja, la resolución de problemas científicos y las tareas profesionales prolongadas. Ese posicionamiento sugiere un objetivo de evaluación útil: trabajos en los que un error inicial puede propagarse a través de varias decisiones posteriores. No establece que cada tarea de resumen o escritura mejore, ni que el modelo pueda funcionar sin revisión.
Pensemos en un informe de investigación preparado a partir de tres reportes. Un reporte usa una definición más antigua, otro describe una población diferente y el tercero resume ambos sin explicar la diferencia. Una respuesta útil debería mantener esas fronteras visibles antes de hacer una recomendación. Un párrafo fluido que mezcle los hallazgos fallaría la tarea incluso si suena convincente.
Esta es la oportunidad práctica de los modelos de razonamiento: preservar la estructura de un problema mientras trabajas hacia una respuesta. Para evaluarlo, pide los conflictos, la evidencia de respaldo y la información faltante como salidas separadas. Eso hace que un fallo sea más fácil de identificar que una síntesis única y pulida.
Lo que realmente significan las especificaciones publicadas
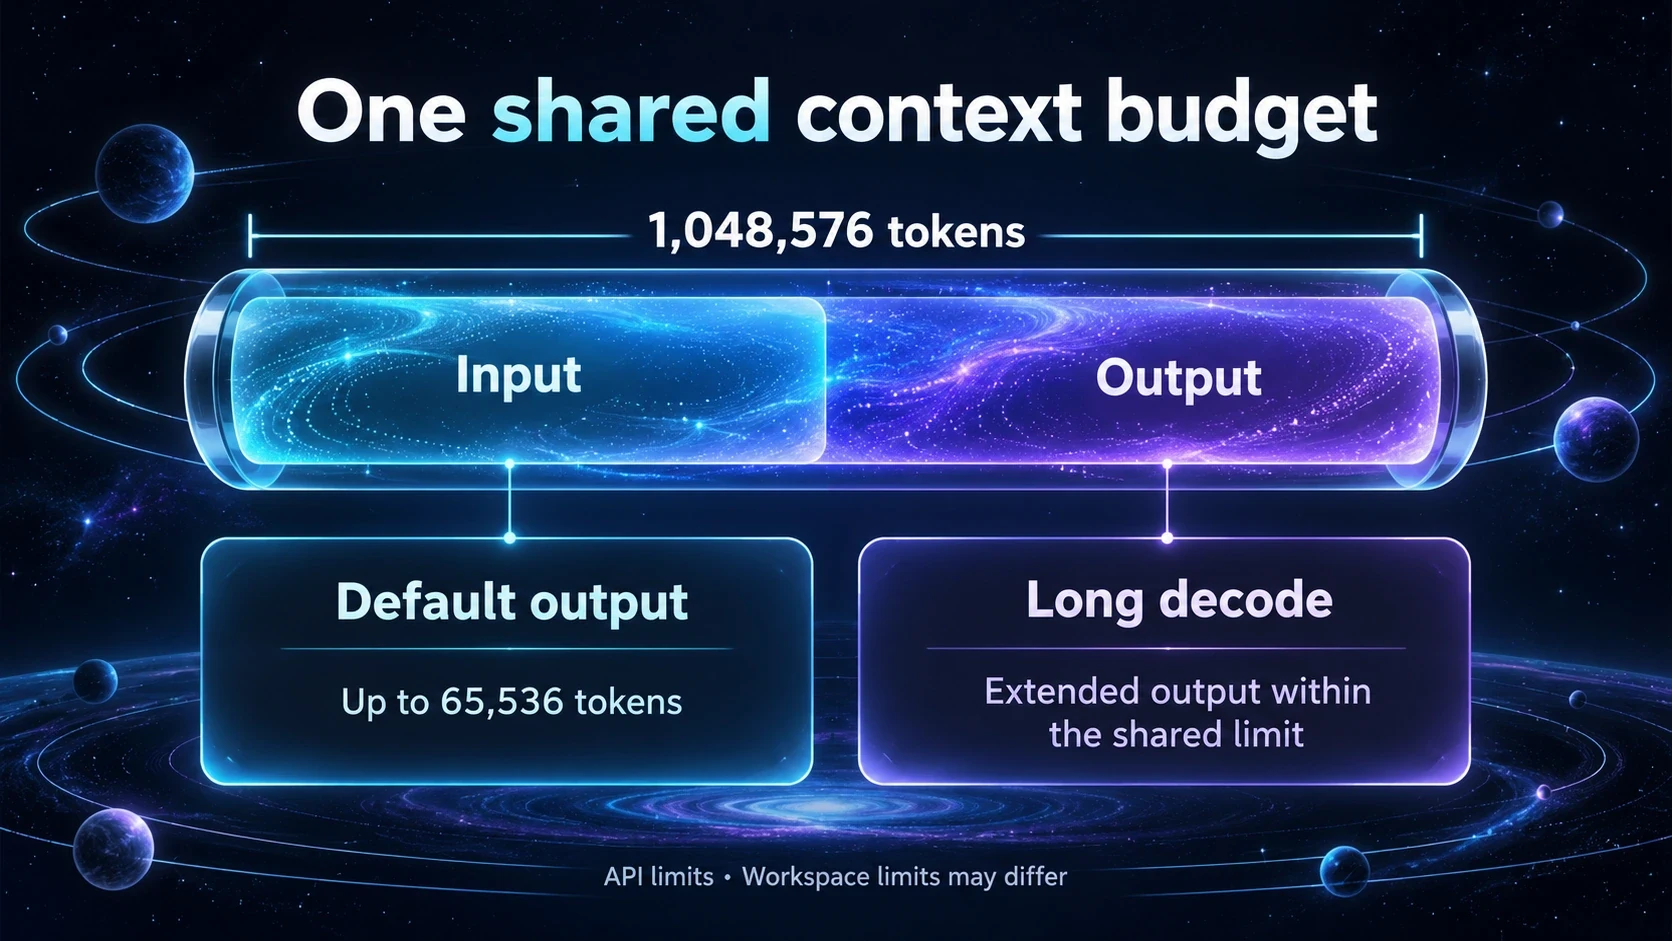
La documentación del modelo Gemini API enumera entradas de texto, imagen, video, audio y PDF, con salida de texto. Describe una ventana unificada de contexto de entrada y salida de 1,048,576 tokens. La salida síncrona predeterminada está limitada a 65,536 tokens; la salida extendida, hasta el límite unificado, requiere una decodificación prolongada.
Se trata de especificaciones de la API. Una app o una interfaz de terceros puede exponer un subconjunto diferente de capacidades, así que el máximo publicado del modelo no debe considerarse una promesa sobre ningún entorno de trabajo en particular. El soporte de entrada tampoco implica generación de imagen o audio: esas capacidades de salida no se enumeran como compatibles para Argon.
Para el trabajo con documentos, la distinción entre capacidad y utilidad importa más que el número destacado. Una ventana más amplia te da espacio para proporcionar material, pero no decide qué versión es la autoritativa. Etiqueta las fuentes, identifica fechas y explica cómo debería manejar la respuesta las contradicciones. Un paquete de fuentes más corto y bien organizado puede hacer que el resultado sea más fácil de auditar.
Tres tareas que vale la pena usar como primera prueba
Conciliar fuentes que discrepan
Dale al modelo un conjunto pequeño de reportes con secciones identificables. Pregunta qué afirmaciones coinciden, cuáles entran en conflicto y cuáles no pueden compararse porque sus definiciones difieren. Exige una referencia de fuente para cada hallazgo y revisa tú mismo algunas referencias. La prueba es si la respuesta conserva distinciones que tú ya sabes que existen.
Explicar un argumento difícil
Elige un fragmento que comprendas lo suficientemente bien como para juzgar. Pide los enunciados (premisas), la conclusión y los supuestos no expresados del argumento, y luego solicita una explicación para un lector menos técnico. Para un flujo de trabajo enfocado en documentos, el PDF Explainer de iWeaver está diseñado para ayudar a desglosar pasajes difíciles en lugar de simplemente acortarlos.
Construir un informe de decisión
Proporciona dos opciones, criterios explícitos y evidencia para cada una. Pide al modelo que recomiende una opción, que indique qué evidencia cambiaría esa recomendación y que señale las preguntas no respondidas. Esto prueba si puede razonar dentro de tus restricciones en lugar de inventar hechos para completar una tabla atractiva.
Si estás decidiendo si cambiar de un flujo de trabajo de Gemini existente, nuestro comparador Gemini 4 Argon vs Gemini 3.8 Flash explica cómo comparar la dificultad de las tareas, las necesidades de salida y el esfuerzo de revisión.
Cómo leer los benchmarks de lanzamiento
El anuncio de Google presenta resultados de benchmarks como evidencia de progreso. Son señales útiles, pero la fuente es el proveedor del modelo y las condiciones de evaluación importan. Este artículo no reporta un benchmark independiente de uso práctico ni afirma que Argon sea el mejor modelo para cada tarea.
Antes de traducir un benchmark en una decisión de compra o de flujo de trabajo, identifica la tarea, la configuración de la herramienta y los criterios de éxito. Luego compáralos con tu trabajo. Un benchmark de código no puede establecer la precisión de una revisión de literatura; una respuesta larga no puede establecer que sus referencias sean correctas.
Lleva el modelo a un flujo de trabajo repetible
Gemini 4 Argon ya está disponible en iWeaver, y iWeaver ofrece una prueba gratuita del modelo. Selecciónalo en el entorno de trabajo y usa una tarea real con un estándar de aceptación claro. Sigue nuestra guía para usar Gemini 4 Argon para un flujo de trabajo basado en fuentes y un prompt que puedas adaptar.
El mejor primer uso es una tarea basada en fuentes que puedas verificar. Prepara la evidencia, define la salida deseada, revisa el resultado y conserva las correcciones para la siguiente ejecución. El lanzamiento de Argon te da un nuevo candidato para trabajos difíciles. La decisión de seguir usándolo debería depender de lo que logre bien en ese flujo de trabajo.