
Grok 4.7 ya está disponible oficialmente. Publicado el 21 de septiembre de 2026, Grok 4.7 es el modelo de frontera más reciente de xAI para la programación, tareas agentic y el trabajo profesional basado en conocimiento.
Esto es más que una simple actualización menor de Grok 4.6. xAI afirma que Grok 4.7 usa un nuevo modelo base, más grande, un periodo de refuerzo por aprendizaje más largo y un entrenamiento que pone más peso en tareas difíciles que pueden tardar horas en completarse. También mejora la auto-verificación y la gestión de contexto largo—dos áreas que importan mucho más en flujos de trabajo reales que solo responder prompts cortos. Y a diferencia de las primeras especulaciones sobre Grok 4.7, ahora contamos con especificaciones y resultados de benchmark oficiales con los que comparar.
Fecha de lanzamiento de Grok 4.7
Grok 4.7 se lanzó oficialmente. Está disponible a través de la API de xAI como: grok-4.7
En el lanzamiento, xAI también puso el modelo a disposición a través de varias plataformas de código e IA, incluyendo Grok Build y Cursor. GitHub también ha comenzado a implementar Grok 4.7 entre los usuarios de GitHub Copilot.
Para más contexto sobre la generación anterior, también puedes consultar nuestra reseña de Grok 4.6.
Especificaciones de Grok 4.7 de un vistazo
Estas son las principales especificaciones oficiales.
| Especificación | Grok 4.7 |
|---|---|
| Fecha de lanzamiento | 21 de septiembre de 2026 |
| Nombre del modelo | grok-4.7 |
| Ventana de contexto | 500.000 tokens |
| Corte de conocimiento | Mayo de 2026 |
| Modalidades de entrada | Texto e imagen |
| Modalidad de salida | Texto |
| Límite de salida de texto | Sin límite fijo de salida de texto |
| Niveles de razonamiento | Bajo, Medio, Alto, XAlto |
| Razonamiento predeterminado | Alto |
| Llamadas a funciones | Compatible |
| Búsqueda web | Compatible |
| Búsqueda X | Compatible |
| Ejecución de código | Compatible |
| Soporte de API | Responses API, Chat Completions |
La ventana de contexto de 500K es especialmente útil para documentos largos, bases de código grandes, proyectos de varios archivos, tareas de investigación y flujos de trabajo agentic que necesitan mantener mucha información a lo largo del tiempo.
Grok 4.7 también admite cuatro niveles de razonamiento:
- Bajo
- Medio
- Alto
- XAlto
Esto permite a los desarrolladores ajustar la velocidad y la profundidad del razonamiento según la tarea.
¿Qué hay de nuevo en Grok 4.7?
Los cambios más importantes no son llamativas nuevas funciones de interfaz.
Son mejoras en la forma en que el modelo gestiona el trabajo más largo y más difícil.
1. Un nuevo modelo base, más grande
Grok 4.7 se construye sobre un nuevo y más grande modelo base en comparación con Grok 4.6.
Esto importa porque no se trata simplemente de Grok 4.6 con post-entrenamiento adicional.
El modelo subyacente en sí ha cambiado.
xAI lo entrenó después con un periodo de refuerzo por aprendizaje más largo sobre una mezcla más exigente de tareas, dando más énfasis a problemas que pueden tardar muchas horas en completarse.
El objetivo está claro:
hacer que Grok sea mejor terminando el trabajo difícil, no solo empezándolo bien.
2. Mejor rendimiento en tareas de larga duración
Muchos modelos de IA se ven impresionantes en prompts cortos, pero se vuelven menos fiables a medida que la tarea se alarga.
Eso puede manifestarse como:
- instrucciones olvidadas
- decisiones inconsistentes
- trabajo repetido
- dependencias omitidas
- errores que nunca se verifican
- un mal uso del contexto anterior
Grok 4.7 está entrenado específicamente para rendir mejor en tareas de ejecución más prolongada.
Esto es especialmente relevante para agentes de programación, flujos de trabajo de investigación, creación de documentos y trabajo profesional que involucra múltiples etapas.
3. Mejor auto-verificación
Otro cambio importante es una auto-revisión más sólida.
En lugar de limitarse a generar una respuesta y seguir adelante, Grok 4.7 está diseñado para verificar su propio trabajo con más cuidado.
Esto importa en tareas como:
- depurar código
- editar proyectos grandes
- revisar cálculos
- revisar documentos
- seguir instrucciones largas
- usar varias herramientas en secuencia
Por supuesto, la auto-verificación no significa que el modelo no pueda cometer errores.
La revisión humana sigue siendo importante para trabajos de alto riesgo.
Pero una mejor comprobación interna puede reducir fallos evidentes durante flujos de trabajo largos.
4. Agente y trabajo con conocimiento, más potentes
Grok 4.7 también se entrenó para entender mejor el arnés del Grok Bot de xAI.
Eso hace que el modelo sea especialmente relevante para tareas de estilo agentic en las que la IA necesita hacer más que responder una sola pregunta.
Por ejemplo:
- inspeccionar archivos
- buscar información
- escribir código
- ejecutar herramientas
- revisar resultados
- revisar y corregir su propio trabajo
- continuar hasta que se complete una tarea más grande
Esto refleja un cambio más amplio en la IA de frontera.
La pregunta clave ya no es solo:
¿Puede el modelo responder esta pregunta?
Ahora es cada vez más:
¿Puede el modelo completar la tarea completa?
Benchmarks de Grok 4.7
xAI publicó resultados de benchmark que comparan Grok 4.7 con Grok 4.6 y otros modelos de frontera.
Los resultados muestran mejoras especialmente notables en programación, tareas basadas en terminal, ingeniería y trabajo profesional basado en conocimiento.
Para la comparación más limpia, la tabla siguiente se centra en Grok 4.7 frente a Grok 4.6.
| Benchmark | Grok 4.7 | Grok 4.6 | Cambio |
|---|---|---|---|
| CursorBench 4.0 | 46,3% | 40,4% | +5,9 pts |
| DeepSWE v1.1 | 71,0% | 65,2% | +5,8 pts |
| AA Briefcase v1.1 | 1.657 | 1.546 | +111 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | +17,7 pts |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | +3,8 pts |
| HealthBench Professional | 56,7% | 48,5% | +8,2 pts |
| EEBench | 64,0% | 53,0% | +11,0 pts |
El mayor salto de este conjunto aparece en Terminal-Bench 4.0, donde Grok 4.7 obtiene 38,0% frente a 20,3% de Grok 4.6.
Esto es especialmente relevante para flujos de trabajo de programación agentic que involucran comandos de terminal, herramientas, repositorios y ejecución en múltiples pasos.
Grok 4.7 también muestra mejoras notables en benchmarks de ingeniería eléctrica, trabajo profesional basado en conocimiento, ingeniería de software y razonamiento clínico.
Grok 4.7 frente a Grok 4.6
Los números de benchmark hacen más fácil ver el cambio generacional.
| Grok 4.6 | Grok 4.7 | |
|---|---|---|
| Estado | Generación anterior | Generación más reciente |
| Modelo base | Modelo anterior | Nuevo modelo base, más grande |
| Ventana de contexto | — | 500K tokens |
| Tareas de larga duración | Sólido | Mejorado |
| Auto-verificación | Sólido | Mejorado |
| CursorBench 4.0 | 40,4% | 46,3% |
| DeepSWE v1.1 | 65,2% | 71,0% |
| Terminal-Bench 4.0 | 20,3% | 38,0% |
| EEBench | 53,0% | 64,0% |
| Precio de entrada de la API | $2 / 1M tokens | Empieza en $2 / 1M tokens |
| Precio de salida de la API | $6 / 1M tokens | Empieza en $6 / 1M tokens |
Por lo tanto, la razón más grande para pasar de Grok 4.6 a Grok 4.7 no es una sola función destacada.
Es la combinación de:
mejor programación + mejor rendimiento en tareas de larga duración + mejor gestión del contexto + mejor auto-revisión.
Si tu carga de trabajo se compone principalmente de preguntas cotidianas y cortas, la diferencia puede sentirse menor.
Para desarrolladores y usuarios que ejecutan flujos de trabajo largos en múltiples pasos, la mejora es más significativa.
Precios de Grok 4.7
Grok 4.7 parte de:
- $2 por 1 millón de tokens de entrada
- $0,50 por 1 millón de tokens de entrada en caché
- $6 por 1 millón de tokens de salida
Estos precios se aplican cuando el prompt es inferior a 200K tokens.
Para prompts por encima de 200K tokens, el precio oficial de la API aumenta a:
- $4 por 1 millón de tokens de entrada
- $1 por 1 millón de tokens de entrada en caché
- $12 por 1 millón de tokens de salida
Vale la pena tener en cuenta estos precios por niveles porque Grok 4.7 tiene una ventana de contexto de 500K.
Usar toda la ventana de contexto puede, por lo tanto, costar más que solicitudes más cortas.
¿Qué es Grok 4.7 Fast?
xAI también ofrece Grok 4.7 Fast.
Se trata del mismo modelo subyacente, servido en infraestructura más rápida.
Según xAI, ofrece alrededor del doble de velocidad de salida con el doble de las tarifas estándar por token.
Sin embargo, hay una diferencia importante de disponibilidad:
Grok 4.7 Fast actualmente está disponible a través de Cursor y Grok Build, pero no a través de la API pública de xAI.
Eso hace que el modelo estándar de Grok 4.7 sea la opción principal para desarrolladores que construyen directamente con la API de xAI.
¿Dónde puedes usar Grok 4.7?
Grok 4.7 ya está disponible en varias plataformas.
API de xAI
Los desarrolladores pueden usar:
grok-4.7
a través de la API de Responses de xAI o la API de Chat Completions.
Admite herramientas, incluyendo:
- llamadas a funciones
- búsqueda web
- búsqueda X
- ejecución de código
Grok Build
Grok 4.7 es el modelo predeterminado para Grok Build, el agente de xAI para programación y creación de aplicaciones.
Cursor
Grok 4.7 está disponible en Cursor.
Allí también está disponible la variante Fast.
Model Gateways
La documentación de xAI lista la disponibilidad a través de plataformas incluyendo:
- OpenRouter
- Vercel
- Cloudflare
GitHub Copilot
GitHub comenzó a implementar Grok 4.7 para GitHub Copilot el 21 de septiembre.
Se está poniendo a disposición en los planes Copilot Pro, Pro+, Max, Business y Enterprise.
Los entornos compatibles incluyen:
- Visual Studio Code
- Visual Studio
- Copilot CLI
- agente en la nube de GitHub Copilot
- app de GitHub Copilot
- JetBrains
- Xcode
- Eclipse
El despliegue es gradual, así que algunos usuarios podrían no verlo de inmediato.
No juzgues Grok 4.7 por un solo benchmark
Los resultados oficiales son útiles, pero una tabla de benchmark no debería ser la razón final para elegir un modelo.
Los distintos benchmarks evalúan cosas distintas.
Un modelo que rinde bien en un benchmark de programación no necesariamente es la mejor opción para:
- investigación
- análisis de documentos
- escritura
- atención al cliente
- extracción de datos
- resúmenes
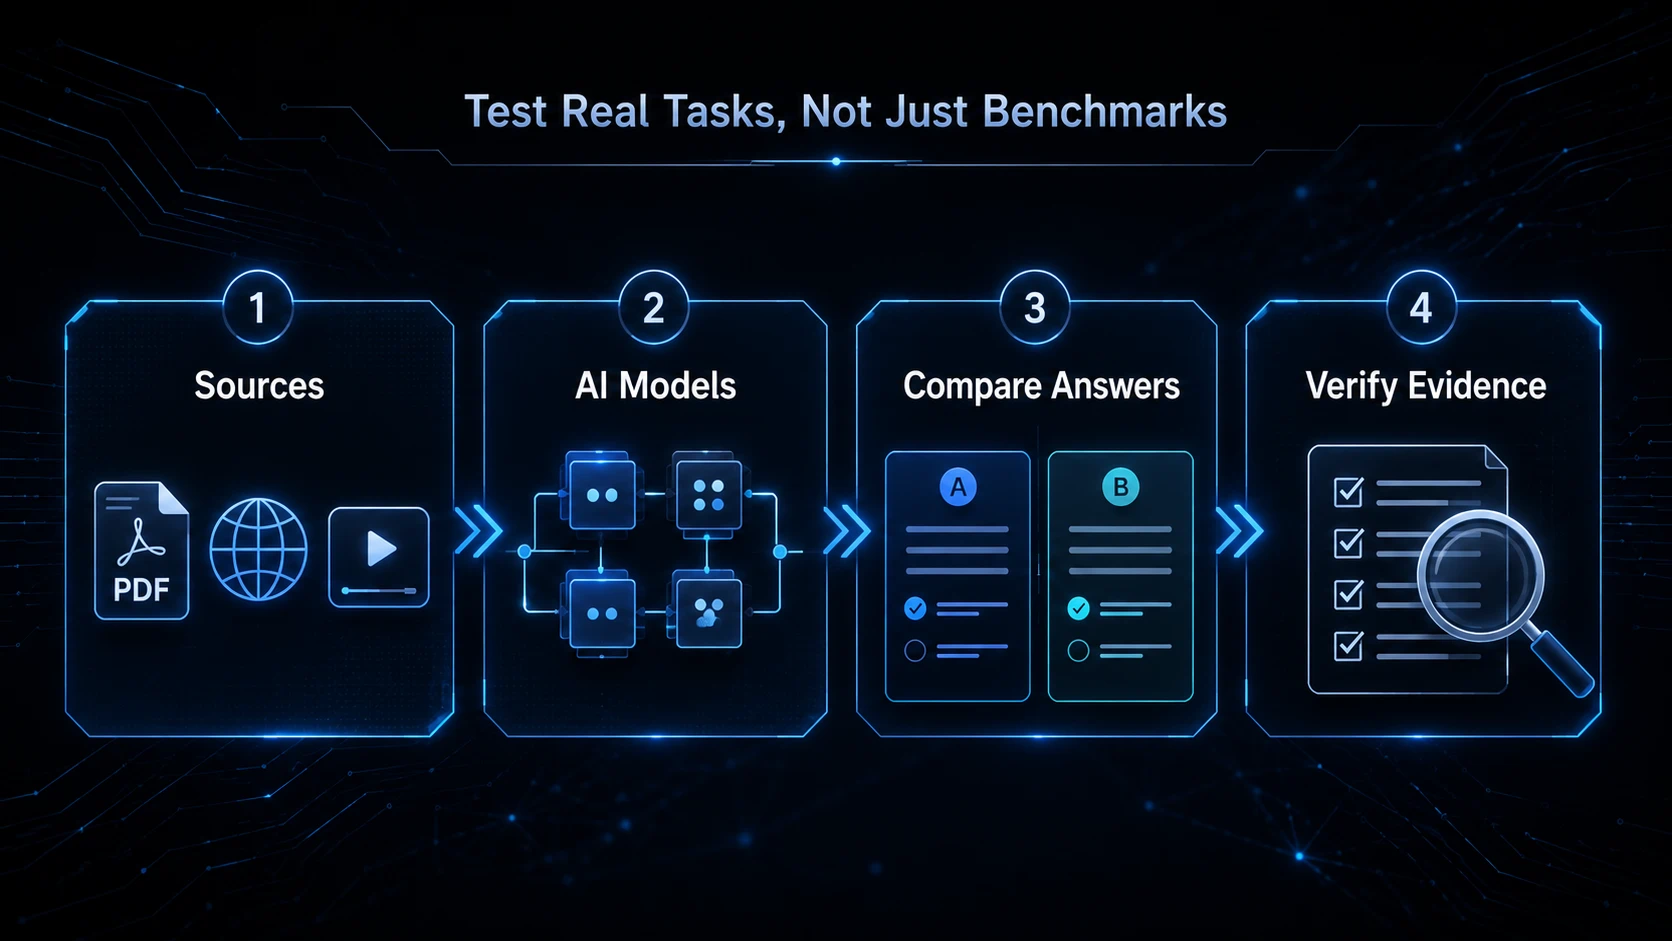
Una prueba mejor es comparar modelos usando la misma tarea real.
Por ejemplo:
- Dale a cada modelo la misma pregunta.
- Proporciona los mismos archivos fuente.
- Usa las mismas instrucciones.
- Compara las respuestas finales.
- Revisa la información faltante y los errores factuales.
- Verifica las conclusiones importantes frente a las fuentes originales.
Si tu trabajo implica PDFs, sitios web, videos, presentaciones o documentos de investigación, herramientas como iWeaver pueden ayudarte a organizar esos materiales en un solo lugar antes de comparar las salidas del modelo.
Esto facilita evaluar si un modelo de IA es realmente útil para tu flujo de trabajo en lugar de simplemente ser mejor en un ranking.
¿Vale la pena usar Grok 4.7?
Para programación y flujos de trabajo agentic, Grok 4.7 es una actualización significativa sobre Grok 4.6.
Los datos oficiales de benchmark muestran mejoras en ingeniería de software, trabajo en terminal, tareas profesionales, ingeniería eléctrica, tareas legales y benchmarks de razonamiento clínico.
La combinación de una ventana de contexto de 500K, mejor rendimiento en tareas de larga duración, auto-verificación mejorada, soporte de herramientas y precios iniciales de API sin cambios también hace que el modelo sea más práctico para flujos de trabajo más grandes.
Eso no significa que Grok 4.7 vaya a ser el mejor modelo para cada tarea.
Los modelos distintos siguen teniendo fortalezas diferentes, y los resultados de benchmark no siempre se traducen de forma directa en mejores salidas en el mundo real.
Pero Grok 4.7 ofrece a desarrolladores y usuarios profesionales una opción más sólida que Grok 4.6—especialmente cuando una tarea involucra muchos pasos, grandes cantidades de contexto o un uso prolongado de herramientas.
Grok 4.7 no es solo otra actualización pequeña de Grok.
Usa un nuevo modelo base, más grande, y pone mucho más énfasis en la programación de larga duración, el trabajo agentic, la auto-verificación y las tareas de conocimiento profesional.
En comparación con Grok 4.6, las cifras oficiales muestran mejoras claras en varios benchmarks exigentes, mientras que el precio inicial de la API permanece sin cambios.
La pregunta más interesante ahora no es si Grok 4.7 rinde mejor que Grok 4.6 en el papel.
Es cuánto de esa mejora se traslada a proyectos reales.
Para desarrolladores, investigadores y usuarios que construyen flujos de trabajo de IA más largos, ahí es donde finalmente se probará Grok 4.7.